Gemini 4 Hydrogen é um modelo barato? Comparação de custo com Claude Haiku 5.5 e GPT-6 Luna
O token do Hydrogen custa 15 vezes o do Haiku 5.5 e do Luna. Comparamos preços oficiais, o custo por tarefa da Artificial Analysis e um teste de triagem com 24 chamadas para mostrar quando o custo extra compensa.
 Ofox
Não. O Gemini 4 Hydrogen é o modelo de uso geral de preço intermediário do Google, não a opção econômica da linha. Nas tarifas pagas Standard do Google, ele custa US$ 1,50 por milhão de tokens de entrada e US$ 7,50 por milhão de tokens de saída, 15 vezes as tarifas de prompt curto do Claude Haiku 5.5 e do GPT-6 Luna (US$ 0,10 e US$ 0,50 cada). Por tarefa concluída, a diferença pode ser ainda maior, porque o Hydrogen raciocina em high por padrão e gasta mais tokens de saída no mesmo trabalho. O próprio guia do Google indica o Gemini 3.5 Flash-Lite, e não o Hydrogen, para classificação e roteamento em grande volume.
Isso não faz do Hydrogen uma má escolha. No Intelligence Index da Artificial Analysis, ele marca cerca de o dobro do Haiku 5.5 e do Luna nas configurações padrão. Mas, numa tarefa de triagem simples e bem especificada, essa capacidade extra não fez diferença: no nosso teste, o Haiku e o Luna foram igualmente precisos e custaram muito menos.
Este artigo é publicado pela Ofox, e os quatro modelos citados podiam ser chamados pela Ofox quando verificamos em 19 de novembro de 2026. Tudo abaixo está identificado como uma de três coisas: documentação oficial (verificada em 19 de novembro de 2026), dados da Artificial Analysis (coletados em 19 de novembro de 2026) ou nosso próprio teste pequeno pela Ofox na mesma data. Os valores em dólar do teste são cálculos nossos com os preços de tabela oficiais de cada fornecedor, não cobrança da Ofox. Os preços da própria Ofox aparecem em cada página de modelo indicada no final.
Preços oficiais de tabela na mesma base
Todos os valores em dólares americanos por um milhão de tokens, nível pago Standard, API do próprio fornecedor. Nos quatro modelos, o preço de saída inclui os tokens de raciocínio.
| Modelo (ID da API) | Entrada | Saída | Entrada em cache | Condição de preço | Batch entrada / saída |
|---|---|---|---|---|---|
Gemini 4 Hydrogen (gemini-4-hydrogen) | US$ 1,50 | US$ 7,50 | US$ 0,075 (só implícito) | Uma tarifa para qualquer tamanho de prompt | US$ 0,75 / US$ 3,75 |
Claude Haiku 5.5 (claude-haiku-5-5) | US$ 0,10 | US$ 0,50 | leitura US$ 0,01; gravação de 5 min US$ 0,125 | Prompt ≤100.000 tokens | US$ 0,05 / US$ 0,25 |
| Claude Haiku 5.5, prompt >100K | US$ 0,50 | US$ 2,50 | leitura US$ 0,05; gravação de 5 min US$ 0,625 | Vale para a requisição inteira | US$ 0,25 / US$ 1,25 |
GPT-6 Luna (gpt-6-luna) | US$ 0,10 | US$ 0,50 | US$ 0,01 | Entrada ≤272K tokens | US$ 0,05 / US$ 0,25 |
| GPT-6 Luna, entrada >272K | US$ 0,20 | US$ 0,75 | US$ 0,02 | Vale para a requisição inteira | US$ 0,10 / US$ 0,375 |
Gemini 3.5 Flash-Lite (gemini-3.5-flash-lite) | US$ 0,30 | US$ 2,50 | US$ 0,03 + armazenamento de US$ 1,00 por 1 mi de tokens/hora | Tarifa única | US$ 0,15 / US$ 1,25 |
Fontes: preços da API Gemini do Google (em inglês), preços da Anthropic (em inglês), preços da OpenAI (em inglês) e a página do modelo GPT-6 Luna (em inglês).
Três detalhes mudam a comparação mais do que a proporção que aparece na manchete.
O preço baixo do Haiku 5.5 tem um teto. A Anthropic cobra o Haiku 5.5 pelo tamanho do prompt. Uma requisição com prompt acima de 100.000 tokens paga cinco vezes as tarifas básicas, e isso vale para a requisição inteira, incluindo a saída. Leituras e gravações de cache contam para os 100K. Acima dessa linha, o Hydrogen custa só três vezes o Haiku, e não quinze. Nosso guia de preço do Haiku 5.5 no limite de 100K (em inglês) faz as contas desse limite com números exatos. O Luna tem um degrau parecido em 272K tokens de entrada. A tabela do Hydrogen não lista faixa para contexto longo.
O Hydrogen tem um nível gratuito. As páginas de preço da Anthropic e da OpenAI listam só tarifas pagas para o Haiku 5.5 e o Luna. O Google lista o Hydrogen e o 3.5 Flash-Lite como gratuitos no nível gratuito, o que ajuda em protótipos. A tabela do Google também informa que o conteúdo do nível gratuito é usado para melhorar seus produtos, e o acesso depende da elegibilidade e dos limites do projeto. Nosso guia de configuração do Hydrogen explica a verificação e a cota.
O Flash-Lite é mais barato que o Hydrogen, mas não que o Haiku ou o Luna. A tarifa de entrada dele é três vezes a desses dois, e a de saída, cinco vezes. Dentro da linha do Google, é a opção de baixo custo; comparado aos outros fornecedores, não é o mais barato.
Quanto uma tarefa custa de fato: dados da Artificial Analysis
O preço por token não mostra quantos tokens cada modelo usa. A Artificial Analysis (AA, em inglês) roda as avaliações do seu Intelligence Index em cada modelo e informa um custo médio ponderado por tarefa, calculado a partir dos tokens que cada modelo realmente usou e dos preços desse modelo. Coletamos as páginas dos quatro modelos em 19 de novembro de 2026. A primeira tabela usa a configuração padrão documentada por cada fornecedor: raciocínio high no Hydrogen (guia do Hydrogen do Google, em inglês), esforço medium no Haiku 5.5 (visão geral de modelos da Anthropic, em inglês) e medium no Luna (página do modelo na OpenAI).
As páginas renderizadas da AA mostram o custo por tarefa apenas para a configuração mais alta de cada modelo. Os custos por tarefa das outras configurações vêm dos dados por trás dessas mesmas páginas, onde cada custo traz a etiqueta da sua variante (por exemplo, claude-haiku-5-5-medium ou gemini-4-hydrogen-high). Por isso, os rótulos de esforço abaixo são da própria AA, e não uma correspondência feita por nós. As pontuações do índice de cada rótulo coincidem com as páginas renderizadas.
| Modelo na configuração padrão | AA Intelligence Index | Custo AA por tarefa do Index | Velocidade de saída AA |
|---|---|---|---|
| Gemini 4 Hydrogen (high) | 51 | US$ 1,87 | 165 tokens/s |
| Claude Haiku 5.5 (medium) | 25 | US$ 0,092 | 222 tokens/s |
| GPT-6 Luna (medium) | 18 | US$ 0,042 | 96 tokens/s |
| Gemini 3.5 Flash-Lite (só uma variante listada) | 12 | US$ 0,69 | 318 tokens/s |
Nas configurações padrão, o Hydrogen custa cerca de 20 vezes o Haiku por tarefa da AA e cerca de 44 vezes o Luna. As duas diferenças são maiores que a razão de 15x no preço do token, porque o Hydrogen em high gera mais tokens por tarefa. A diferença de capacidade vai na mesma direção: a pontuação do Hydrogen é cerca do dobro da do Haiku e perto do triplo da do Luna.
O quadro muda quando se aumenta o esforço dos modelos mais baratos:
| Configuração mais alta listada | AA Intelligence Index | Custo AA por tarefa do Index |
|---|---|---|
| Gemini 4 Hydrogen (xhigh) | 54 | US$ 3,16 |
| Claude Haiku 5.5 (max) | 36 | US$ 0,41 |
| GPT-6 Luna (max) | 28 | US$ 0,15 |
Nas configurações mais altas, a diferença para o Haiku cai para cerca de 7,7x, porque o Haiku em max usa muito mais tokens. O Luna continua cerca de 21 vezes mais barato. Mesmo em max, porém, nenhum dos dois alcança a pontuação do Hydrogen em medium (41 na página da AA). Nos dados da página da AA, o Hydrogen em medium custa US$ 0,80 por tarefa: cerca do dobro do Haiku em max (US$ 0,41), com pontuação 5 pontos maior. Se a sua carga de trabalho se parece com as tarefas difíceis de raciocínio e de agentes da AA, o Hydrogen numa configuração mais baixa pode sair melhor do que um modelo pequeno levado ao limite.
Leia esses números com os limites em mente:
- O índice da AA é um conjunto de avaliações difíceis. Uma pontuação de 25 não significa que o Haiku falhe em três quartos dos seus jobs de extração. Nosso teste abaixo mostra que o Haiku e o Luna acertaram tudo numa tarefa simples, guiada por regras.
- Os números de velocidade da AA são medições dela. O tempo até o primeiro token de resposta do Hydrogen em
highaparece como 19,4 segundos, contra 9,1 do Haiku emmediume 5,3 do Luna emmedium. Isso inclui o tempo de raciocínio. - O custo por tarefa do Flash-Lite na AA (US$ 0,69) não é um número justo “por requisição”. No próprio detalhamento da AA, a maior parte desse valor é custo de entrada ligado a cache, não saída. Numa requisição curta e avulsa, o Flash-Lite nos custou menos que o Hydrogen, como mostra o teste.
Nosso teste: 20 itens de triagem e 3 itens curtos de raciocínio
Queríamos ver o que esses números significam no trabalho para o qual as pessoas de fato compram modelos baratos: muitos itens curtos, uma folha de regras fixa, uma resposta em JSON. Em 19 de novembro de 2026, rodamos os mesmos prompts pelo endpoint compatível com OpenAI da Ofox (https://api.ofox.io/v1/chat/completions) com estes IDs de modelo exatos: google/gemini-4-hydrogen, anthropic/claude-haiku-5.5, openai/gpt-6-luna e google/gemini-3.5-flash-lite.
Configuração. Configurações padrão dos modelos: sem temperature, sem parâmetro de raciocínio. O único parâmetro definido foi max_tokens: 32000, como teto de gasto, e nenhuma resposta chegou a ele (todo finish_reason foi stop).
Carga A, triagem. Uma requisição com 20 mensagens de suporte ao cliente. Para cada mensagem, o modelo devolve category (cinco classes), order_id (o primeiro ORD- válido seguido de seis dígitos, em maiúsculas, ou null) e refund (true só quando há pedido explícito de dinheiro de volta). Escrevemos o gabarito antes de chamar qualquer modelo. Vários itens são propositalmente traiçoeiros: um ID de pedido de cinco dígitos que deve ser rejeitado, um número de telefone e um número de chamado como distratores, um “não estou pedindo reembolso” explícito, uma mensagem em espanhol, sarcasmo, uma página de erro que aparece na tela de cobrança mas é um bug, e mensagens com dois problemas em que o primeiro decide. Cada modelo rodou essa requisição duas vezes.
Carga B, raciocínio. Três prompts separados, cada um com uma única resposta verificável: um cálculo de custo de novas tentativas (resposta: $3.8064), dois prazos de SLA em horário comercial (segunda 13:00; terça 17:00) e três decisões de política de reembolso que exigem contar dias (sim, não, sim). Uma execução de cada.
Os prompts completos, a folha de regras, o gabarito, o script de execução e o de pontuação estão linkados na seção de reprodução, mais abaixo.
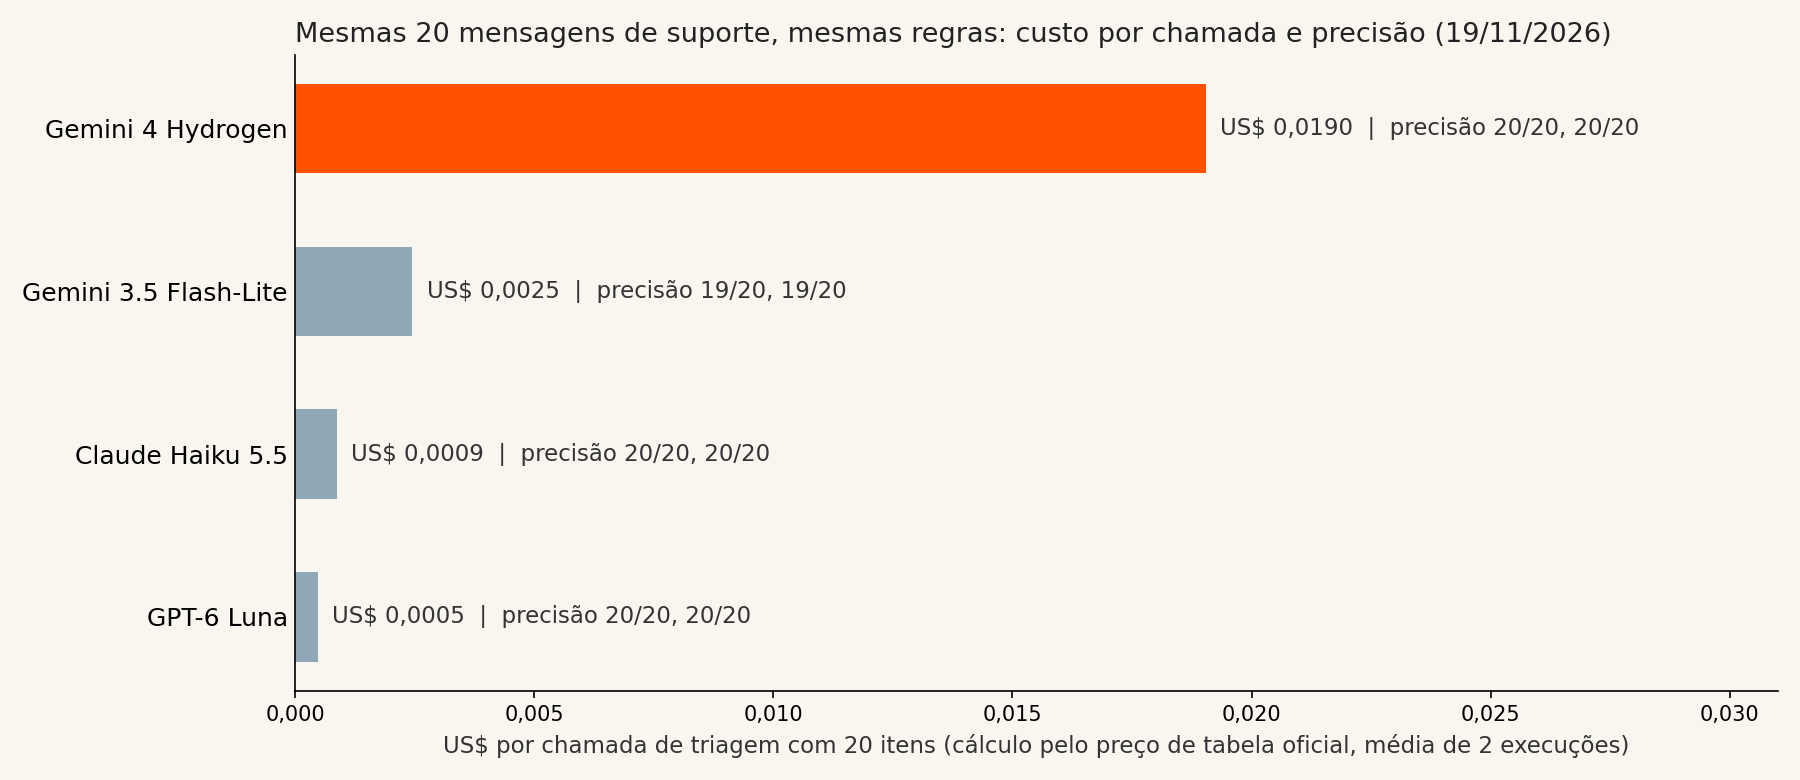
Gráfico com dados das nossas execuções de 19 de novembro de 2026: média de duas chamadas de triagem por modelo, com os preços de tabela oficiais do próprio fornecedor. Não é cobrança da Ofox.
Resultados de precisão e custo
| Modelo | Precisão na triagem (2 execuções) | Itens de raciocínio | Latência média da triagem | Média de tokens de saída por chamada de triagem (raciocínio) | Custo por chamada de triagem | Mesma tarifa por 1.000 mensagens |
|---|---|---|---|---|---|---|
| Gemini 4 Hydrogen | 20/20, 20/20 | 3/3 | 16,1 s | 2.336 (≈1.698) | US$ 0,0190 | ≈US$ 0,95 |
| Claude Haiku 5.5 | 20/20, 20/20 | 3/3 | 7,8 s | 1.476 (≈831) | US$ 0,00086 | ≈US$ 0,043 |
| GPT-6 Luna | 20/20, 20/20 | 3/3 | 8,3 s | 780 (≈239) | US$ 0,00048 | ≈US$ 0,024 |
| Gemini 3.5 Flash-Lite | 19/20, 19/20 (59/60 campos cada) | 2/3 | 3,6 s | 861 (nenhum informado) | US$ 0,00245 | ≈US$ 0,12 |
O custo é uma conta com o preço de tabela oficial: os tokens de entrada e de saída informados em cada resposta, multiplicados pelas tarifas Standard do próprio fornecedor na primeira tabela. O Haiku e o Luna foram cobrados nas faixas mais baixas, já que todos os prompts ficaram muito abaixo de 100K tokens. A latência é o tempo real do nosso cliente, passando pela Ofox, até uma resposta completa sem streaming, incluindo o tempo de rede. Não é o tempo até o primeiro token. A coluna “por 1.000 mensagens” apenas multiplica por 50 o custo medido do lote, supondo o mesmo formato de prompt e nenhuma nova tentativa.
Somando as cinco chamadas de cada modelo, os totais foram US$ 0,0578 para o Hydrogen, US$ 0,0024 para o Haiku, US$ 0,0012 para o Luna e US$ 0,0071 para o Flash-Lite. Nessa carga, o Hydrogen custou cerca de 24 vezes o Haiku e 46 vezes o Luna. O prêmio de 15x no preço do token aumentou porque ele gerou mais tokens de saída, principalmente de raciocínio, para as mesmas respostas.
O que as execuções mostraram:
- A capacidade extra do Hydrogen não mudou o resultado. Hydrogen, Haiku e Luna acertaram todos os campos nas duas execuções de triagem e os três itens de raciocínio. Num trabalho bem especificado, com uma folha de regras clara, os modelos mais baratos bastaram.
- O Luna foi o mais eficiente em tokens. Ele informou cerca de 240 tokens de raciocínio por chamada de triagem, contra cerca de 1.700 do Hydrogen e 830 do Haiku. Como os tokenizadores são diferentes, as contagens não são perfeitamente comparáveis entre fornecedores, mas a diferença de custo vem dessas contagens.
- O Flash-Lite foi o mais rápido e errou duas vezes. Nas duas execuções de triagem, ele devolveu
ORD-77812para o item 7, um ID de cinco dígitos que as regras mandam rejeitar. No item de política de reembolso, contou de 10 de outubro a 15 de novembro como 21 dias em vez de 36 e aprovou um reembolso que a regra de 30 dias deveria bloquear. O Flash-Lite não informou tokens de raciocínio. O guia de raciocínio do Gemini da Ofox observa que a série Flash-Lite não raciocina por padrão. - Uma chamada do Haiku foi lenta. O prompt de custo de novas tentativas levou 18,8 segundos; as outras duas chamadas de raciocínio levaram cerca de 4 segundos. Uma única execução não diz se isso é típico.
Dá para baratear o Hydrogen baixando o nível de raciocínio?
O Google diz que low oferece o menor uso de tokens e a menor latência, então rodamos de novo a requisição de triagem no Hydrogen: duas vezes com reasoning_effort: "low" solicitado na rota compatível com OpenAI e duas vezes com thinkingConfig.thinkingLevel: "low" solicitado na rota nativa do Gemini da Ofox. As duas são as formas documentadas de definir o nível na Ofox. As duas rotas aceitaram a requisição (HTTP 200), mas nenhuma resposta informa qual nível foi aplicado, então o efeito da configuração não está confirmado.
| Triagem no Hydrogen, 2 execuções cada | Precisão | Tokens de raciocínio | Custo por chamada (preço de tabela) | Latência |
|---|---|---|---|---|
| Padrão (sem parâmetro) | 20/20, 20/20 | 1.585 / 1.811 | US$ 0,0182 / US$ 0,0199 | 16,2 / 16,1 s |
reasoning_effort: "low" solicitado | 20/20, 20/20 | 1.564 / 1.650 | US$ 0,0180 / US$ 0,0187 | 15,8 / 17,1 s |
thinkingLevel: "low" nativo solicitado | 20/20, 20/20 | 1.478 / 1.630 | US$ 0,0174 / US$ 0,0185 | 19,1 / 18,8 s |
Nesse prompt, solicitar low quase não mexeu nos tokens de raciocínio, no custo nem na latência. O low foi solicitado; o efeito não está confirmado. Pela resposta, não dá para saber se o nível foi aplicado e o modelo simplesmente achou que o lote de 20 itens merecia esse tanto de raciocínio, ou se a configuração não foi aplicada nessas rotas. Em qualquer caso, não conte com um nível mais baixo para trazer o custo do Hydrogen ao patamar do Haiku ou do Luna. Meça com os seus próprios prompts. Nosso artigo relacionado sobre os níveis de raciocínio do Gemini 4 detalha os níveis.
Limites deste teste
Isto é uma ilustração, não um benchmark. São 24 chamadas, um formato de lote, uma folha de regras e três prompts de raciocínio, todos rodados num único dia. Acertar os 20 itens mostra que o trabalho estava ao alcance desses modelos, mas não estabelece uma taxa de erro. Não testamos documentos longos, imagens, áudio, chamadas de ferramentas nem agentes de várias etapas, e são justamente essas as áreas em que a pontuação mais alta do Hydrogen na AA tem mais chance de pesar. A latência pela rota da Ofox pode ser diferente da API direta de cada fornecedor. O teste inteiro, incluindo as execuções extras, custou cerca de US$ 0,14 nos preços de tabela oficiais.
Quando o custo extra do Hydrogen compensa
Escolha pelo tipo de trabalho, e não só pelo preço baixo por token. Com base na documentação, nos dados da AA e nas nossas execuções:
Use o Haiku 5.5 ou o Luna quando a tarefa for curta, bem especificada e verificável. Classificação, roteamento, extração de campos com schema, cálculos simples com regras dadas. Os dois foram precisos no nosso conjunto e custaram de 1/20 a 1/40 do Hydrogen por chamada. A Anthropic descreve o Haiku 5.5 como feito “for high-volume, latency-sensitive tasks such as classification, extraction, and routing” (ou seja, para tarefas de alto volume e sensíveis à latência, como classificação, extração e roteamento). Para escolher entre os dois, use a sua própria amostra: o Luna usou menos tokens na nossa execução; o Haiku teve a pontuação mais alta na AA tanto na configuração padrão (25 contra 18) quanto no esforço máximo (36 contra 28). Para padrões de extração com o Luna, veja saídas estruturadas do Luna para extração de dados (em inglês); para jobs de volume com o Haiku, veja Haiku 5.5 vs 4.5 em tarefas em lote (em inglês).
Pague pelo Hydrogen quando a tarefa precisar de raciocínio, ferramentas ou modalidades que os modelos pequenos não têm:
- Trabalho mais difícil e de várias etapas. A pontuação do Hydrogen na AA em
medium(41) é maior que a do Haiku emmax(36). Se você já levou um modelo pequeno ao esforço máximo e ele continua falhando nas suas verificações, o Hydrogen numa configuração mais baixa é um próximo teste razoável. O Google o posiciona para “everyday coding and agentic workflows” (programação do dia a dia e fluxos de trabalho com agentes). - Entrada de áudio e vídeo. O model card do Google lista texto, imagens, áudio e vídeo como entradas do Hydrogen. A Anthropic lista entrada de texto e imagem para seus modelos atuais; a página do modelo Luna lista as modalidades texto e imagem.
- Prompts longos. A tarifa do Hydrogen não muda com o tamanho do prompt. Quando uma requisição passa de 100K tokens de prompt, a tarifa do Haiku sobe cinco vezes e a diferença para o Hydrogen cai para 3x. Acima de 272K, a entrada do Luna dobra. Se a maioria das suas requisições é longa, refaça as contas com as faixas mais altas.
- Protótipos gratuitos no Google. O nível gratuito do Hydrogen permite construir antes de pagar, sujeito aos termos de uso de dados do Google e aos limites do projeto. Veja nosso guia do nível gratuito da API do Gemini 4.
Use o Gemini 3.5 Flash-Lite quando precisar da menor latência do Google, ou de entrada de áudio e vídeo a preço baixo, e puder validar as saídas. O próprio guia do Hydrogen do Google recomenda manter o 3.5 Flash-Lite “for high-volume classification, routing, and sub-second latency targets” (para classificação e roteamento em alto volume e metas de latência abaixo de um segundo). Ele foi o modelo mais rápido do nosso teste, mas errou uma regra estrita de ID e um cálculo de datas, e sua tarifa de saída é cinco vezes a do Haiku ou do Luna. Nossa comparação anterior de extração entre Luna e Gemini 3.5 Flash-Lite (em inglês) aprofunda as diferenças de formato de entrada.
Um padrão prático é rotear por dificuldade. Mande todo item primeiro para o Haiku ou o Luna. Valide a saída contra o seu schema e o texto de origem. Escale para o Hydrogen só as falhas, os itens de baixa confiança ou as entradas multimodais longas. Nosso guia de custo por resultado correto mostra como precificar isso, e limites de roteamento do Luna para o Sol (em inglês) traz uma regra de escalonamento calculada passo a passo. Se a dúvida é entre o Hydrogen e o nível logo acima, veja a comparação relacionada Hydrogen vs Claude Sonnet 5.5 vs GPT-6.1 Terra e, para a linha completa, níveis de modelo do Gemini 4, Claude e GPT.
Reproduza o teste com os seus dados
Na nossa execução, usamos uma chave da Ofox e a rota Chat Completions compatível com OpenAI para os quatro modelos, então a única mudança entre eles foi a string model. A requisição mínima é esta:
curl https://api.ofox.io/v1/chat/completions \
  -H "Authorization: Bearer $OFOX_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "anthropic/claude-haiku-5.5",
    "max_tokens": 32000,
    "messages": [
      {"role": "system", "content": "<your rule sheet>"},
      {"role": "user", "content": "<your batch of items>"}
    ]
  }'
Troque por google/gemini-4-hydrogen, openai/gpt-6-luna ou google/gemini-3.5-flash-lite. Leia usage.prompt_tokens, usage.completion_tokens e usage.completion_tokens_details.reasoning_tokens em cada resposta. Nos modelos Gemini, os tokens de completion já incluem os tokens de raciocínio; não some duas vezes.
Nossos materiais, para você rodar de novo ou adaptar: o conjunto de teste completo com folha de regras, itens e gabarito, o script de execução, o script de pontuação e nossos resultados pontuados com o uso de cada chamada. A execução extra do Hydrogen com raciocínio baixo usou este script da rota nativa e está pontuada em results_extra.json. Os scripts usam só a biblioteca padrão do Python e leem a chave de OFOX_API_KEY. O conjunto de teste e os prompts continuam em inglês, como foram enviados. Em resumo:
- Folha de regras (prompt de sistema, original em inglês): cinco categorias; o ID do pedido é o primeiro
ORD-seguido de exatamente seis dígitos, em maiúsculas, senão null; refund é true só para pedido explícito de dinheiro de volta; problemas de entrega sãoshippingmesmo quando há pedido de reembolso; páginas de erro sãobugmesmo numa página de cobrança; com dois problemas, vale o primeiro. - Itens de triagem e gabarito, por exemplo: “Order ORD-77812 never arrived. I want my money back.” →
shipping,null,true; “The page shows ‘Error 502’ whenever I open billing settings.” →bug,null,false; “Tracking for ORD-55120 and ORD-551209 both show delivered, but only one box came.” →shipping,ORD-551209,false. - Prompts de raciocínio: 12.000 requisições com 1.800 tokens de entrada e 250 de saída, a US$ 0,10 e US$ 0,50 por milhão, 4% repetidas uma vez (resposta $3.8064); um chamado de sexta-feira às 15:00 com SLA de 6 horas úteis e um de segunda-feira às 22:30 com 8 horas, horário comercial de segunda a sexta, 09:00–17:00 (segunda 13:00; terça 17:00); três pedidos de reembolso em 15 de novembro de 2026 sob uma política de 30 dias para item não usado, 90 dias para item danificado e produto digital só se nunca baixado (sim, não, sim).
Para adaptar:
- Escreva de 20 a 50 itens parecidos com o seu tráfego real, incluindo os casos-limite que dão problema em produção. Escreva o gabarito antes de rodar qualquer coisa.
- Rode cada candidato na configuração padrão e depois um nível acima ou abaixo. Registre a precisão por campo, e não apenas “JSON válido”.
- Calcule o custo de cada chamada a partir do uso informado e das tarifas oficiais, incluindo novas tentativas. Para um job grande, veja se o processamento em Batch se encaixa; os quatro modelos listam tarifas de Batch pela metade do preço Standard.
- Escolha o modelo mais barato que atinge a sua meta de precisão e mande as falhas dele para um modelo mais forte.
O guia de saída estruturada da Ofox mostra como pedir JSON restrito por schema. Para execuções em alto volume, confira a documentação de limites de taxa e monte as novas tentativas a partir do guia de tratamento de erros. Se um modelo retornar erros durante o teste, nosso guia de erros da API do Gemini 4, como corrigir o Claude 529 overloaded (em inglês) e solução de erros model-not-found da OpenAI (em inglês) cobrem as causas comuns por fornecedor.
A resposta curta
O Hydrogen é um modelo de uso geral competente, com preço intermediário. Para trabalhos simples e de alto volume, ele não é a opção econômica: no nosso conjunto de triagem, empatou em precisão com o Haiku 5.5 e o Luna e custou de 24 a 46 vezes mais. O prêmio faz sentido quando a tarefa é difícil a ponto de os modelos pequenos falharem nas suas verificações, quando precisa de entrada de áudio ou vídeo, ou quando passa com frequência das linhas de preço de 100K do Haiku ou de 272K do Luna. A opção de baixo custo do próprio Google na família Gemini é o 3.5 Flash-Lite. Ele foi o modelo mais rápido que testamos, mas, no preço por token, ainda custa mais que o Haiku e o Luna.
Documentação relacionada
- Gemini 4 Hydrogen na Ofox (protocolos compatíveis e preço atual na Ofox)
- Claude Haiku 5.5 na Ofox
- GPT-6 Luna na Ofox
- Gemini 3.5 Flash-Lite na Ofox
- Configurações de raciocínio do Gemini
- API nativa do Gemini
- Saída estruturada
- Limites de taxa e tratamento de erros
Perguntas frequentes
- Um job grande em lote faz o Claude Haiku 5.5 passar para a faixa de preço mais alta?
- Não. A Anthropic cobra cada requisição pelo tamanho do próprio prompt. Só uma requisição individual cujo prompt (incluindo leituras e gravações de cache) passe de 100.000 tokens paga as tarifas mais altas, e nesse caso elas valem para a requisição inteira, incluindo a saída.
- Dá para usar o Gemini 4 Hydrogen com o raciocínio desligado?
- O Google documenta quatro níveis de raciocínio para o Hydrogen (low, medium, high e xhigh, com high como padrão) e não descreve nenhum deles como desligado. No nosso teste de triagem, solicitamos low em duas rotas; não está confirmado se o nível foi aplicado, e os tokens de raciocínio informados quase não mudaram nesse prompt.