Gemini 4 Hydrogenは低価格モデル?Claude Haiku 5.5・GPT-6 Lunaと費用を比較
Hydrogenのトークン単価はHaiku 5.5やLunaの15倍です。公式料金、Artificial Analysisのタスク当たり費用、24回の振り分けテストから、追加費用に見合う場面を整理します。
 Ofox
いいえ。Gemini 4 HydrogenはGoogleの中価格帯の汎用モデルであり、低価格帯のモデルではありません。Googleの有料Standard料金では、入力100万トークン当たり1.50ドル、出力100万トークン当たり7.50ドルです。これはClaude Haiku 5.5とGPT-6 Lunaの短いプロンプト向け料金(どちらも0.10ドルと0.50ドル)の15倍です。 完了したタスク単位で比べると、差はさらに広がることがあります。Hydrogenはデフォルトで high の思考を行い、同じ作業により多くの出力トークンを使うためです。Google自身のガイドも、大量の分類やルーティングにはHydrogenではなくGemini 3.5 Flash-Liteを勧めています。
ただし、Hydrogenが割高で選ぶ価値がないという意味ではありません。Artificial AnalysisのIntelligence Indexでは、デフォルト設定のHaiku 5.5やLunaのおよそ2倍のスコアです。一方、シンプルで条件が明確な振り分け作業では、その追加の能力は結果に差を生みませんでした。今回のテストでは、HaikuとLunaも同じく正確で、費用ははるかに少なく済みました。
この記事はOfoxが公開しています。2026年11月19日の確認時点で、記事内の4モデルはすべてOfox経由で呼び出せました。以下の情報には、3つの区分のいずれかを明記しています。公式ドキュメント(2026年11月19日確認)、Artificial Analysisのデータ(2026年11月19日取得)、そして同日にOfox経由で実施した小規模な独自テストです。テストの金額は、各ベンダーの公式定価を使った当社の計算であり、Ofoxの請求額ではありません。Ofox自体の料金は、記事末尾にリンクした各モデルページに掲載しています。
同じ条件でそろえた公式定価
料金はすべて100万トークン当たりの米ドルで、有料Standard区分、各社のファーストパーティAPIの値です。4モデルとも、出力料金には思考トークンまたは推論トークンが含まれます。
| モデル(API ID) | 入力 | 出力 | キャッシュ入力 | 料金条件 | Batch 入力/出力 |
|---|---|---|---|---|---|
Gemini 4 Hydrogen(gemini-4-hydrogen) | $1.50 | $7.50 | $0.075(暗黙的キャッシュのみ) | プロンプト長にかかわらず同一料金 | $0.75 / $3.75 |
Claude Haiku 5.5(claude-haiku-5-5) | $0.10 | $0.50 | 読み取り $0.01、5分書き込み $0.125 | プロンプト ≤100,000トークン | $0.05 / $0.25 |
| Claude Haiku 5.5、プロンプト >100K | $0.50 | $2.50 | 読み取り $0.05、5分書き込み $0.625 | リクエスト全体に適用 | $0.25 / $1.25 |
GPT-6 Luna(gpt-6-luna) | $0.10 | $0.50 | $0.01 | 入力 ≤272Kトークン | $0.05 / $0.25 |
| GPT-6 Luna、入力 >272K | $0.20 | $0.75 | $0.02 | リクエスト全体に適用 | $0.10 / $0.375 |
Gemini 3.5 Flash-Lite(gemini-3.5-flash-lite) | $0.30 | $2.50 | $0.03 + 保存料 100万トークン・1時間当たり$1.00 | 単一料金 | $0.15 / $1.25 |
出典:Google Gemini APIの料金(英語)、Anthropicの料金(英語)、OpenAIの料金(英語)、GPT-6 Lunaのモデルページ(英語)。
比較結果に効いてくるのは、15倍という表面上の比率よりも、次の3つの点です。
Haiku 5.5の低料金には上限があります。 AnthropicはHaiku 5.5の料金をプロンプトの長さで決めています。プロンプトが100,000トークンを超えるリクエストは基本料金の5倍になり、出力も含めてリクエスト全体に適用されます。キャッシュの読み取りと書き込みも100Kに数えられます。この線を超えると、HydrogenはHaikuの15倍ではなく3倍にとどまります。境界の計算は、Haiku 5.5の100K料金ガイドで具体的な数字とともに説明しています。Lunaにも入力272Kトークンで同様の段差があります。Hydrogenの料金表には長いコンテキスト向けの区分はありません。
Hydrogenには無料枠があります。 AnthropicとOpenAIの料金ページには、Haiku 5.5とLunaの有料料金しか掲載されていません。一方Googleは、無料枠でHydrogenと3.5 Flash-Liteをどちらも無料と表示しており、試作に役立ちます。ただしGoogleの表には、無料枠のコンテンツは同社製品の改善に使われるとも記載されており、利用できるかどうかはプロジェクトの条件と上限によります。確認方法とクォータはHydrogenの導入ガイドで説明しています。
Flash-LiteはHydrogenより安いものの、HaikuやLunaより安いわけではありません。 入力料金はこの2モデルの3倍、出力料金は5倍です。Googleのラインアップの中では低コストの選択肢ですが、他社と比べると最安ではありません。
1タスクに実際いくらかかるか:Artificial Analysisのデータ
トークン単価だけでは、各モデルが何トークン使うかは分かりません。Artificial Analysis(AA、英語)は各モデルでIntelligence Indexの評価を実行し、タスク当たりの加重平均費用を公表しています。この費用は、各モデルが実際に使ったトークンとそのモデルの料金から算出されます。2026年11月19日に4モデルのページを取得しました。最初の表は、各ベンダーが文書で示すデフォルト設定を使っています。Hydrogenは high の思考(GoogleのHydrogenガイド、英語)、Haiku 5.5は medium のeffort(Anthropicのモデル概要、英語)、Lunaは medium(OpenAIのモデルページ)です。
AAの表示ページに出ているのは、各モデルの最上位設定のタスク当たり費用だけです。その他の設定の費用は同じページの背後にあるデータから取得しました。各費用には対応するバリアントのタグ(例:claude-haiku-5-5-medium、gemini-4-hydrogen-high)が付いているため、以下のeffortのラベルはAA自身のもので、当社が対応付けたものではありません。各ラベルのインデックススコアは表示ページと一致しています。
| デフォルト設定のモデル | AA Intelligence Index | AA Indexタスク当たり費用 | AA出力速度 |
|---|---|---|---|
| Gemini 4 Hydrogen(high) | 51 | $1.87 | 165トークン/秒 |
| Claude Haiku 5.5(medium) | 25 | $0.092 | 222トークン/秒 |
| GPT-6 Luna(medium) | 18 | $0.042 | 96トークン/秒 |
| Gemini 3.5 Flash-Lite(掲載バリアントは1つのみ) | 12 | $0.69 | 318トークン/秒 |
デフォルト設定では、AAのタスク当たり費用でHydrogenはHaikuの約20倍、Lunaの約44倍です。どちらの差もトークン単価の15倍より大きくなっています。high のHydrogenはタスク当たりの生成トークンが多いためです。能力の差も同じ向きで、HydrogenのインデックススコアはHaikuのおよそ2倍、Lunaの3倍近くです。
安いモデルのeffortを上げると、状況は変わります。
| 掲載されている最上位設定 | AA Intelligence Index | AA Indexタスク当たり費用 |
|---|---|---|
| Gemini 4 Hydrogen(xhigh) | 54 | $3.16 |
| Claude Haiku 5.5(max) | 36 | $0.41 |
| GPT-6 Luna(max) | 28 | $0.15 |
最上位設定では、Haikuとの差は約7.7倍まで縮みます。max のHaikuははるかに多くのトークンを使うためです。Lunaは引き続き約21倍安いままです。ただし max にしても、どちらも medium のHydrogenのスコア(AAのページでは41)には届きません。AAのページデータでは、medium のHydrogenはタスク当たり0.80ドルで、max のHaiku(0.41ドル)の約2倍の費用に対してスコアは5ポイント高くなります。ワークロードがAAのような難しい推論やエージェント型のタスクに近いなら、小さなモデルを限界まで引き上げるより、低めの設定のHydrogenのほうが割安なこともあります。
これらの数字を読むときは、次の限界に注意してください。
- AAのインデックスは難しい評価の集合です。スコア25は、Haikuがあなたの抽出ジョブの4分の3で失敗するという意味ではありません。後述のテストでは、ルールに沿ったシンプルな作業でHaikuとLunaは完全に正確でした。
- AAの速度の数値はAA自身の測定値です。
highのHydrogenで最初の回答トークンまでの時間は19.4秒と掲載されており、mediumのHaikuは9.1秒、mediumのLunaは5.3秒でした。この時間には思考時間が含まれます。 - AAのFlash-Liteのタスク当たり費用(0.69ドル)は、「1リクエスト当たり」の費用として比べるのは適切ではありません。AA自身の内訳では、その大半が出力ではなくキャッシュ関連の入力費用です。短い単発のリクエストでは、後述のテストのとおり、Flash-LiteはHydrogenより安く済みました。
独自テスト:振り分け20件と短い推論問題3問
これらの数字が、低価格モデルを導入する典型的な作業、つまり短い項目が大量にあり、ルールシートが決まっていて、JSONで回答する作業で何を意味するかを確かめました。2026年11月19日、OfoxのOpenAI互換エンドポイント(https://api.ofox.io/v1/chat/completions)経由で、同じプロンプトを次のモデルIDで実行しました:google/gemini-4-hydrogen、anthropic/claude-haiku-5.5、openai/gpt-6-luna、google/gemini-3.5-flash-lite。
設定。 モデルのデフォルト設定を使いました。temperatureも思考・推論のパラメータも指定していません。指定したのは支出の上限としての max_tokens: 32000 だけで、この上限に達したレスポンスはありませんでした(finish_reason はすべて stop)。
ワークロードA:振り分け。 1つのリクエストに20件のカスタマーサポートのメッセージを入れました。モデルは各メッセージについて、category(5クラス)、order_id(最初の有効な ORD- と6桁の数字。大文字に変換し、なければnull)、refund(返金を明示的に求めている場合のみtrue)を返します。正解表はどのモデルを呼び出す前にも作成済みです。いくつかの項目には意図的にひっかけを入れています。除外すべき5桁の注文ID、紛らわしい電話番号とチケット番号、「返金は求めていない」という明示的な文、スペイン語のメッセージ、皮肉、請求画面に出ているが実際はバグであるエラーページ、そして先に書かれた問題で判断する2つの問題を含むメッセージです。各モデルでこのリクエストを2回実行しました。
ワークロードB:推論。 1つの確認可能な答えを持つ3つの独立したプロンプトです。再試行コストの計算(答え:$3.8064)、営業時間ベースのSLA期限2件(月曜13:00、火曜17:00)、日数の計算が必要な返金ポリシーの判断3件(可、不可、可)。各1回実行しました。
プロンプト全文、ルールシート、正解表、実行スクリプト、採点スクリプトへのリンクは、後述の再現セクションにあります。
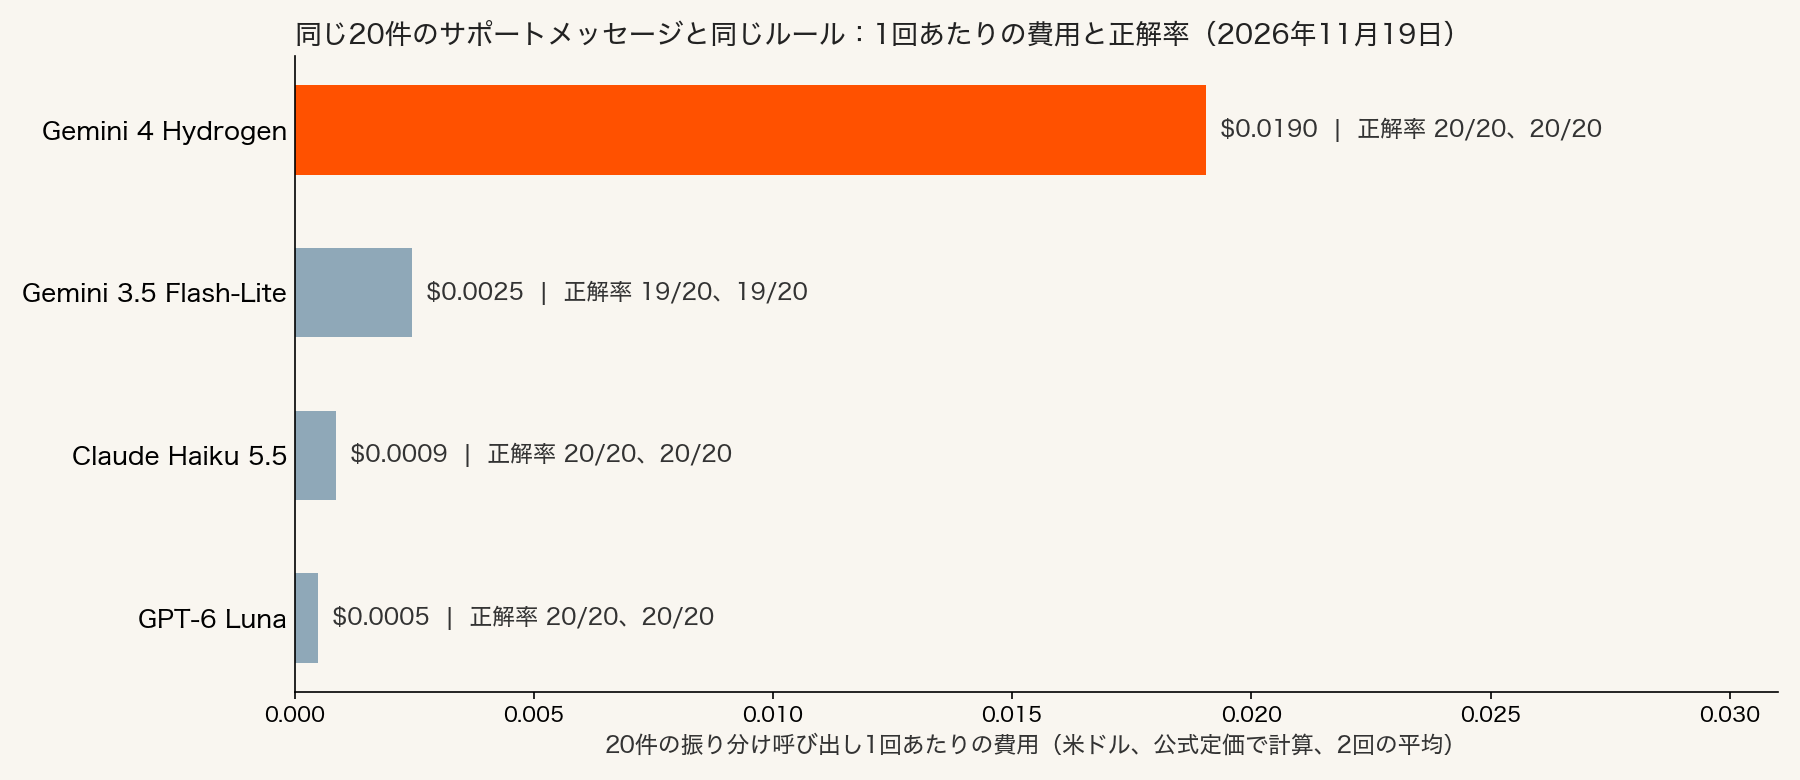
グラフは2026年11月19日の実行結果で、各モデル2回の振り分け呼び出しの平均を、ファーストパーティの公式定価で計算しています。Ofoxの請求額ではありません。
正解率と費用の結果
| モデル | 振り分け正解率(2回) | 推論問題 | 振り分けの平均レイテンシ | 振り分け1回当たりの平均出力トークン(うち思考) | 振り分け1回の費用 | 同じ料金で1,000件当たり |
|---|---|---|---|---|---|---|
| Gemini 4 Hydrogen | 20/20、20/20 | 3/3 | 16.1秒 | 2,336(≈1,698) | $0.0190 | ≈$0.95 |
| Claude Haiku 5.5 | 20/20、20/20 | 3/3 | 7.8秒 | 1,476(≈831) | $0.00086 | ≈$0.043 |
| GPT-6 Luna | 20/20、20/20 | 3/3 | 8.3秒 | 780(≈239) | $0.00048 | ≈$0.024 |
| Gemini 3.5 Flash-Lite | 19/20、19/20(各59/60フィールド) | 2/3 | 3.6秒 | 861(思考の報告なし) | $0.00245 | ≈$0.12 |
費用は公式定価による計算です。各レスポンスで報告された入力トークンと出力トークンに、最初の表のファーストパーティStandard料金を掛けています。プロンプトはすべて100Kトークンを大きく下回っているため、HaikuとLunaは低い区分の料金で計算しました。レイテンシは、当社のクライアントからOfoxを経由して、ストリーミングなしのレスポンスを最後まで受け取るまでの実時間で、ネットワーク時間を含みます。最初のトークンまでの時間ではありません。「1,000件当たり」の列は、測定した1バッチの費用を50倍しただけで、同じプロンプト構成で再試行がないことを前提にしています。
各モデル5回分の呼び出しを合計すると、Hydrogenは $0.0578、Haikuは $0.0024、Lunaは $0.0012、Flash-Liteは $0.0071 でした。このワークロードでは、HydrogenはHaikuの約24倍、Lunaの46倍の費用になりました。トークン単価の15倍という割高さが広がったのは、同じ答えに対して出力トークン(主に思考)を多く生成したためです。
実行結果から分かったこと:
- Hydrogenの追加の能力は結果を変えませんでした。 Hydrogen、Haiku、Lunaの3モデルとも、2回の振り分けで全フィールドが正解し、推論問題も3問すべて正解しました。ルールシートが明確で条件がはっきりした作業なら、安いモデルで十分でした。
- Lunaはトークン効率が最も高い結果でした。 振り分け1回当たりの推論トークンは約240で、Hydrogenは約1,700、Haikuは約830でした。トークナイザーが異なるため、ベンダー間でトークン数を完全に比較することはできませんが、費用の差はこの数から生じています。
- Flash-Liteは最速でしたが、2か所で誤りました。 2回の振り分けとも、項目7で
ORD-77812を返しました。これはルール上除外すべき5桁のIDです。返金ポリシーの問題では、10月10日から11月15日までを36日ではなく21日と数え、30日ルールで認められないはずの返金を承認しました。Flash-Liteは推論トークンを報告しませんでした。OfoxのGemini思考ガイドでは、Flash-Liteシリーズはデフォルトでは思考しないと説明しています。 - Haikuの呼び出しが1回だけ遅くなりました。 再試行コストのプロンプトは18.8秒かかり、ほかの2回の推論呼び出しは約4秒でした。1回の実行だけでは、これが通常の挙動かどうかは判断できません。
思考レベルを下げればHydrogenは安くなるか
Googleは low でトークン使用量とレイテンシが最も小さくなるとしています。そこでHydrogenで振り分けリクエストを再実行しました。OpenAI互換の経路で reasoning_effort: "low" を指定して2回、OfoxのGeminiネイティブ経路で thinkingConfig.thinkingLevel: "low" を指定して2回です。どちらもOfoxでレベルを設定する方法としてドキュメントに記載されています。両経路ともリクエストを受け付けました(HTTP 200)が、どちらのレスポンスにも実際に適用されたレベルは示されていないため、設定の効果は確認できていません。
| Hydrogenの振り分け、各2回 | 正解率 | 思考トークン | 1回当たりの定価ベース費用 | レイテンシ |
|---|---|---|---|---|
| デフォルト(パラメータなし) | 20/20、20/20 | 1,585 / 1,811 | $0.0182 / $0.0199 | 16.2 / 16.1秒 |
reasoning_effort: "low" を指定 | 20/20、20/20 | 1,564 / 1,650 | $0.0180 / $0.0187 | 15.8 / 17.1秒 |
ネイティブの thinkingLevel: "low" を指定 | 20/20、20/20 | 1,478 / 1,630 | $0.0174 / $0.0185 | 19.1 / 18.8秒 |
このプロンプトでは、low を指定しても思考トークン、費用、レイテンシはほとんど変わりませんでした。lowは指定しましたが、その効果は確認できていません。レスポンスからは、レベルが適用されたうえでモデルが20件のバッチにこれだけの思考が必要だと判断したのか、それともこれらの経路で設定が適用されなかったのかを判別できません。いずれにしても、レベルを下げればHydrogenの費用がHaikuやLunaの水準まで下がるとは考えないでください。自分のプロンプトで測定することをおすすめします。各レベルの詳細は、関連記事のGemini 4の思考レベルで扱っています。
このテストの限界
これは例示であり、ベンチマークではありません。呼び出しは24回、バッチの形は1種類、ルールシートは1つ、推論プロンプトは3つで、すべて1日で実行しました。20件で満点だったことは、この作業がこれらのモデルの能力の範囲内だったことを示すにすぎず、誤り率を示すものではありません。長い文書、画像、音声、ツール呼び出し、複数ステップのエージェントはテストしておらず、Hydrogenの高いAAスコアが最も効いてくる可能性があるのはこうした領域です。Ofox経路のレイテンシは、各ベンダーのAPIに直接接続した場合と異なることがあります。追加実行を含めたテスト全体の費用は、公式定価で約 $0.14 でした。
Hydrogenの追加費用が意味を持つ場面
トークン単価の安さだけで決めず、作業の内容で選んでください。ドキュメント、AAのデータ、今回の実行結果に基づく目安は次のとおりです。
短く、条件が明確で、結果を検証できる作業にはHaiku 5.5かLunaを使います。 分類、ルーティング、スキーマに沿ったフィールド抽出、ルールが示された簡単な計算などです。どちらも今回のテストセットで正確で、1回当たりの費用はHydrogenのおよそ20分の1から40分の1でした。AnthropicはHaiku 5.5を “for high-volume, latency-sensitive tasks such as classification, extraction, and routing”(分類・抽出・ルーティングのような、大量でレイテンシに敏感なタスク向け)に作られたモデルと説明しています。2つのどちらを選ぶかは、自分のサンプルで判断してください。今回の実行で最もトークンが少なかったのはLunaで、AAスコアはデフォルト設定(25対18)でも最大effort(36対28)でもHaikuが上でした。Lunaの抽出パターンはLunaの構造化出力によるデータ抽出、Haikuのスループット重視の作業はHaiku 5.5と4.5のバッチ処理比較を参照してください。
小さなモデルにない推論力、ツール、モダリティが必要な作業にはHydrogenを選びます。
- 難しい複数ステップの作業。
mediumのHydrogenのAAスコア(41)は、maxのHaiku(36)を上回ります。小さなモデルを最大effortにしてもチェックに通らない場合は、低めの設定のHydrogenを次に試すのが妥当です。GoogleはHydrogenを “everyday coding and agentic workflows”(日常的なコーディングとエージェント型ワークフロー)向けと位置付けています。 - 音声・動画の入力。 GoogleのモデルカードはHydrogenの入力としてテキスト、画像、音声、動画を挙げています。Anthropicが現行モデルに挙げている入力はテキストと画像で、Lunaのモデルページに記載されたモダリティもテキストと画像です。
- 長いプロンプト。 Hydrogenの料金はプロンプトの長さで変わりません。リクエストのプロンプトが100Kトークンを超えるとHaikuの料金は5倍になり、Hydrogenとの差は3倍まで縮まります。272Kを超えるとLunaの入力料金は2倍になります。リクエストの大半が長い場合は、高い区分の料金で計算し直してください。
- Googleでの無料の試作。 Hydrogenの無料枠を使えば、支払いの前に試作できます。ただしGoogleのデータ利用条件とプロジェクトの上限が適用されます。Gemini 4の無料API枠ガイドを参照してください。
Googleで最も低いレイテンシが必要な場合や、音声・動画の入力を低価格で扱いたい場合で、出力を検証できるならGemini 3.5 Flash-Liteを使います。 GoogleのHydrogenガイド自体が、3.5 Flash-Liteを “for high-volume classification, routing, and sub-second latency targets”(大量の分類、ルーティング、1秒未満のレイテンシ目標向け)に使い続けるよう勧めています。今回のテストでは最速でしたが、厳密なIDのルールと日付の計算を1つずつ誤り、出力料金はHaikuやLunaの5倍です。入力形式の違いについては、以前のLunaとGemini 3.5 Flash-Liteの抽出比較で詳しく扱っています。
実用的なのは、難しさに応じて振り分ける方法です。まずすべての項目をHaikuかLunaに送り、出力をスキーマと元のテキストに照らして検証します。失敗したもの、確信度が低いもの、長いマルチモーダル入力だけをHydrogenに回します。費用の見積もり方は正しい結果1件当たりの費用ガイドで、具体的なエスカレーションの基準はLunaからSolへのルーティングしきい値で示しています。Hydrogenと1つ上の区分のどちらにするか迷っている場合は、関連記事のHydrogen、Claude Sonnet 5.5、GPT-6.1 Terraの比較を、ラインアップ全体についてはGemini 4・Claude・GPTのモデル区分比較を参照してください。
自分のデータでテストを再現する
今回の実行では、4モデルすべてで1つのOfoxキーとOpenAI互換のChat Completions経路を使ったため、モデル間で変えたのは model の文字列だけです。最小限のリクエストは次のとおりです。
curl https://api.ofox.io/v1/chat/completions \
  -H "Authorization: Bearer $OFOX_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "anthropic/claude-haiku-5.5",
    "max_tokens": 32000,
    "messages": [
      {"role": "system", "content": "<your rule sheet>"},
      {"role": "user", "content": "<your batch of items>"}
    ]
}'google/gemini-4-hydrogen、openai/gpt-6-luna、google/gemini-3.5-flash-lite に置き換えて実行します。各レスポンスから usage.prompt_tokens、usage.completion_tokens、usage.completion_tokens_details.reasoning_tokens を読み取ります。Geminiモデルでは、completionトークンにすでに推論トークンが含まれているため、二重に足さないでください。
再実行や応用に使えるよう、資料を公開しています。ルールシート・項目・正解表を含むテストセット、実行スクリプト、採点スクリプト、呼び出しごとの使用量を含む採点結果です。Hydrogenの低思考レベルの追加実行にはこのネイティブ経路用スクリプトを使い、結果はresults_extra.jsonで採点しています。スクリプトはPython標準ライブラリだけを使い、キーは OFOX_API_KEY から読み込みます。テストセットとプロンプトは、送信したときの英語のままです。概要は次のとおりです。
- ルールシート(システムプロンプト、原文は英語):カテゴリは5つ。注文IDは
ORD-の直後にちょうど6桁の数字が続く最初のものを大文字にし、なければnull。refundは返金を明示的に求めている場合のみtrue。配送の問題は返金を求めていてもshipping。エラーページは請求ページ上でもbug。問題が2つある場合は最初のものを使う。 - 振り分け項目と正解の例:“Order ORD-77812 never arrived. I want my money back.” →
shipping、null、true。“The page shows ‘Error 502’ whenever I open billing settings.” →bug、null、false。“Tracking for ORD-55120 and ORD-551209 both show delivered, but only one box came.” →shipping、ORD-551209、false。 - 推論プロンプト:入力1,800トークン・出力250トークンのリクエストが12,000件、料金は100万トークン当たり0.10ドルと0.50ドル、4%が1回ずつ再試行(答え$3.8064)。金曜15:00に受け付けた営業時間6時間SLAのチケットと、月曜22:30に受け付けた8時間SLAのチケット、営業時間は月曜〜金曜の09:00〜17:00(月曜13:00、火曜17:00)。2026年11月15日の返金申請3件に、未使用30日・破損90日・デジタル商品は未ダウンロードのみ、というポリシーを適用(可、不可、可)。
応用する手順:
- 実際のトラフィックに近い項目を20〜50件用意し、本番で問題になるエッジケースも含めます。何かを実行する前に正解表を作ってください。
- 各候補をデフォルト設定で実行し、次に1段階上または下の設定で実行します。「有効なJSONかどうか」だけでなく、フィールドごとの正解率を記録します。
- 各呼び出しの報告された使用量と公式料金から費用を計算し、再試行も含めます。大規模な作業ではBatch処理が使えるか確認してください。4モデルとも、Batch料金はStandardの半額です。
- 正解率の基準を満たす最も安いモデルを選び、そのモデルが失敗した項目をより強いモデルに回します。
スキーマで制約したJSONの要求方法は、Ofoxの構造化出力ガイドで説明しています。大量に実行する場合はレート制限のドキュメントを確認し、エラー処理ガイドをもとに再試行を組み込んでください。テスト中にモデルがエラーを返した場合は、Gemini 4 APIエラーガイド、Claude 529 overloadedの対処法(英語)、OpenAIのmodel-not-foundエラーの対処(英語)で、ベンダー別のよくある原因を扱っています。
まとめ
Hydrogenは中価格帯の有能な汎用モデルです。大量のシンプルな作業では低価格の選択肢になりません。今回の振り分けテストセットでは、正解率はHaiku 5.5やLunaと同じで、費用は24〜46倍でした。割高な料金に見合うのは、小さなモデルがチェックに通らないほど難しい作業、音声や動画の入力が必要な作業、Haikuの100KやLunaの272Kの料金ラインをたびたび超える作業です。Google自身の低コストなGeminiの選択肢は3.5 Flash-Liteです。今回テストした中では最速でしたが、トークン単価ではHaikuやLunaより高くなります。
関連ドキュメント
よくある質問
- 大量のバッチ処理を行うと、Claude Haiku 5.5は高い料金区分になりますか?
- いいえ。Anthropicはリクエストごとに、そのプロンプトの長さで料金を決めます。高い料金が適用されるのは、1つのリクエストのプロンプト(キャッシュの読み取りと書き込みを含む)が100,000トークンを超えた場合だけです。その場合は出力も含めて、そのリクエスト全体に高い料金が適用されます。
- Gemini 4 Hydrogenは思考をオフにして使えますか?
- GoogleはHydrogenの思考レベルとして4つ(low、medium、high、xhigh。デフォルトはhigh)を公開しており、いずれもオフとは説明されていません。今回の振り分けテストでは2つの経路でlowを指定しましたが、そのレベルが適用されたかは確認できていません。また、このプロンプトでは報告された思考トークンはほとんど変わりませんでした。