Gemini 4 Hydrogen — бюджетная модель? Сравнение затрат с Claude Haiku 5.5 и GPT-6 Luna
Токен Hydrogen по прайсу стоит в 15 раз дороже, чем у Haiku 5.5 и Luna. Сравниваем официальные цены, стоимость задачи по Artificial Analysis и тест сортировки из 24 вызовов, чтобы понять, когда доплата оправдана.
 Ofox
Нет. Gemini 4 Hydrogen — универсальная модель Google среднего ценового уровня, а не бюджетная. По платным тарифам Google Standard она стоит $1,50 за миллион входных токенов и $7,50 за миллион выходных — в 15 раз больше, чем Claude Haiku 5.5 и GPT-6 Luna на коротких промптах (у обеих $0,10 и $0,50). В пересчёте на выполненную задачу разница может быть ещё больше: по умолчанию Hydrogen рассуждает на уровне high и тратит на ту же работу больше выходных токенов. Собственное руководство Google рекомендует для массовой классификации и маршрутизации не Hydrogen, а Gemini 3.5 Flash-Lite.
Это не значит, что Hydrogen — неудачная покупка. В Intelligence Index от Artificial Analysis она набирает примерно вдвое больше, чем Haiku 5.5 и Luna на настройках по умолчанию. Но на простой задаче сортировки с чётко заданными правилами дополнительные возможности ничего не изменили: в нашем тесте Haiku и Luna оказались столь же точными и обошлись намного дешевле.
Статью публикует Ofox; при проверке 19 ноября 2026 года все четыре модели из статьи были доступны для вызова через Ofox. Каждое утверждение ниже отнесено к одной из трёх категорий: официальная документация (проверена 19 ноября 2026 года), данные Artificial Analysis (получены 19 ноября 2026 года) или наш небольшой тест через Ofox в тот же день. Суммы в долларах в тесте — наш расчёт по официальным прайсовым ценам каждого вендора, а не счёт Ofox. Цены самого Ofox указаны на страницах моделей, ссылки на которые даны в конце статьи.
Официальные цены в одинаковых условиях
Все ставки — в долларах США за миллион токенов, платный уровень Standard, собственный API вендора. У всех четырёх моделей цена вывода включает токены рассуждений.
| Модель (API ID) | Вход | Выход | Кэшированный вход | Условие тарифа | Batch: вход / выход |
|---|---|---|---|---|---|
Gemini 4 Hydrogen (gemini-4-hydrogen) | $1,50 | $7,50 | $0,075 (только неявный кэш) | Единая ставка при любой длине промпта | $0,75 / $3,75 |
Claude Haiku 5.5 (claude-haiku-5-5) | $0,10 | $0,50 | чтение $0,01; запись на 5 мин $0,125 | Промпт ≤100 000 токенов | $0,05 / $0,25 |
| Claude Haiku 5.5, промпт >100K | $0,50 | $2,50 | чтение $0,05; запись на 5 мин $0,625 | Применяется ко всему запросу | $0,25 / $1,25 |
GPT-6 Luna (gpt-6-luna) | $0,10 | $0,50 | $0,01 | Вход ≤272K токенов | $0,05 / $0,25 |
| GPT-6 Luna, вход >272K | $0,20 | $0,75 | $0,02 | Применяется ко всему запросу | $0,10 / $0,375 |
Gemini 3.5 Flash-Lite (gemini-3.5-flash-lite) | $0,30 | $2,50 | $0,03 + хранение $1,00 за 1 млн токенов в час | Единая ставка | $0,15 / $1,25 |
Источники: цены Google Gemini API (на английском), цены Anthropic (на английском), цены OpenAI (на английском) и страница модели GPT-6 Luna (на английском).
На итог сравнения сильнее, чем общее соотношение 15×, влияют три детали.
У низкой цены Haiku 5.5 есть потолок. Anthropic тарифицирует Haiku 5.5 по длине промпта. Запрос с промптом длиннее 100 000 токенов оплачивается по ставкам в пять раз выше базовых, причём это касается всего запроса, включая вывод. Чтение и запись кэша засчитываются в эти 100K. Выше этой границы Hydrogen дороже Haiku лишь в три раза, а не в пятнадцать. В нашем разборе цены Haiku 5.5 на границе 100K граница посчитана на конкретных числах. У Luna похожая ступень на 272K входных токенов. В таблице Hydrogen отдельного тарифа для длинного контекста нет.
У Hydrogen есть бесплатный уровень. На страницах цен Anthropic и OpenAI для Haiku 5.5 и Luna указаны только платные тарифы. Google на бесплатном уровне отмечает и Hydrogen, и 3.5 Flash-Lite как бесплатные, что удобно для прототипов. При этом в таблице Google указано, что контент бесплатного уровня используется для улучшения продуктов компании, а доступ зависит от соответствия проекта условиям и от лимитов. Проверку доступа и квоты описывает наше руководство по подключению Hydrogen.
Flash-Lite дешевле Hydrogen, но не дешевле Haiku и Luna. Её входная ставка втрое выше, чем у них, а выходная — впятеро. В линейке Google это недорогой вариант, но на фоне других вендоров она не самая дешёвая.
Сколько на самом деле стоит задача: данные Artificial Analysis
Цена за токен не учитывает, сколько токенов расходует каждая модель. Artificial Analysis (AA, на английском) прогоняет на каждой модели оценки своего Intelligence Index и публикует средневзвешенную стоимость задачи, рассчитанную по фактически израсходованным моделью токенам и её ценам. Мы загрузили страницы четырёх моделей 19 ноября 2026 года. В первой таблице использованы настройки по умолчанию, указанные в документации каждого вендора: рассуждения high для Hydrogen (руководство Google по Hydrogen, на английском), effort medium для Haiku 5.5 (обзор моделей Anthropic, на английском) и medium для Luna (страница модели OpenAI).
На отрисованных страницах AA стоимость задачи показана только для максимальной настройки каждой модели. Стоимость для остальных настроек взята из данных, на которых построены те же страницы: там каждая стоимость помечена своим вариантом (например, claude-haiku-5-5-medium или gemini-4-hydrogen-high), поэтому метки effort ниже принадлежат самой AA, а не сопоставлены нами. Баллы индекса для каждой метки совпадают с отрисованными страницами.
| Модель с настройкой по умолчанию | AA Intelligence Index | Стоимость задачи Index по AA | Скорость вывода по AA |
|---|---|---|---|
| Gemini 4 Hydrogen (high) | 51 | $1,87 | 165 токенов/с |
| Claude Haiku 5.5 (medium) | 25 | $0,092 | 222 токена/с |
| GPT-6 Luna (medium) | 18 | $0,042 | 96 токенов/с |
| Gemini 3.5 Flash-Lite (указан один вариант) | 12 | $0,69 | 318 токенов/с |
На настройках по умолчанию задача AA на Hydrogen обходится примерно в 20 раз дороже, чем на Haiku, и примерно в 44 раза дороже, чем на Luna. Оба разрыва больше, чем 15-кратная разница в цене токена, потому что Hydrogen на high генерирует больше токенов на задачу. Разрыв в возможностях направлен так же: балл Hydrogen примерно вдвое выше, чем у Haiku, и почти втрое выше, чем у Luna.
Картина меняется, если повысить effort у более дешёвых моделей:
| Максимальная указанная настройка | AA Intelligence Index | Стоимость задачи Index по AA |
|---|---|---|
| Gemini 4 Hydrogen (xhigh) | 54 | $3,16 |
| Claude Haiku 5.5 (max) | 36 | $0,41 |
| GPT-6 Luna (max) | 28 | $0,15 |
На максимальных настройках разрыв с Haiku сокращается примерно до 7,7×, потому что на max Haiku расходует гораздо больше токенов. Luna остаётся примерно в 21 раз дешевле. Однако даже на max ни одна из них не достигает балла Hydrogen на medium (41 на странице AA). По данным страницы AA, Hydrogen на medium стоит $0,80 за задачу — примерно вдвое дороже Haiku на max ($0,41) при балле на 5 пунктов выше. Если ваша нагрузка похожа на сложные задачи AA на рассуждения и агентную работу, Hydrogen на пониженной настройке может оказаться выгоднее, чем маленькая модель, выжатая до предела.
Читая эти цифры, учитывайте их ограничения:
- Индекс AA — набор сложных оценок. Балл 25 не означает, что Haiku провалит три четверти ваших задач по извлечению данных. Наш тест ниже показывает, что на простой задаче с чёткими правилами Haiku и Luna были полностью точны.
- Данные о скорости AA — её собственные измерения. Время до первого токена ответа у Hydrogen на
highуказано как 19,4 секунды против 9,1 у Haiku наmediumи 5,3 у Luna наmedium. Это время включает рассуждения. - Стоимость задачи Flash-Lite по AA ($0,69) некорректно сравнивать как стоимость «одного запроса». В собственной разбивке AA большая часть этой суммы — входные затраты, связанные с кэшем, а не вывод. Короткий разовый запрос на Flash-Lite обошёлся нам дешевле, чем на Hydrogen, что видно из теста.
Наш тест: 20 обращений для сортировки и 3 короткие задачи на рассуждение
Мы хотели понять, что эти цифры значат для работы, ради которой обычно и берут бюджетные модели: много коротких элементов, фиксированный свод правил, ответ в JSON. 19 ноября 2026 года мы прогнали одинаковые промпты через OpenAI-совместимый эндпоинт Ofox (https://api.ofox.io/v1/chat/completions) с точными ID моделей: google/gemini-4-hydrogen, anthropic/claude-haiku-5.5, openai/gpt-6-luna и google/gemini-3.5-flash-lite.
Настройки. Настройки моделей по умолчанию: без temperature, без параметров рассуждений. Единственный заданный параметр — max_tokens: 32000 как ограничитель расходов; ни один ответ в него не упёрся (во всех случаях finish_reason был stop).
Нагрузка A: сортировка. Один запрос с 20 обращениями в службу поддержки. Для каждого обращения модель возвращает category (пять классов), order_id (первый корректный ORD- с шестью цифрами, в верхнем регистре, иначе null) и refund (true только при явной просьбе вернуть деньги). Эталонные ответы мы составили до вызова какой-либо модели. Несколько элементов намеренно с подвохом: пятизначный номер заказа, который нужно отклонить, номер телефона и номер тикета как отвлекающие элементы, явное «возврат не прошу», сообщение на испанском, сарказм, страница ошибки, которая появляется на экране оплаты, но на деле является багом, и сообщения с двумя проблемами, где решает первая. Каждая модель выполнила этот запрос дважды.
Нагрузка B: рассуждение. Три отдельных промпта с единственным проверяемым ответом: расчёт стоимости повторных попыток (ответ: $3.8064), два дедлайна SLA в рабочих часах (понедельник 13:00; вторник 17:00) и три решения по политике возвратов, требующие подсчёта дней (да, нет, да). По одному прогону.
Полные промпты, свод правил, эталонные ответы, скрипты запуска и оценки доступны по ссылкам в разделе о воспроизведении ниже.
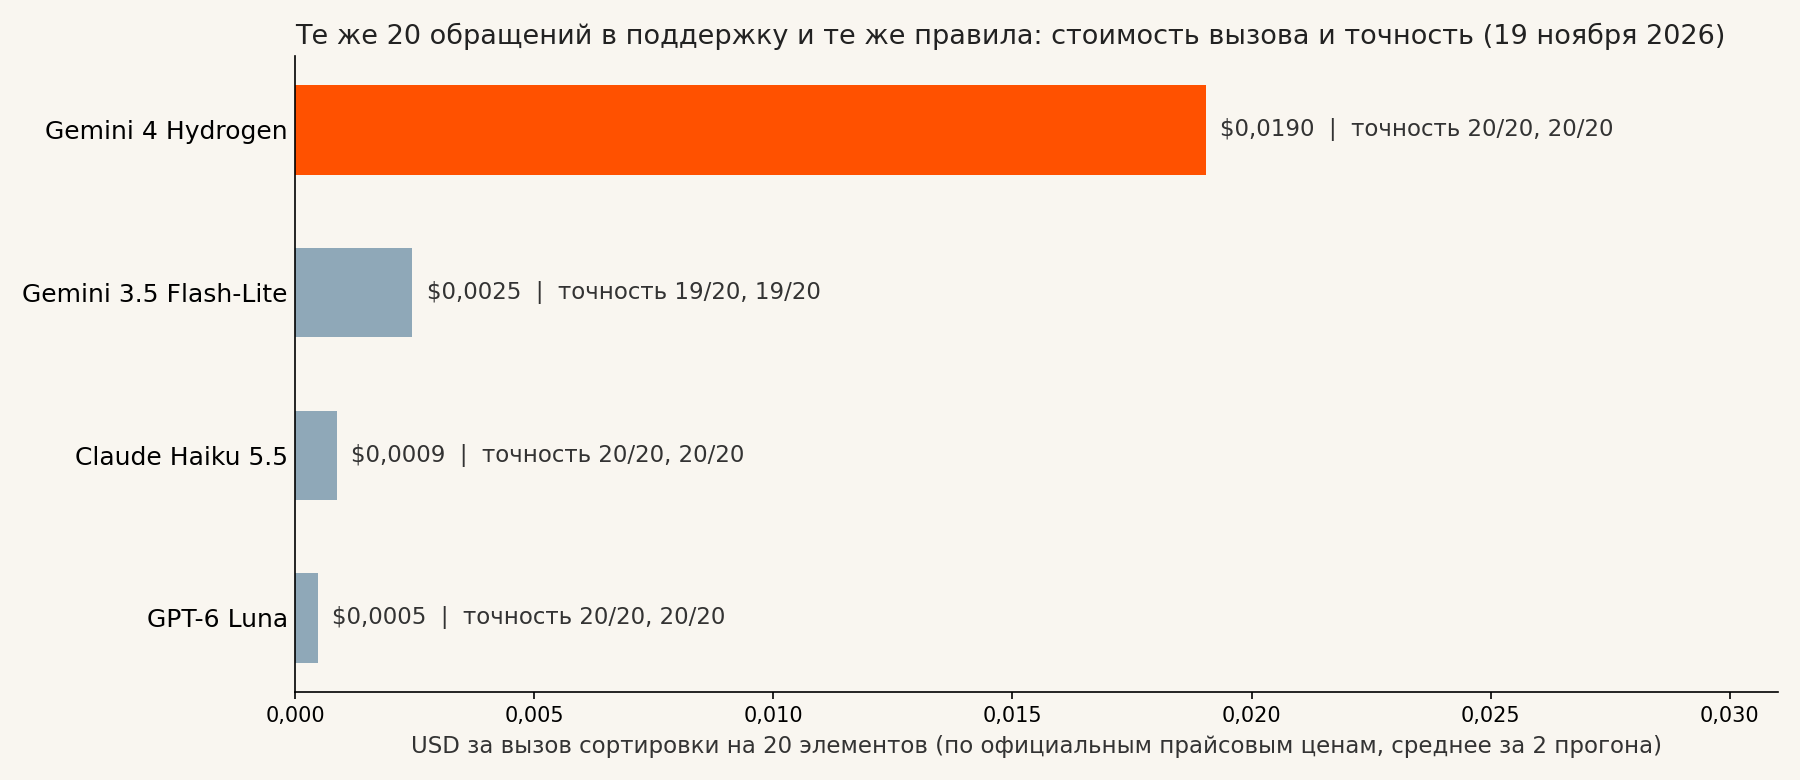
Диаграмма по данным наших прогонов 19 ноября 2026 года: среднее по двум вызовам сортировки на модель, по официальным прайсовым ценам вендоров. Это не счёт Ofox.
Точность и стоимость
| Модель | Точность сортировки (2 прогона) | Задачи на рассуждение | Средняя задержка сортировки | Среднее число выходных токенов на вызов сортировки (рассуждения) | Стоимость вызова сортировки | Та же ставка на 1000 сообщений |
|---|---|---|---|---|---|---|
| Gemini 4 Hydrogen | 20/20, 20/20 | 3/3 | 16,1 с | 2336 (≈1698) | $0,0190 | ≈$0,95 |
| Claude Haiku 5.5 | 20/20, 20/20 | 3/3 | 7,8 с | 1476 (≈831) | $0,00086 | ≈$0,043 |
| GPT-6 Luna | 20/20, 20/20 | 3/3 | 8,3 с | 780 (≈239) | $0,00048 | ≈$0,024 |
| Gemini 3.5 Flash-Lite | 19/20, 19/20 (по 59/60 полей) | 2/3 | 3,6 с | 861 (не сообщается) | $0,00245 | ≈$0,12 |
Стоимость — расчёт по официальным ценам: входные и выходные токены из каждого ответа, умноженные на ставки Standard из первой таблицы. Все промпты были намного короче 100K токенов, поэтому Haiku и Luna считались по нижнему тарифу. Задержка — реальное время от нашего клиента через Ofox до получения полного ответа без стриминга, включая сетевое время. Это не время до первого токена. Столбец «на 1000 сообщений» — просто измеренная стоимость пакета, умноженная на 50, при той же структуре промпта и без повторов.
Суммарно за все пять вызовов на модель вышло $0,0578 для Hydrogen, $0,0024 для Haiku, $0,0012 для Luna и $0,0071 для Flash-Lite. На этой нагрузке Hydrogen обошлась примерно в 24 раза дороже Haiku и в 46 раз дороже Luna. Её 15-кратная наценка за токен выросла, потому что на те же ответы она сгенерировала больше выходных токенов, в основном рассуждений.
Что показали прогоны:
- Дополнительные возможности Hydrogen не изменили результат. Hydrogen, Haiku и Luna правильно заполнили все поля в обоих прогонах сортировки и решили все три задачи на рассуждение. На чётко поставленной задаче с понятным сводом правил дешёвых моделей оказалось достаточно.
- Luna расходовала токены экономнее всех. Она сообщила примерно о 240 токенах рассуждений на вызов сортировки против примерно 1700 у Hydrogen и 830 у Haiku. Из-за разных токенизаторов число токенов у разных вендоров нельзя сравнивать идеально точно, но разница в стоимости возникает именно из этих чисел.
- Flash-Lite была самой быстрой и дважды ошиблась. В обоих прогонах сортировки для элемента 7 она вернула
ORD-77812— пятизначный номер, который по правилам нужно отклонить. В задаче о политике возвратов она насчитала от 10 октября до 15 ноября 21 день вместо 36 и одобрила возврат, который правило 30 дней должно было заблокировать. Flash-Lite не сообщила о токенах рассуждений. В руководстве Ofox по рассуждениям Gemini отмечено, что серия Flash-Lite по умолчанию не рассуждает. - Один вызов Haiku был медленным. Промпт о стоимости повторов занял 18,8 секунды; два других вызова на рассуждение — около 4 секунд. По одному прогону нельзя сказать, типично ли это.
Можно ли удешевить Hydrogen, понизив уровень рассуждений?
Google указывает, что low даёт минимальный расход токенов и задержку, поэтому мы повторили запрос сортировки на Hydrogen: дважды с запрошенным reasoning_effort: "low" на OpenAI-совместимом маршруте и дважды с запрошенным thinkingConfig.thinkingLevel: "low" на нативном маршруте Gemini в Ofox. Оба способа описаны в документации как способы задать уровень в Ofox. Оба маршрута приняли запрос (HTTP 200), но ни один ответ не указывает, какой уровень был применён, поэтому эффект настройки не подтверждён.
| Сортировка на Hydrogen, по 2 прогона | Точность | Токены рассуждений | Стоимость вызова по прайсу | Задержка |
|---|---|---|---|---|
| По умолчанию (без параметра) | 20/20, 20/20 | 1585 / 1811 | $0,0182 / $0,0199 | 16,2 / 16,1 с |
Запрошен reasoning_effort: "low" | 20/20, 20/20 | 1564 / 1650 | $0,0180 / $0,0187 | 15,8 / 17,1 с |
Запрошен нативный thinkingLevel: "low" | 20/20, 20/20 | 1478 / 1630 | $0,0174 / $0,0185 | 19,1 / 18,8 с |
На этом промпте запрос low почти не изменил ни число токенов рассуждений, ни стоимость, ни задержку. Уровень low был запрошен; его эффект не подтверждён. По ответу нельзя определить, применился ли уровень и модель просто сочла, что пакет из 20 элементов требует столько рассуждений, или настройка на этих маршрутах не применилась. В любом случае не рассчитывайте, что понижение уровня снизит стоимость Hydrogen до уровня Haiku или Luna. Измерьте на своих промптах. Подробнее об уровнях — в соседней статье об уровнях рассуждений Gemini 4.
Ограничения теста
Это иллюстрация, а не бенчмарк: 24 вызова, одна структура пакета, один свод правил и три промпта на рассуждение, всё за один день. Идеальный результат на 20 элементах говорит о том, что задача была этим моделям по силам, но не позволяет оценить долю ошибок. Мы не тестировали длинные документы, изображения, аудио, вызовы инструментов и многошаговых агентов — а именно там более высокий балл Hydrogen в AA, скорее всего, имеет значение. Задержка на маршруте Ofox может отличаться от прямого API каждого вендора. Весь тест, включая дополнительные прогоны, обошёлся примерно в $0,14 по официальным ценам.
Когда доплата за Hydrogen оправдана
Выбирайте по задаче, а не только по низкой цене за токен. С учётом документации, данных AA и наших прогонов:
Используйте Haiku 5.5 или Luna, когда задача короткая, чётко поставленная и проверяемая. Классификация, маршрутизация, извлечение полей по схеме, простые расчёты по заданным правилам. Обе модели были точны на нашем наборе, а вызов обходился примерно в 20–40 раз дешевле, чем у Hydrogen. Anthropic описывает Haiku 5.5 как модель, созданную “for high-volume, latency-sensitive tasks such as classification, extraction, and routing” (то есть для массовых задач, чувствительных к задержке, — классификации, извлечения и маршрутизации). Выбирайте между ними на собственной выборке: в нашем прогоне Luna израсходовала меньше всего токенов, а у Haiku балл AA выше и на настройках по умолчанию (25 против 18), и на максимальном effort (36 против 28). Приёмы извлечения на Luna — в статье структурированный вывод Luna для извлечения данных; пакетные задачи на Haiku — в сравнении Haiku 5.5 и 4.5 на пакетных задачах.
Платите за Hydrogen, когда задаче нужны рассуждения, инструменты или модальности, которых нет у маленьких моделей:
- Более сложная многошаговая работа. Балл Hydrogen в AA на
medium(41) выше, чем у Haiku наmax(36). Если маленькая модель на максимальном effort всё ещё не проходит ваши проверки, разумно следующим попробовать Hydrogen на пониженной настройке. Google позиционирует её для “everyday coding and agentic workflows” (повседневного программирования и агентных сценариев). - Аудио и видео на входе. В карточке модели Google для Hydrogen указаны входные текст, изображения, аудио и видео. Anthropic для своих текущих моделей указывает вход в виде текста и изображений; на странице модели Luna перечислены модальности текст и изображения.
- Длинные промпты. Ставка Hydrogen не зависит от длины промпта. Как только запрос превышает 100K токенов промпта, ставка Haiku вырастает в пять раз, и разрыв с Hydrogen сужается до 3×. Выше 272K вдвое дорожает вход Luna. Если большинство ваших запросов длинные, пересчитайте по повышенным тарифам.
- Бесплатное прототипирование в Google. Бесплатный уровень Hydrogen позволяет собрать прототип до оплаты — с учётом условий Google по использованию данных и лимитов проекта. См. наше руководство по бесплатному уровню API Gemini 4.
Используйте Gemini 3.5 Flash-Lite, когда нужна минимальная задержка у Google или недорогая обработка аудио и видео, а результаты можно проверить. Руководство Google по Hydrogen само рекомендует оставить 3.5 Flash-Lite “for high-volume classification, routing, and sub-second latency targets” (для массовой классификации, маршрутизации и целевой задержки меньше секунды). В нашем тесте она была самой быстрой, но нарушила строгое правило об ID и ошиблась в подсчёте дат, а её ставка за вывод в пять раз выше, чем у Haiku или Luna. Различия во входных форматах подробно разобраны в нашем более раннем сравнении Luna и Gemini 3.5 Flash-Lite на извлечении данных.
Практичный подход — маршрутизировать по сложности. Сначала отправляйте каждый элемент в Haiku или Luna. Проверяйте вывод по схеме и исходному тексту. В Hydrogen передавайте только ошибки, элементы с низкой уверенностью или длинные мультимодальные входы. Как посчитать такую схему, показано в нашем руководстве по стоимости одного правильного результата, а готовое правило эскалации — в статье пороги маршрутизации от Luna к Sol. Если вы выбираете между Hydrogen и следующим уровнем выше, см. соседнее сравнение Hydrogen, Claude Sonnet 5.5 и GPT-6.1 Terra, а для всей линейки — уровни моделей Gemini 4, Claude и GPT.
Как воспроизвести тест на своих данных
Для всех четырёх моделей мы использовали один ключ Ofox и OpenAI-совместимый маршрут Chat Completions, так что между моделями менялась только строка model. Минимальный запрос выглядит так:
curl https://api.ofox.io/v1/chat/completions \
  -H "Authorization: Bearer $OFOX_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "anthropic/claude-haiku-5.5",
    "max_tokens": 32000,
    "messages": [
      {"role": "system", "content": "<your rule sheet>"},
      {"role": "user", "content": "<your batch of items>"}
    ]
  }'
Подставьте google/gemini-4-hydrogen, openai/gpt-6-luna или google/gemini-3.5-flash-lite. Берите из каждого ответа usage.prompt_tokens, usage.completion_tokens и usage.completion_tokens_details.reasoning_tokens. У моделей Gemini токены completion уже включают токены рассуждений, поэтому не складывайте их дважды.
Наши материалы, чтобы вы могли повторить или адаптировать тест: полный тестовый набор со сводом правил, элементами и эталонными ответами, скрипт запуска, скрипт оценки и наши оценённые результаты с расходом по каждому вызову. Дополнительный прогон Hydrogen с низким уровнем рассуждений выполнен этим скриптом для нативного маршрута и оценён в results_extra.json. Скрипты используют только стандартную библиотеку Python и берут ключ из OFOX_API_KEY. Тестовый набор и промпты оставлены на английском, в том виде, в каком они отправлялись. Кратко:
- Свод правил (системный промпт, в оригинале на английском): пять категорий; номер заказа — первый
ORD-, за которым следуют ровно шесть цифр, в верхнем регистре, иначе null; refund равен true только при явной просьбе вернуть деньги; проблемы с доставкой относятся кshipping, даже если клиент просит возврат; страницы ошибок относятся кbug, даже на странице оплаты; при двух проблемах берётся первая. - Элементы сортировки и эталон, например: “Order ORD-77812 never arrived. I want my money back.” →
shipping,null,true; “The page shows ‘Error 502’ whenever I open billing settings.” →bug,null,false; “Tracking for ORD-55120 and ORD-551209 both show delivered, but only one box came.” →shipping,ORD-551209,false. - Промпты на рассуждение: 12 000 запросов по 1800 входных и 250 выходных токенов, $0,10 и $0,50 за миллион, 4% повторяются один раз (ответ $3.8064); тикет в пятницу в 15:00 с SLA 6 рабочих часов и тикет в понедельник в 22:30 с SLA 8 часов, рабочие часы понедельник–пятница 09:00–17:00 (понедельник 13:00; вторник 17:00); три запроса на возврат 15 ноября 2026 года по политике: 30 дней для неиспользованного товара, 90 дней для повреждённого, цифровой товар — только если его ни разу не скачивали (да, нет, да).
Как адаптировать:
- Составьте от 20 до 50 элементов, похожих на ваш реальный трафик, включая пограничные случаи, которые создают проблемы в продакшене. Эталонные ответы пишите до любого запуска.
- Запустите каждого кандидата на настройке по умолчанию, затем на уровень выше или ниже. Фиксируйте точность по каждому полю, а не только «валидный JSON».
- Считайте стоимость каждого вызова по фактическому расходу и официальным ставкам, включая повторы. Для крупной задачи проверьте, подходит ли пакетная обработка (Batch): у всех четырёх моделей ставки Batch вдвое ниже Standard.
- Выберите самую дешёвую модель, которая проходит ваш порог точности, и отправляйте её ошибки более сильной модели.
В руководстве Ofox по структурированному выводу показано, как запросить JSON с ограничением по схеме. Для массовых прогонов изучите документацию по лимитам запросов и стройте повторы по руководству по обработке ошибок. Если во время теста модель возвращает ошибки, частые причины по провайдерам разобраны в нашем руководстве по ошибкам API Gemini 4, в статьях как исправить Claude 529 overloaded (на английском) и ошибки OpenAI model-not-found (на английском).
Коротко
Hydrogen — сильная универсальная модель по средней цене. Для массовых простых задач это не бюджетный вариант: на нашем наборе для сортировки она сравнялась с Haiku 5.5 и Luna по точности, а стоила в 24–46 раз дороже. Её наценка оправдана, когда задача настолько сложна, что маленькие модели не проходят ваши проверки, когда нужен вход в виде аудио или видео или когда запросы регулярно выходят за ценовые границы Haiku (100K) или Luna (272K). Собственный недорогой вариант Gemini от Google — 3.5 Flash-Lite. Она оказалась самой быстрой из протестированных, но по цене за токен всё равно дороже Haiku и Luna.
Документация
- Gemini 4 Hydrogen в Ofox (поддерживаемые протоколы и текущая цена Ofox)
- Claude Haiku 5.5 в Ofox
- GPT-6 Luna в Ofox
- Gemini 3.5 Flash-Lite в Ofox
- Настройки рассуждений Gemini
- Нативный API Gemini
- Структурированный вывод
- Лимиты запросов и обработка ошибок
Часто задаваемые вопросы
- Переводит ли большой пакетный запуск Claude Haiku 5.5 на более высокий тариф?
- Нет. Anthropic тарифицирует каждый запрос по длине его собственного промпта. Повышенные ставки платит только отдельный запрос, промпт которого (включая чтение и запись кэша) превышает 100 000 токенов, и тогда повышенные ставки применяются ко всему запросу, включая вывод.
- Можно ли запустить Gemini 4 Hydrogen с выключенными рассуждениями?
- Google описывает для Hydrogen четыре уровня рассуждений (low, medium, high и xhigh, по умолчанию high), и ни один из них не описан как выключение. В нашем тесте сортировки мы запросили low на двух маршрутах; применился ли этот уровень, не подтверждено, а число токенов рассуждений в ответах на этом промпте почти не изменилось.