Gemini 4 Hydrogen은 저가 모델일까? Claude Haiku 5.5·GPT-6 Luna와 비용 비교
Hydrogen의 토큰당 정가는 Haiku 5.5와 Luna의 15배입니다. 공식 요금, Artificial Analysis의 작업당 비용, 24회 호출 분류 테스트로 추가 비용이 값어치를 하는 경우를 정리합니다.
 Ofox
아닙니다. Gemini 4 Hydrogen은 Google의 중간 가격대 범용 모델이며, 저가 등급이 아닙니다. Google 유료 Standard 요금 기준으로 입력 100만 토큰당 1.50달러, 출력 100만 토큰당 7.50달러로, Claude Haiku 5.5와 GPT-6 Luna의 짧은 프롬프트 요금(둘 다 0.10달러와 0.50달러)의 15배입니다. 작업 하나를 끝내는 비용으로 보면 차이는 더 커질 수 있습니다. Hydrogen은 기본적으로 high 수준으로 사고하기 때문에 같은 작업에 출력 토큰을 더 많이 씁니다. Google 자체 가이드도 대량 분류와 라우팅에는 Hydrogen이 아니라 Gemini 3.5 Flash-Lite를 권합니다.
그렇다고 Hydrogen이 나쁜 선택이라는 뜻은 아닙니다. Artificial Analysis의 Intelligence Index에서 Hydrogen은 기본 설정의 Haiku 5.5와 Luna보다 대략 두 배 높은 점수를 받습니다. 다만 단순하고 조건이 명확한 분류 작업에서는 이 추가 성능으로 결과가 달라지지 않았습니다. 저희 테스트에서 Haiku와 Luna도 똑같이 정확했고 비용은 훨씬 적었습니다.
이 글은 Ofox가 게시합니다. 2026년 11월 19일 확인 당시 글에 나오는 네 모델 모두 Ofox로 호출할 수 있었습니다. 아래 모든 내용에는 세 가지 출처 중 하나를 표시했습니다. 공식 문서(2026년 11월 19일 확인), Artificial Analysis 데이터(2026년 11월 19일 수집), 같은 날 Ofox를 통해 실행한 소규모 자체 테스트입니다. 테스트의 달러 금액은 각 벤더의 공식 정가로 저희가 계산한 값이며, Ofox 청구액이 아닙니다. Ofox 자체 요금은 글 끝에 링크한 각 모델 페이지에 나와 있습니다.
같은 기준으로 맞춘 공식 정가
모든 요금은 100만 토큰당 미국 달러이며, 유료 Standard 등급, 각 벤더의 자체 API 기준입니다. 네 모델 모두 출력 요금에 사고 또는 추론 토큰이 포함됩니다.
| 모델(API ID) | 입력 | 출력 | 캐시 입력 | 요금 조건 | Batch 입력 / 출력 |
|---|---|---|---|---|---|
Gemini 4 Hydrogen(gemini-4-hydrogen) | $1.50 | $7.50 | $0.075(암시적 캐시만) | 프롬프트 길이와 관계없이 단일 요금 | $0.75 / $3.75 |
Claude Haiku 5.5(claude-haiku-5-5) | $0.10 | $0.50 | 읽기 $0.01, 5분 쓰기 $0.125 | 프롬프트 ≤100,000토큰 | $0.05 / $0.25 |
| Claude Haiku 5.5, 프롬프트 >100K | $0.50 | $2.50 | 읽기 $0.05, 5분 쓰기 $0.625 | 요청 전체에 적용 | $0.25 / $1.25 |
GPT-6 Luna(gpt-6-luna) | $0.10 | $0.50 | $0.01 | 입력 ≤272K토큰 | $0.05 / $0.25 |
| GPT-6 Luna, 입력 >272K | $0.20 | $0.75 | $0.02 | 요청 전체에 적용 | $0.10 / $0.375 |
Gemini 3.5 Flash-Lite(gemini-3.5-flash-lite) | $0.30 | $2.50 | $0.03 + 저장 비용 100만 토큰·시간당 $1.00 | 단일 요금 | $0.15 / $1.25 |
출처: Google Gemini API 요금(영어), Anthropic 요금(영어), OpenAI 요금(영어), GPT-6 Luna 모델 페이지(영어).
비교 결과를 바꾸는 것은 15배라는 대표 비율보다 다음 세 가지 세부 사항입니다.
Haiku 5.5의 낮은 요금에는 상한선이 있습니다. Anthropic은 Haiku 5.5의 요금을 프롬프트 길이에 따라 매깁니다. 프롬프트가 100,000토큰을 넘는 요청은 기본 요금의 다섯 배를 내며, 이는 출력을 포함한 요청 전체에 적용됩니다. 캐시 읽기와 캐시 쓰기도 이 100K에 포함됩니다. 이 선을 넘으면 Hydrogen은 Haiku의 15배가 아니라 3배에 그칩니다. 경계 계산은 Haiku 5.5 100K 요금 가이드에서 구체적인 숫자로 설명합니다. Luna도 입력 272K토큰에서 비슷한 단계가 있습니다. Hydrogen의 요금표에는 긴 컨텍스트 구간이 없습니다.
Hydrogen에는 무료 등급이 있습니다. Anthropic과 OpenAI의 요금 페이지에는 Haiku 5.5와 Luna의 유료 요금만 나와 있습니다. Google은 무료 등급에서 Hydrogen과 3.5 Flash-Lite를 모두 무료로 표시하므로 프로토타입을 만들 때 유용합니다. 다만 Google 표에는 무료 등급 콘텐츠가 Google 제품 개선에 사용된다고 적혀 있으며, 이용 가능 여부는 프로젝트 자격과 한도에 따라 달라집니다. 확인 방법과 할당량은 Hydrogen 설정 가이드에서 다룹니다.
Flash-Lite는 Hydrogen보다 저렴하지만 Haiku나 Luna보다 저렴하지는 않습니다. 입력 요금은 두 모델의 3배, 출력 요금은 5배입니다. Google 라인업 안에서는 저비용 선택지이지만, 다른 벤더와 비교하면 가장 저렴하지 않습니다.
작업 하나에 실제로 드는 비용: Artificial Analysis 데이터
토큰당 가격에는 각 모델이 토큰을 얼마나 쓰는지가 빠져 있습니다. Artificial Analysis(AA, 영어)는 각 모델에서 Intelligence Index 평가를 실행하고, 모델이 실제로 사용한 토큰과 해당 모델의 요금으로 계산한 작업당 가중 평균 비용을 공개합니다. 저희는 2026년 11월 19일에 네 모델의 페이지를 가져왔습니다. 첫 번째 표는 각 벤더가 문서에 밝힌 기본 설정을 씁니다. Hydrogen은 high 사고(Google Hydrogen 가이드, 영어), Haiku 5.5는 medium effort(Anthropic 모델 개요, 영어), Luna는 medium(OpenAI 모델 페이지)입니다.
AA의 렌더링된 페이지에는 각 모델의 최상위 설정에 대한 작업당 비용만 표시됩니다. 다른 설정의 작업당 비용은 같은 페이지의 기반 데이터에서 가져왔습니다. 이 데이터에서는 각 비용에 해당 변형 태그(예: claude-haiku-5-5-medium, gemini-4-hydrogen-high)가 붙어 있으므로, 아래 effort 표기는 저희가 짝지은 것이 아니라 AA가 직접 붙인 것입니다. 각 표기의 인덱스 점수는 렌더링된 페이지와 일치합니다.
| 기본 설정의 모델 | AA Intelligence Index | AA Index 작업당 비용 | AA 출력 속도 |
|---|---|---|---|
| Gemini 4 Hydrogen(high) | 51 | $1.87 | 초당 165토큰 |
| Claude Haiku 5.5(medium) | 25 | $0.092 | 초당 222토큰 |
| GPT-6 Luna(medium) | 18 | $0.042 | 초당 96토큰 |
| Gemini 3.5 Flash-Lite(변형 하나만 게재) | 12 | $0.69 | 초당 318토큰 |
기본 설정에서 AA 작업당 비용은 Hydrogen이 Haiku의 약 20배, Luna의 약 44배입니다. 두 차이 모두 토큰 가격 비율인 15배보다 큰데, high의 Hydrogen이 작업당 더 많은 토큰을 만들어 내기 때문입니다. 성능 차이도 같은 방향입니다. Hydrogen의 인덱스 점수는 Haiku의 약 두 배, Luna의 세 배에 가깝습니다.
저렴한 모델의 effort를 올리면 양상이 달라집니다.
| 게재된 최고 설정 | AA Intelligence Index | AA Index 작업당 비용 |
|---|---|---|
| Gemini 4 Hydrogen(xhigh) | 54 | $3.16 |
| Claude Haiku 5.5(max) | 36 | $0.41 |
| GPT-6 Luna(max) | 28 | $0.15 |
최고 설정에서는 Haiku와의 차이가 약 7.7배로 줄어듭니다. max의 Haiku가 토큰을 훨씬 많이 쓰기 때문입니다. Luna는 여전히 약 21배 저렴합니다. 하지만 max로 올려도 두 모델 모두 medium의 Hydrogen 점수(AA 페이지 기준 41)에 미치지 못합니다. AA 페이지 데이터에서 medium의 Hydrogen은 작업당 0.80달러로, max의 Haiku(0.41달러)의 약 두 배 비용에 점수는 5점 높습니다. 워크로드가 AA의 어려운 추론·에이전트 작업과 비슷하다면, 작은 모델을 한계까지 끌어올리는 것보다 낮은 설정의 Hydrogen이 더 나은 선택일 수 있습니다.
이 숫자를 읽을 때는 다음 한계를 염두에 두세요.
- AA 인덱스는 어려운 평가들의 묶음입니다. 25점이라고 해서 Haiku가 여러분의 추출 작업 중 4분의 3에서 실패한다는 뜻은 아닙니다. 아래 테스트에서 Haiku와 Luna는 규칙 기반의 단순한 작업에서 완전히 정확했습니다.
- AA의 속도 수치는 AA 자체 측정값입니다.
high의 Hydrogen이 첫 답변 토큰까지 걸린 시간은 19.4초로 게재돼 있으며,medium의 Haiku는 9.1초,medium의 Luna는 5.3초입니다. 이 시간에는 사고 시간이 포함됩니다. - AA의 Flash-Lite 작업당 비용(0.69달러)은 ‘요청당’ 비용으로 비교하기에 적절하지 않습니다. AA 자체 내역에서 이 금액의 대부분은 출력이 아니라 캐시 관련 입력 비용입니다. 짧은 일회성 요청에서는 테스트 결과에서 보듯 Flash-Lite가 Hydrogen보다 비용이 적게 들었습니다.
자체 테스트: 분류 20건과 짧은 추론 문제 3개
이 숫자들이 사람들이 실제로 저가 모델을 쓰는 작업, 즉 짧은 항목이 많고 규칙표가 고정돼 있으며 JSON으로 답하는 작업에서 무엇을 뜻하는지 확인하고 싶었습니다. 2026년 11월 19일, Ofox의 OpenAI 호환 엔드포인트(https://api.ofox.io/v1/chat/completions)로 같은 프롬프트를 다음 모델 ID로 실행했습니다: google/gemini-4-hydrogen, anthropic/claude-haiku-5.5, openai/gpt-6-luna, google/gemini-3.5-flash-lite.
설정. 모델 기본 설정을 썼습니다. temperature도, 사고나 추론 파라미터도 지정하지 않았습니다. 지정한 파라미터는 지출 상한으로 둔 max_tokens: 32000 하나뿐이며, 이 상한에 도달한 응답은 없었습니다(finish_reason은 모두 stop).
워크로드 A: 분류. 고객 지원 메시지 20건을 요청 하나에 담았습니다. 모델은 메시지마다 category(5개 클래스), order_id(첫 번째로 유효한 ORD-와 6자리 숫자, 대문자로 변환, 없으면 null), refund(환불을 명시적으로 요청한 경우에만 true)를 반환합니다. 정답표는 어떤 모델도 호출하기 전에 작성했습니다. 몇몇 항목에는 일부러 함정을 넣었습니다. 거부해야 하는 5자리 주문 ID, 헷갈리게 하는 전화번호와 티켓 번호, “환불을 요청하는 것은 아니다”라는 명시적 문장, 스페인어 메시지, 비꼬는 표현, 결제 화면에 나타나지만 실제로는 버그인 오류 페이지, 그리고 두 가지 문제가 있어 첫 번째 문제로 판단해야 하는 메시지입니다. 각 모델로 이 요청을 두 번 실행했습니다.
워크로드 B: 추론. 확인 가능한 정답이 하나씩 있는 독립 프롬프트 3개입니다. 재시도 비용 계산(정답: $3.8064), 영업시간 기준 SLA 마감 시각 두 개(월요일 13:00, 화요일 17:00), 날짜 계산이 필요한 환불 정책 판단 세 건(예, 아니요, 예)입니다. 각각 한 번씩 실행했습니다.
전체 프롬프트, 규칙표, 정답표, 실행 스크립트, 채점 스크립트는 아래 재현 섹션에 링크해 두었습니다.
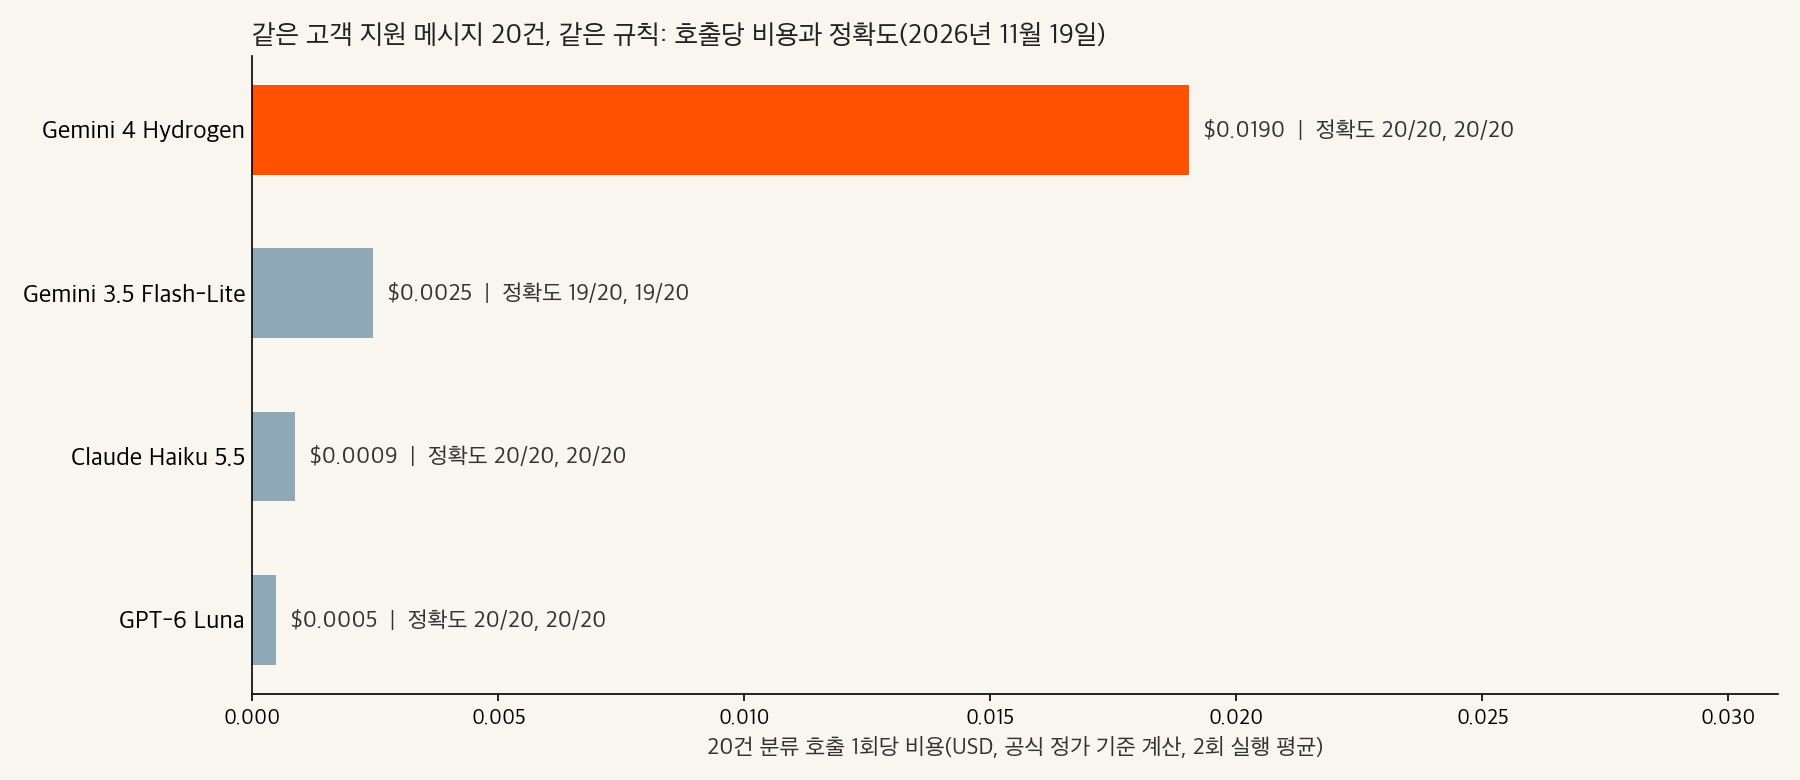
그래프는 2026년 11월 19일 실행 결과로, 모델별 분류 호출 2회의 평균을 벤더 공식 정가로 계산했습니다. Ofox 청구액이 아닙니다.
정확도와 비용 결과
| 모델 | 분류 정확도(2회) | 추론 문제 | 분류 평균 지연 시간 | 분류 호출당 평균 출력 토큰(사고) | 분류 호출당 비용 | 같은 요금으로 메시지 1,000건당 |
|---|---|---|---|---|---|---|
| Gemini 4 Hydrogen | 20/20, 20/20 | 3/3 | 16.1초 | 2,336(≈1,698) | $0.0190 | ≈$0.95 |
| Claude Haiku 5.5 | 20/20, 20/20 | 3/3 | 7.8초 | 1,476(≈831) | $0.00086 | ≈$0.043 |
| GPT-6 Luna | 20/20, 20/20 | 3/3 | 8.3초 | 780(≈239) | $0.00048 | ≈$0.024 |
| Gemini 3.5 Flash-Lite | 19/20, 19/20(각 59/60 필드) | 2/3 | 3.6초 | 861(보고 없음) | $0.00245 | ≈$0.12 |
비용은 공식 정가로 계산했습니다. 각 응답에 보고된 입력·출력 토큰에 첫 번째 표의 자체 API Standard 요금을 곱한 값입니다. 모든 프롬프트가 100K토큰보다 훨씬 짧았으므로 Haiku와 Luna는 낮은 구간 요금으로 계산했습니다. 지연 시간은 저희 클라이언트에서 Ofox를 거쳐 스트리밍하지 않은 응답을 끝까지 받기까지 걸린 실제 시간이며, 네트워크 시간이 포함됩니다. 첫 토큰까지의 시간이 아닙니다. ‘1,000건당’ 열은 측정한 배치 비용에 50을 곱한 값일 뿐이며, 같은 프롬프트 구조에 재시도가 없다고 가정합니다.
모델별 호출 5회를 모두 합하면 Hydrogen $0.0578, Haiku $0.0024, Luna $0.0012, Flash-Lite $0.0071이었습니다. 이 워크로드에서 Hydrogen의 비용은 Haiku의 약 24배, Luna의 46배였습니다. 15배였던 토큰 가격 차이가 더 벌어진 것은 같은 답을 내면서 출력 토큰, 주로 사고 토큰을 더 많이 생성했기 때문입니다.
실행 결과에서 확인한 점은 다음과 같습니다.
- Hydrogen의 추가 성능은 결과를 바꾸지 못했습니다. Hydrogen, Haiku, Luna 세 모델 모두 두 번의 분류에서 모든 필드를 맞혔고 추론 문제 3개도 모두 맞혔습니다. 규칙표가 명확하고 조건이 잘 정해진 작업에서는 저렴한 모델로 충분했습니다.
- 토큰 효율은 Luna가 가장 높았습니다. 분류 호출당 추론 토큰이 약 240개로, Hydrogen 약 1,700개, Haiku 약 830개보다 적었습니다. 토크나이저가 달라서 벤더 간 토큰 수를 완벽하게 비교할 수는 없지만, 비용 차이는 이 토큰 수에서 나옵니다.
- Flash-Lite는 가장 빨랐지만 두 군데서 틀렸습니다. 두 번의 분류 모두 7번 항목에
ORD-77812를 반환했는데, 이는 규칙상 거부해야 하는 5자리 ID입니다. 환불 정책 문제에서는 10월 10일부터 11월 15일까지를 36일이 아니라 21일로 계산했고, 30일 규칙에 따라 막아야 할 환불을 승인했습니다. Flash-Lite는 추론 토큰을 보고하지 않았습니다. Ofox의 Gemini 사고 가이드에 따르면 Flash-Lite 시리즈는 기본적으로 사고하지 않습니다. - Haiku 호출 한 번이 느렸습니다. 재시도 비용 프롬프트는 18.8초가 걸렸고, 나머지 추론 호출 두 번은 각각 약 4초였습니다. 한 번의 실행으로는 이것이 일반적인지 알 수 없습니다.
사고 수준을 낮추면 Hydrogen이 저렴해질까?
Google은 low가 토큰 사용량과 지연 시간이 가장 적다고 설명합니다. 그래서 Hydrogen으로 분류 요청을 다시 실행했습니다. OpenAI 호환 경로에서 reasoning_effort: "low"를 요청해 두 번, Ofox의 Gemini 네이티브 경로에서 thinkingConfig.thinkingLevel: "low"를 요청해 두 번입니다. 둘 다 Ofox에서 수준을 지정하는 방법으로 문서화돼 있습니다. 두 경로 모두 요청을 받아들였지만(HTTP 200), 어느 응답에도 실제로 적용된 수준이 나와 있지 않아 설정의 효과는 확인되지 않았습니다.
| Hydrogen 분류, 각 2회 | 정확도 | 사고 토큰 | 호출당 정가 기준 비용 | 지연 시간 |
|---|---|---|---|---|
| 기본값(파라미터 없음) | 20/20, 20/20 | 1,585 / 1,811 | $0.0182 / $0.0199 | 16.2 / 16.1초 |
reasoning_effort: "low" 요청 | 20/20, 20/20 | 1,564 / 1,650 | $0.0180 / $0.0187 | 15.8 / 17.1초 |
네이티브 thinkingLevel: "low" 요청 | 20/20, 20/20 | 1,478 / 1,630 | $0.0174 / $0.0185 | 19.1 / 18.8초 |
이 프롬프트에서는 low를 요청해도 사고 토큰, 비용, 지연 시간이 거의 달라지지 않았습니다. low는 요청했지만 그 효과는 확인되지 않았습니다. 응답만으로는 수준이 적용된 상태에서 모델이 20건 배치에 그만큼의 사고가 필요하다고 판단한 것인지, 이 경로에서 설정이 적용되지 않은 것인지 구별할 수 없습니다. 어느 쪽이든 수준을 낮추면 Hydrogen의 비용이 Haiku나 Luna 수준까지 내려간다고 가정하지 마세요. 자신의 프롬프트로 측정해야 합니다. 각 수준은 관련 글 Gemini 4 사고 수준에서 더 자세히 다룹니다.
이 테스트의 한계
이 테스트는 예시이지 벤치마크가 아닙니다. 호출 24회, 배치 형태 하나, 규칙표 하나, 추론 프롬프트 3개를 모두 하루에 실행했습니다. 20건 만점은 이 작업이 해당 모델들의 능력 범위 안에 있었다는 뜻일 뿐, 오류율을 보여 주지는 않습니다. 긴 문서, 이미지, 오디오, 도구 호출, 다단계 에이전트는 테스트하지 않았으며, Hydrogen의 높은 AA 점수가 가장 의미를 가질 만한 영역이 바로 이런 곳입니다. Ofox 경로의 지연 시간은 각 벤더 API에 직접 연결할 때와 다를 수 있습니다. 추가 실행을 포함한 전체 테스트 비용은 공식 정가 기준 약 $0.14였습니다.
Hydrogen의 추가 비용이 값어치를 하는 경우
토큰당 가격이 낮다는 이유만으로 정하지 말고 작업에 맞춰 고르세요. 문서, AA 데이터, 저희 실행 결과를 바탕으로 정리하면 다음과 같습니다.
작업이 짧고 조건이 명확하며 검증할 수 있다면 Haiku 5.5나 Luna를 쓰세요. 분류, 라우팅, 스키마에 맞춘 필드 추출, 규칙이 주어진 간단한 계산 등입니다. 두 모델 모두 저희 테스트 세트에서 정확했고, 호출당 비용은 Hydrogen의 약 1/20에서 1/40이었습니다. Anthropic은 Haiku 5.5를 “for high-volume, latency-sensitive tasks such as classification, extraction, and routing”(분류, 추출, 라우팅처럼 처리량이 많고 지연 시간에 민감한 작업용)으로 만든 모델이라고 설명합니다. 둘 중 무엇을 고를지는 자신의 샘플로 판단하세요. 저희 실행에서는 Luna가 토큰을 가장 적게 썼고, AA 점수는 기본 설정(25 대 18)과 최대 effort(36 대 28) 모두 Haiku가 높았습니다. Luna 추출 패턴은 Luna 구조화 출력으로 데이터 추출하기, Haiku 처리량 작업은 Haiku 5.5와 4.5 배치 작업 비교를 참고하세요.
작은 모델에 없는 추론력, 도구, 모달리티가 필요한 작업이라면 Hydrogen에 비용을 쓰세요.
- 더 어려운 다단계 작업.
medium의 Hydrogen AA 점수(41)는max의 Haiku 점수(36)보다 높습니다. 작은 모델을 최대 effort로 올려도 검증을 통과하지 못한다면, 다음으로 낮은 설정의 Hydrogen을 시험해 볼 만합니다. Google은 Hydrogen을 “everyday coding and agentic workflows”(일상적인 코딩과 에이전트 워크플로)용으로 소개합니다. - 오디오·비디오 입력. Google 모델 카드에는 Hydrogen의 입력으로 텍스트, 이미지, 오디오, 비디오가 나와 있습니다. Anthropic은 현재 모델의 입력으로 텍스트와 이미지를 제시하고, Luna 모델 페이지에도 텍스트와 이미지 모달리티가 나와 있습니다.
- 긴 프롬프트. Hydrogen의 요금은 프롬프트 길이에 따라 바뀌지 않습니다. 요청의 프롬프트가 100K토큰을 넘으면 Haiku 요금이 다섯 배로 오르고 Hydrogen과의 차이는 3배로 좁혀집니다. 272K를 넘으면 Luna의 입력 요금이 두 배가 됩니다. 요청 대부분이 길다면 높은 구간 요금으로 다시 계산하세요.
- Google에서 무료로 프로토타입 만들기. Hydrogen 무료 등급을 쓰면 비용을 내기 전에 먼저 만들어 볼 수 있습니다. 단, Google의 데이터 사용 약관과 프로젝트 한도가 적용됩니다. Gemini 4 무료 API 등급 가이드를 참고하세요.
Google에서 가장 낮은 지연 시간이 필요하거나 오디오·비디오 입력을 저렴하게 처리하고 싶고, 출력을 검증할 수 있다면 Gemini 3.5 Flash-Lite를 쓰세요. Google의 Hydrogen 가이드 자체가 3.5 Flash-Lite를 “for high-volume classification, routing, and sub-second latency targets”(대량 분류, 라우팅, 1초 미만 지연 시간 목표용)으로 계속 쓰라고 권합니다. 저희 테스트에서 가장 빠른 모델이었지만 엄격한 ID 규칙 하나와 날짜 계산 하나를 놓쳤고, 출력 요금은 Haiku나 Luna의 다섯 배입니다. 입력 형식 차이는 이전 글 Luna와 Gemini 3.5 Flash-Lite 추출 비교에서 자세히 다룹니다.
실용적인 방법은 난이도에 따라 라우팅하는 것입니다. 모든 항목을 먼저 Haiku나 Luna로 보내고, 출력을 스키마와 원문에 비춰 검증합니다. 실패한 항목, 신뢰도가 낮은 항목, 긴 멀티모달 입력만 Hydrogen으로 올립니다. 비용 계산 방법은 정답 1건당 비용 가이드에서, 구체적인 에스컬레이션 규칙은 Luna에서 Sol로 라우팅하는 기준에서 볼 수 있습니다. Hydrogen과 한 단계 위 등급 사이에서 고민한다면 관련 비교 글 Hydrogen, Claude Sonnet 5.5, GPT-6.1 Terra 비교를, 전체 라인업은 Gemini 4·Claude·GPT 모델 등급 비교를 참고하세요.
자신의 데이터로 테스트 재현하기
저희는 네 모델 모두 Ofox 키 하나와 OpenAI 호환 Chat Completions 경로를 사용했으므로, 모델 간에 바뀐 것은 model 문자열뿐이었습니다. 최소 요청은 다음과 같습니다.
curl https://api.ofox.io/v1/chat/completions \
  -H "Authorization: Bearer $OFOX_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "anthropic/claude-haiku-5.5",
    "max_tokens": 32000,
    "messages": [
      {"role": "system", "content": "<your rule sheet>"},
      {"role": "user", "content": "<your batch of items>"}
    ]
}'google/gemini-4-hydrogen, openai/gpt-6-luna, google/gemini-3.5-flash-lite로 바꿔 실행합니다. 각 응답에서 usage.prompt_tokens, usage.completion_tokens, usage.completion_tokens_details.reasoning_tokens를 읽습니다. Gemini 모델에서는 completion 토큰에 이미 추론 토큰이 포함돼 있으므로 두 번 더하지 마세요.
다시 실행하거나 응용할 수 있도록 자료를 공개합니다. 규칙표, 항목, 정답표가 들어 있는 테스트 세트, 실행 스크립트, 채점 스크립트, 호출별 사용량이 포함된 채점 결과입니다. Hydrogen 낮은 사고 수준 추가 실행에는 이 네이티브 경로 스크립트를 썼고, 결과는 results_extra.json에서 채점했습니다. 스크립트는 Python 표준 라이브러리만 사용하며 키는 OFOX_API_KEY에서 읽습니다. 테스트 세트와 프롬프트는 전송한 그대로 영어로 남겨 두었습니다. 요약하면 다음과 같습니다.
- 규칙표(시스템 프롬프트, 원문은 영어): 카테고리 다섯 개. 주문 ID는
ORD-뒤에 정확히 6자리 숫자가 붙은 첫 번째 값을 대문자로, 없으면 null. refund는 환불을 명시적으로 요청한 경우에만 true. 배송 문제는 환불을 요청해도shipping. 오류 페이지는 결제 페이지에서 나타나도bug. 문제가 두 개면 첫 번째를 사용. - 분류 항목과 정답 예: “Order ORD-77812 never arrived. I want my money back.” →
shipping,null,true; “The page shows ‘Error 502’ whenever I open billing settings.” →bug,null,false; “Tracking for ORD-55120 and ORD-551209 both show delivered, but only one box came.” →shipping,ORD-551209,false. - 추론 프롬프트: 입력 1,800토큰·출력 250토큰짜리 요청 12,000건, 100만 토큰당 0.10달러와 0.50달러, 4%는 한 번씩 재시도(정답 $3.8064). 금요일 15:00에 접수된 영업시간 6시간 SLA 티켓과 월요일 22:30에 접수된 8시간 SLA 티켓, 영업시간은 월
금 09:0017:00(월요일 13:00, 화요일 17:00). 2026년 11월 15일에 들어온 환불 요청 세 건에 미사용 30일·파손 90일·디지털 상품은 미다운로드 시만 허용하는 정책 적용(예, 아니요, 예).
응용하는 방법:
- 실제 트래픽과 비슷한 항목을 20~50건 만들고, 운영 환경에서 문제가 되는 예외 사례도 넣습니다. 무엇이든 실행하기 전에 정답표부터 작성하세요.
- 후보 모델마다 기본 설정으로 실행한 뒤, 한 단계 높거나 낮은 설정으로 실행합니다. ‘유효한 JSON인지’만이 아니라 필드별 정확도를 기록하세요.
- 재시도를 포함해 호출마다 보고된 사용량과 공식 요금으로 비용을 계산합니다. 대규모 작업이라면 Batch 처리가 맞는지 확인하세요. 네 모델 모두 Batch 요금이 Standard의 절반입니다.
- 정확도 기준을 충족하는 가장 저렴한 모델을 고르고, 그 모델이 실패한 항목은 더 강한 모델로 보냅니다.
스키마로 제약한 JSON을 요청하는 방법은 Ofox 구조화 출력 가이드에 나와 있습니다. 대량으로 실행할 때는 속도 제한 문서를 확인하고, 오류 처리 가이드를 바탕으로 재시도를 구성하세요. 테스트 중 모델이 오류를 반환한다면 Gemini 4 API 오류 가이드, Claude 529 overloaded 해결법(영어), OpenAI model-not-found 오류 해결(영어)에서 벤더별 흔한 원인을 다룹니다.
요약
Hydrogen은 중간 가격대의 유능한 범용 모델입니다. 대량의 단순 작업에서는 저가 선택지가 아닙니다. 저희 분류 테스트 세트에서 정확도는 Haiku 5.5, Luna와 같았지만 비용은 24~46배였습니다. 작은 모델이 검증을 통과하지 못할 만큼 어려운 작업, 오디오나 비디오 입력이 필요한 작업, Haiku의 100K나 Luna의 272K 요금 기준선을 자주 넘는 작업이라면 그 추가 비용이 납득됩니다. Google 자체의 저비용 Gemini 선택지는 3.5 Flash-Lite입니다. 저희가 테스트한 모델 중 가장 빨랐지만, 토큰당 가격으로는 여전히 Haiku와 Luna보다 비쌉니다.
관련 문서
자주 묻는 질문
- 대량 배치 작업을 돌리면 Claude Haiku 5.5가 더 높은 요금 구간으로 넘어가나요?
- 아닙니다. Anthropic은 요청마다 그 요청의 프롬프트 길이로 요금을 매깁니다. 프롬프트(캐시 읽기와 쓰기 포함)가 100,000토큰을 넘는 개별 요청만 높은 요금을 내며, 이때 높은 요금은 출력을 포함한 해당 요청 전체에 적용됩니다.
- Gemini 4 Hydrogen에서 사고 기능을 끌 수 있나요?
- Google은 Hydrogen의 사고 수준으로 네 가지(low, medium, high, xhigh, 기본값은 high)를 문서화했으며, 어느 것도 사고를 끄는 설정으로 설명하지 않습니다. 저희 분류 테스트에서는 두 경로에서 low를 요청했습니다. 이 수준이 실제로 적용됐는지는 확인되지 않았고, 이 프롬프트에서 보고된 사고 토큰도 거의 달라지지 않았습니다.