싼 LLM으로 충분할까? 7개 모델의 정답 1건당 비용 실측
7개 모델에 같은 작업을 맡기고 86건의 API 호출로 정답 1건에 실제 청구된 비용을 비교했습니다. 빈 응답도 과금되는 함정과 검증 후 상위 모델로 넘기는 스크립트도 다룹니다.
 Ofox
이번에 테스트한 일상 작업에서는 가장 싼 모델이 가장 비싼 모델과 같은 답을 모두 맞혔고, 청구 비용은 회의록 처리에서 75분의 1, 버그 수정에서 45분의 1이었습니다. 하지만 더 어려운 작업에서는 토큰 단가가 싸다고 결과 1건당 비용이 싸지지 않았습니다. DeepSeek V4.1 Flash와 Qwen 3.8 Flash는 출력 예산을 전부 생각하는 데 써 버려 아무것도 반환하지 않은 경우가 있었고, 그 토큰도 과금되었습니다. 따라서 비교해야 할 것은 정답 1건에 드는 비용이며, 결과를 믿기 전에 먼저 검증해야 합니다.
이 글은 영상 해설의 글 버전입니다. 영상 진행자 Marie는 AI로 생성한 프레젠터입니다. 모든 테스트는 ofox 팀이 설계하고 2026년 10월 20일부터 21일까지 직접 실행했으며, 각 호출을 ofox 청구 내역과 대조했습니다. 스크립트와 원본 결과는 글 하단에 공개합니다.
YouTube에서 보기(영어, 5분): How to Cut AI API Costs Without Losing Accuracy (7 Models Tested)
대상 독자는 LLM API를 호출하면서 짐작이 아니라 근거를 갖고 비용을 줄이고 싶은 개발자와 소규모 팀입니다. Codex, ChatGPT, Claude 앱의 구독 할당량은 측정하지 않았습니다. 이 요금제들은 사용량이 할당량으로 어떻게 환산되는지 공개하지 않기 때문입니다.
토큰 단가가 잘못된 기준인 이유
모델의 요금표와 실제 청구서 사이에는 세 가지 요소가 있습니다.
- 싼 모델로 충분한지는 작업 난이도가 결정합니다. 실패하면 더 강한 모델로 다시 비용을 내야 합니다.
- 추론 모델은 사고 과정도 출력 토큰으로 과금합니다.
completion_tokens에 포함된reasoning_tokens는 화면에 보이지 않아도 과금됩니다. - 실패도 과금됩니다. 빈 답이나 틀린 답도 좋은 답과 똑같이 토큰 비용이 듭니다.
그래서 비교 가능한 숫자는 정답 1건당 비용입니다. 자신의 검사를 통과하는 답을 얻기까지 실행한 호출들의 청구 비용을 말합니다. 같은 개념을 영상 생성에도 쓸 수 있는 클립 1개당 비용(영어)에서 적용했고, Luna와 Sol 라우팅 가이드에서는 실측이 아니라 직접 작성한 예시로 판단 규칙을 정리했습니다. 이 글은 여기에 실측한 청구 금액을 더합니다.
테스트 방법
| 항목 | 내용 |
|---|---|
| 날짜 | 본 테스트는 2026년 10월 20일, 상위 모델 전환 데모와 코딩 추가 검증은 2026년 10월 21일 |
| 접속 | ofox OpenAI 호환 엔드포인트 https://api.ofox.io/v1/chat/completions |
| 모델 | anthropic/claude-opus-5.5, anthropic/claude-sonnet-5.5, anthropic/claude-haiku-5.5, openai/gpt-6-sol, openai/gpt-6-luna, deepseek/deepseek-v4.1-flash, qwen/qwen3.8-flash |
| 입력 | 직접 작성한 회의록 2종과 버그가 있는 Python 함수 1개. 고객 데이터는 사용하지 않았습니다. |
| 채점 | 자동 채점. 회의록: 예상되는 담당자 + 마감일 쌍이 모두 나와야 하고 불필요한 항목이 없어야 함(작업 문구는 채점하지 않음). 코드: 서브프로세스에서 실행하는 비공개 테스트 8개. |
| 반복 | 채점 대상인 각 설정을 2~3회 실행. 소규모 테스트이며 벤치마크가 아닙니다. |
| 비용 | 각 호출에 ofox가 실제로 청구한 금액. 완료된 86건 전체를 모델, 토큰 수, 시각으로 대조했습니다. |
완료된 86건은 본 테스트의 83건에 GPT-6 Sol을 추론 강도 low로 추가 실행한 3건을 더한 것입니다. 이 3건은 어려운 회의록에서 매번 7개 항목을 모두 맞혔고 1회당 $0.003582였습니다. 83건에는 긴 대화 실험에서 나온 채점하지 않은 GPT-6 Luna 호출 17건이 포함됩니다. 이 실험은 비교한 두 조건이 동등한 작업이 아니었기 때문에 이 글에서 제외했습니다. 또 버그 수정에서 GPT-6 Sol의 추론 강도 low와 high를 비교한 6건도 포함됩니다(둘 다 통과했고 high의 비용이 약 18% 더 많았습니다). 테스트 기록 중 2건은 레이트 리밋(HTTP 429)에 걸렸습니다. 10월 20일에는 OpenAI 호환 엔드포인트로 Claude 모델에 접속할 수 있었습니다. 10월 21일부터 ofox는 Claude 모델을 OpenAI 호환 엔드포인트 대신 Anthropic 호환 엔드포인트(/anthropic/v1)로 제공합니다.
결과 1: 일상 작업
회의록에서 액션 아이템 추출. 회의록에는 날짜가 있는 액션 아이템 8개와 함정 5개를 넣었습니다. 담당자가 없는 아이디어, 날짜가 없는 결정 사항, 점검 공지 같은 것들입니다. 모든 모델이 두 번의 실행 모두에서 담당자 + 마감일 쌍 8개를 전부 찾았고, 불필요한 항목은 없었습니다.
| 모델 | 완전 일치한 실행 | 1회당 청구 금액(평균) | 출력 토큰(평균) |
|---|---|---|---|
| Claude Opus 5.5 | 2/2 | $0.019712 | 657 |
| Claude Sonnet 5.5 | 2/2 | $0.011491 | 820 |
| GPT-6 Sol | 2/2 | $0.004806 | 337 |
| DeepSeek V4.1 Flash | 2/2 | $0.002470 | 1,908 |
| Qwen 3.8 Flash | 2/2 | $0.001405 | 1,852 |
| Claude Haiku 5.5 | 2/2 | $0.000607 | 885 |
| GPT-6 Luna | 2/2 | $0.000262 | 381 |
같은 완전 일치 결과에 대해 Opus는 Luna의 75.2배 비용이 들었습니다. 가격은 속도도 예측하지 못했습니다. Luna는 약 5초 만에 답했지만, DeepSeek V4.1 Flash는 한 번은 264.5초, 다른 한 번은 13.2초가 걸렸습니다.
버그 4개가 있는 함수 수정. 이 함수는 겹치는 회의실 예약을 병합하는데, 정렬하고, 맞닿은 시간 범위를 합치고, 더 늦은 종료 시각을 유지하고, 유효하지 않은 예약을 버려야 합니다. 모든 모델이 두 번 모두 비공개 테스트 8개를 통과했습니다. 1회당 평균은 Opus가 $0.010086, Luna가 $0.000225로 44.8배 차이였습니다.
결과 2: 더 어려운 작업과 첫 실제 실패
쉬운 작업으로는 모델 간 차이가 드러나지 않아서, 회의 도중 사람들이 생각을 바꾸는 회의록을 작성했습니다. 날짜는 2026년 10월 20일 화요일입니다. 한 작업은 Priya에서 Omar로 재배정되고, 한 마감일은 27일에서 31일로 미뤄지며, 한 작업은 취소됩니다. 날짜는 “tomorrow”(내일), “two business days from today”(오늘부터 영업일 2일 후), “end of next week”(다음 주 말)처럼 상대적으로 표현됩니다. 정답 항목은 7개이며, 출력은 4,000토큰으로 제한했습니다.
| 모델 | 완전 일치한 실행 | 1회당 청구 금액(평균) | 실패 내용 |
|---|---|---|---|
| Claude Opus 5.5 | 3/3 | $0.019053 | 없음 |
| Claude Sonnet 5.5 | 3/3 | $0.011207 | 없음 |
| GPT-6 Sol | 3/3 | $0.003999 | 없음 |
| GPT-6 Luna | 3/3 | $0.000276 | 없음 |
| Claude Haiku 5.5 | 2/3 | $0.000675 | 한 번은 “end of next week” 항목을 빠뜨림 |
| Qwen 3.8 Flash | 1/2 | $0.002938 | 빈 응답 1회, 다른 요청은 레이트 리밋에 걸림 |
| DeepSeek V4.1 Flash | 1/3 | $0.004423 | 빈 응답 2회 |
DeepSeek와 Qwen의 실패는 틀린 답이 아니라 빈 답이었습니다. 실패한 경우마다 completion_tokens와 reasoning_tokens가 모두 상한 전체인 4,000이었고 content는 빈 문자열이었습니다.
빈 응답도 과금된다
청구 내역을 확인했습니다. ofox Activity 페이지에는 10월 20일 오후 3:07:37 요청이 기록되어 있습니다. 출력 토큰 4K 중 4K가 추론이었고, 청구 금액은 $0.00480307이었습니다.
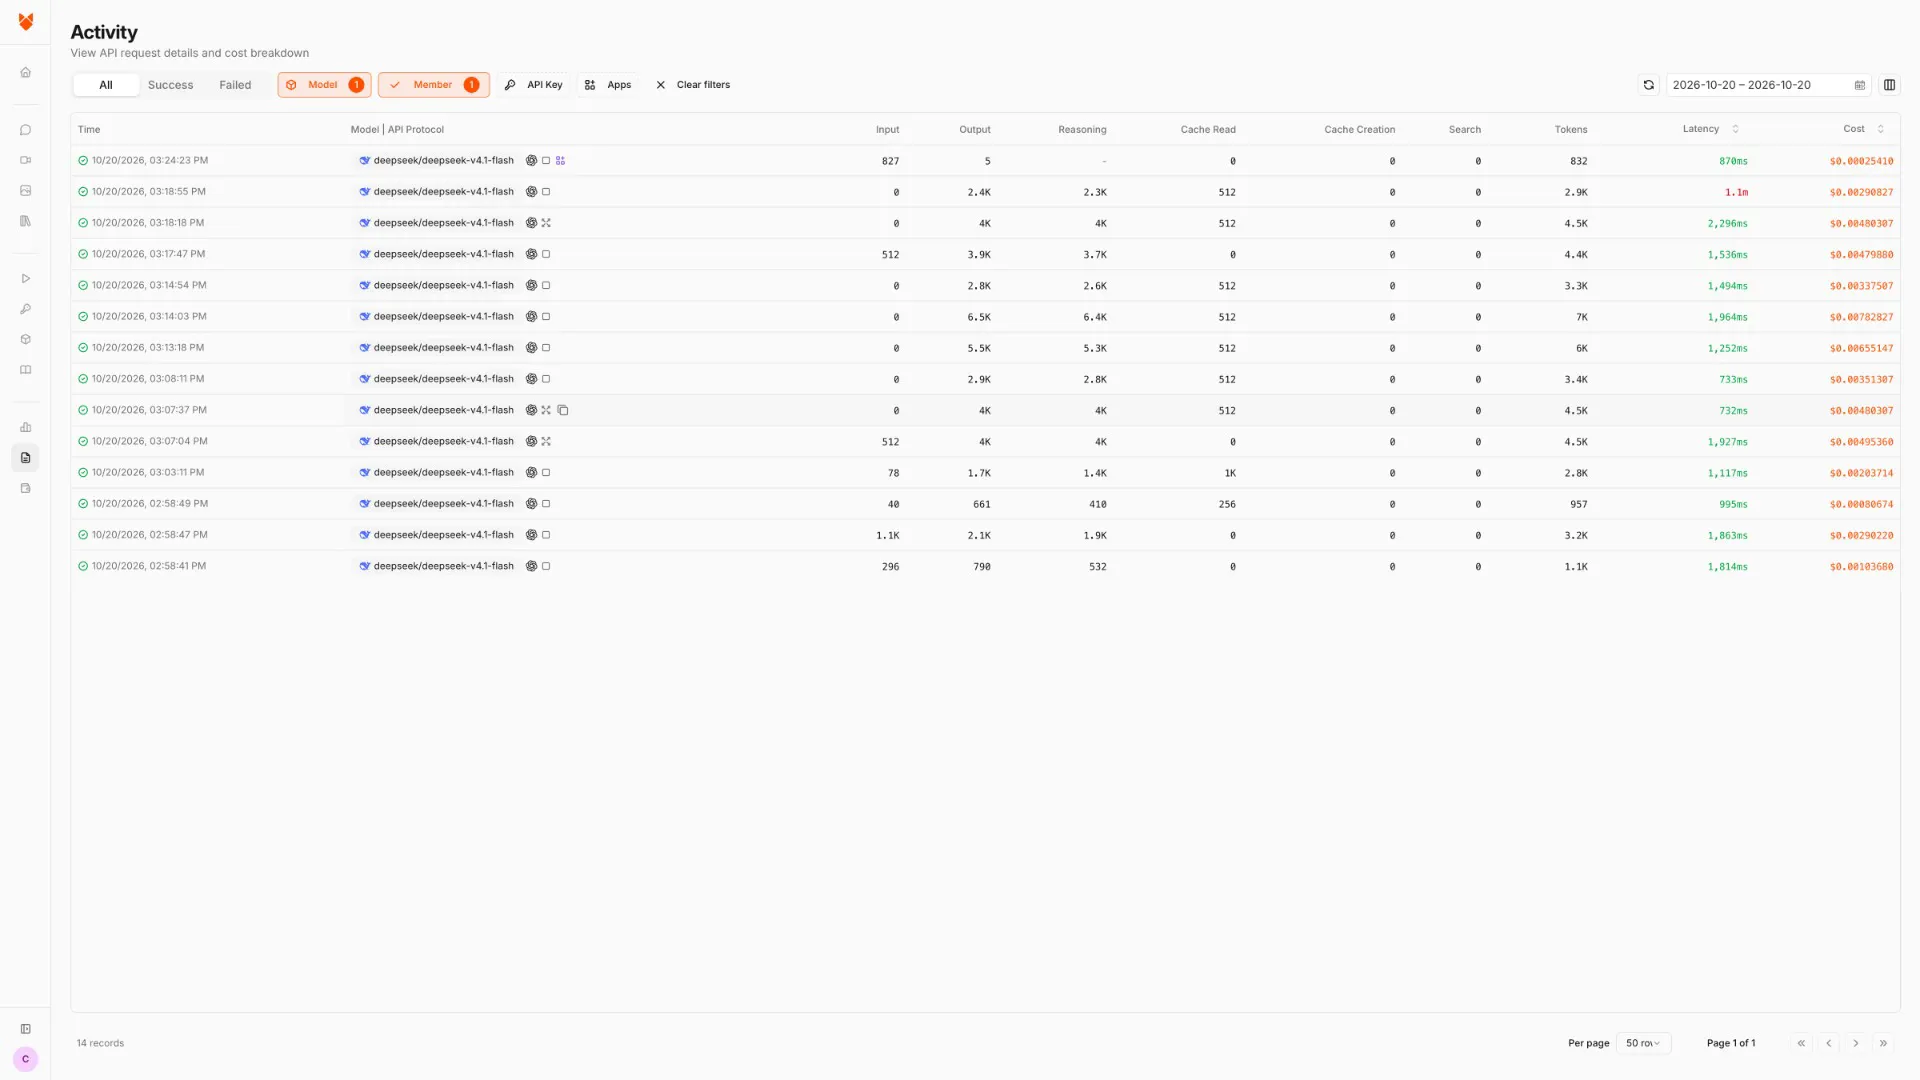
스크린샷은 실제 대시보드이며 화면은 영어 UI 그대로입니다. 녹화 전에 저희 테스트 요청만 보이도록 필터링했고, 팀, 잔액, 다른 멤버의 데이터는 표시하지 않았습니다. 이 테스트에서 DeepSeek의 빈 응답 2건에는 각각 $0.004803072와 $0.0049536이 청구되었습니다.
추론 모델 함정 해결하기
DeepSeek V4.1 Flash와 Qwen 3.8 Flash를 같은 어려운 회의록으로, 출력 상한을 늘리거나 추론 강도를 낮춰 다시 실행했습니다. 각각 3회씩입니다.
| 설정 | 완전 일치한 실행 | 1회당 청구 금액(평균) | 출력 토큰(평균) | 응답 시간(중앙값) |
|---|---|---|---|---|
| DeepSeek V4.1 Flash, 상한 16,000 | 3/3 | $0.005918 | 4,929 | 45.2초 |
DeepSeek V4.1 Flash, reasoning_effort: "low" | 2/3 | $0.004170 | 3,431 | 37.2초 |
| Qwen 3.8 Flash, 상한 16,000 | 3/3 | $0.002560 | 3,348 | 41.4초 |
Qwen 3.8 Flash, reasoning_effort: "low" | 3/3 | $0.000682 | 910 | 17.5초 |
끝까지 생각할 여유가 있으면 DeepSeek는 매번 정답을 냈지만, 정답 1건당 $0.0059가 들었습니다. GPT-6 Sol은 같은 작업을 출력 토큰 약 305개로 $0.0040에 처리했습니다. ofox 가격표에서 DeepSeek V4.1 Flash는 100만 토큰당 입력 $0.30, 출력 $1.20이고, GPT-6 Sol은 $2.00과 $10.00입니다. 입력 가격은 약 7분의 1, 출력 가격은 약 8분의 1입니다. 그런데도 정답 1건당 비용은 DeepSeek가 더 높았습니다. 출력의 약 96.7%가 생각이었기 때문입니다.
이번에는 추론 강도를 낮춘 효과가 Qwen에서 가장 컸습니다. 3회 모두 완전 일치했고, 1회당 $0.000682, 응답 시간 중앙값은 17.5초였습니다. 반면 DeepSeek는 low에서도 빈 응답이 1회 나와 해결되지 않았습니다. 각 3회 실행한 이번 테스트에서 DeepSeek가 매번 통과한 설정은 출력 토큰 상한을 올린 경우였습니다.
여기서 실무 규칙 두 가지가 나옵니다.
- 출력 토큰 상한과 추론 강도는 명시적으로 설정하세요.
content가 비어 있고finish_reason: "length"인 응답은 답이 아니라 실패로 처리합니다. - 정답 1건당 청구 비용으로 비교하세요. 100만 토큰당 가격만으로 판단하지 마세요. 재시도와 폴백이 이 숫자를 어떻게 바꾸는지는 라우팅 손익분기 계산기에서 설명합니다.
검증한 뒤 상위 모델로
흔한 조언은 싼 모델로 시작하고 실패하면 더 좋은 모델로 바꾸라는 것입니다. 하지만 실제로 “실패하면”을 판단하려면 실행할 수 있는 검사가 필요합니다. 코드라면 그 검사는 테스트입니다. 아래 스크립트는 싼 모델부터 차례로 호출하고, 각 응답에 테스트를 실행한 뒤, 실패할 때만 다음 모델로 올라갑니다.
이 안전망이 작동하는 모습을 보여 주려면 실패하는 싼 모델이 필요했습니다. 그런데 GPT-6 Luna는 한 번도 실패하지 않았습니다. 본 테스트에서 채점 대상 7회를 모두 통과했고, 이번 검증을 위해 만든 5개 코딩 작업(영업일 계산, 기간 문자열 파싱, 비용 분담, cron 일정, 서머타임(DST) 시각 처리)에서도 15회 중 15회 통과했습니다. 추론 강도 low의 GPT-6 Sol은 18회 코딩 실행 중 1회(기간 문자열 파싱)에서 3개 케이스를 놓쳐 19개 중 16개를 통과했습니다. 그래서 데모는 DeepSeek V4.1 Flash에서 시작합니다. DeepSeek는 이 코딩 작업 중 하나인 cron “다음 실행 시각” 함수(테스트 12개)에서 4,000토큰 상한으로 3회 실행해 3회 모두 빈 응답을 반환했습니다.
import json, os, re
from openai import OpenAI

client = OpenAI(base_url="https://api.ofox.io/v1",
                api_key=os.environ["OFOX_API_KEY"])

# Cheapest first. $ per 1M tokens (in, out), ofox, Oct 2026
TIERS = [
    ("deepseek/deepseek-v4.1-flash", 0.30, 1.20, {}),
    ("openai/gpt-6-sol", 2.00, 10.00,
     {"reasoning_effort": "low"}),
]

def passes(reply):
    m = re.search(r"```(?:python)?\n(.*?)```", reply, re.S)
    if not m:
        return 0
    ns = {}
    exec(m.group(1), ns)
    tests = json.load(open("tests.json"))
    return sum(ns["next_run"](*a) == want for a, want in tests)

task, total = open("task.txt").read(), 0.0
for model, p_in, p_out, extra in TIERS:
    r = client.chat.completions.create(
        model=model, max_tokens=4000,
        messages=[{"role": "user", "content": task}], **extra)
    u = r.usage
    cost = (u.prompt_tokens * p_in + u.completion_tokens * p_out) / 1e6
    total += cost
    ok = passes(r.choices[0].message.content or "")
    print(f"{model}\n  {u.completion_tokens} out tokens  ${cost:.4f}  tests {ok}/12")
    if ok == 12:
        print(f"PASS  total ${total:.4f}")
        break
    print("  check failed -> moving up")
2026년 10월 21일 실제 실행 결과입니다.
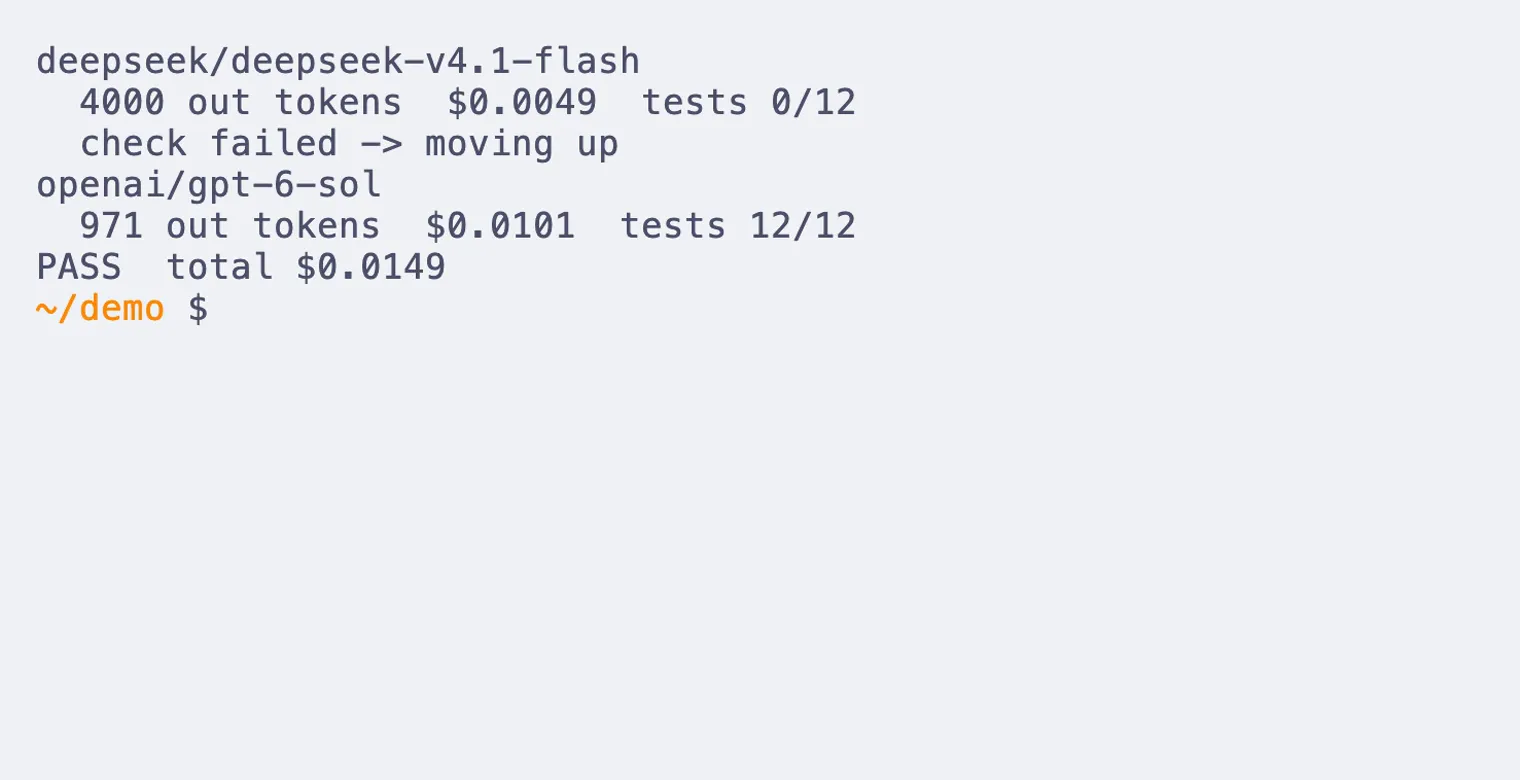
deepseek/deepseek-v4.1-flash
  4000 out tokens  $0.0049  tests 0/12
  check failed -> moving up
openai/gpt-6-sol
  971 out tokens  $0.0101  tests 12/12
PASS  total $0.0149
여기 출력된 비용은 API가 반환한 토큰 사용량에 ofox 정가를 곱한 값입니다. 합계를 보세요. 실패한 DeepSeek 시도가 약 0.5센트를 더해서, 이 실행은 처음부터 Sol로 시작했을 때보다 비용이 더 들었습니다.
검사의 목적은 매번 싼 모델을 시도하게 만드는 것이 아닙니다. 작업 종류별로 어느 모델에서 시작해야 하는지 알려 주는 것이 검사의 역할입니다. 이 작업에서 DeepSeek V4.1 Flash는 첫 단계로 적합하지 않았습니다. 두 모델보다 토큰 단가가 싼 GPT-6 Luna는 같은 cron 작업에서 3회 모두 통과했고(이 검증에서는 상한 6,000토큰), 회의록에서도 모든 항목을 맞혔습니다. 저희 실행 결과로 보면 회의록 작업 같은 추출 작업과 이 5개 코딩 작업은 Luna에서 시작해도 됩니다. 자신의 검사에서 싼 모델의 실패가 확인된 작업에서만 더 높은 모델로 시작하고, 그런 경우를 위해 상위 모델 전환 경로를 남겨 두세요.
참고로 exec는 모델이 작성한 코드를 내 프로세스 안에서 실행합니다. 어차피 검토할 코드로 하는 데모라면 허용할 만합니다. 자동화된 작업이라면 저희 전체 테스트 러너처럼 샌드박스나 서브프로세스에서 테스트를 실행하세요.
내 작업에 적용하는 방법
실제 업무에는 정답표가 없으니 작은 정답표를 직접 만듭니다.
- 매일 실행하는 작업 3개를 고르고 각각 실제 입력을 5~10개 저장합니다.
- 모델을 고르기 전에 검사를 작성합니다. 코드라면 테스트 몇 개, 추출이라면 기대하는 필드와 함께 몇몇 항목을 원본과 대조하는 표본 확인, 요약이라면 반드시 들어가야 할 사실의 짧은 목록입니다.
- 후보가 될 만한 가장 싼 모델을 입력당 2~3회 실행하고 통과율, 출력 토큰, 청구 비용을 기록합니다. 추정치가 아니라 청구 내역을 확인하세요. 추론을 많이 하는 모델은 단가로 짐작하는 것보다 훨씬 비쌀 수 있습니다.
- 각 작업의 시작 모델을 자신의 실행에서 안정적으로 통과한 가장 싼 모델로 정합니다. 상위 모델 전환은 실패 대응용으로 쓰고 기본 경로로 삼지 않습니다.
- 가격이나 모델 버전이 바뀌면 검사를 다시 실행합니다.
| 증상 | 예상 원인 | 대처 |
|---|---|---|
content가 비어 있고 completion_tokens가 설정한 상한과 같음 | 추론이 출력 예산을 모두 사용함 | max_tokens를 올리거나, reasoning_effort를 낮추거나, 이 작업에는 비추론 모델을 사용 |
| HTTP 429 | 레이트 리밋 | 간격을 두고 재시도. 이번에는 Qwen 3.8 Flash에서 발생했습니다. |
| JSON이나 코드 블록을 파싱할 수 없음 | 모델이 답 앞뒤에 설명 문장을 덧붙임 | 형식을 명시적으로 요청하고 첫 번째 코드 펜스나 JSON 배열을 추출 |
| 한 번 실행에 몇 분이 걸림 | 생각 시간이 길거나 들쭉날쭉함 | 요청 타임아웃을 설정. 지연 시간이 중요한 작업에는 오래 추론하는 모델을 피함. |
/v1에서 Claude 모델이 “does not support the ‘openai’ protocol”로 거부됨 | 2026년 10월 21일부터 ofox 카탈로그는 Claude를 Anthropic 프로토콜로만 등록하고 있으며, 10월 21일과 22일 테스트에서 이 오류를 확인함 | base URL을 https://api.ofox.io/anthropic으로 설정하고 Anthropic SDK를 사용. 10월 22일 테스트에서는 claude-sonnet-5.5 형식과 anthropic/claude-sonnet-5.5 형식의 ID가 모두 /anthropic/v1/messages에서 받아들여졌습니다. |
이 테스트의 한계
- 입력은 합성 데이터이며 짧습니다. 회의록은 약 1,000토큰입니다.
- 각 설정은 2~3회 실행했습니다. 통과율은 이번 실행에서 일어난 결과로 보고, 안정적인 성공률로 간주하지 마세요.
- 회의록 채점은 담당자 + 마감일 쌍과 불필요한 항목만 확인합니다. 각 작업의 문구는 채점하지 않습니다.
- 금액은 2026년 10월 20~21일에 ofox가 청구한 것입니다. 단, 상위 모델 전환 데모는 API가 보고한 사용량에 정가를 곱한 값입니다. OpenAI 호환 엔드포인트로 받은 Claude 응답에는 프롬프트 캐시 내역이 포함되지 않았습니다.
- 가격과 모델 버전은 바뀝니다. 이 숫자를 다시 쓰기 전에 최신 ofox 모델 목록을 확인하세요.
- 프롬프트 캐싱 전략, 배치 API, 시맨틱 캐싱은 테스트하지 않았습니다. 이 내용은 비용 절감 개요(영어)에서 다룹니다.
- 이 글은 Ofox가 발행했으며, 테스트도 자사 플랫폼에서 실행했습니다.
다운로드
모든 파일은 /blog/_assets/evidence/cost-per-correct-result-20261022/에 있습니다.
results-billed.csv: 86건 전체 호출의 토큰, 점수, 청구 금액runner.py: 테스트 러너와 채점기escalate.py,cron-task.txt,cron-tests.json: 상위 모델 전환 데모coding-tasks/results.csv: 5개 코딩 작업 검증 결과- 입력과 정답표:
meeting_notes.md,meeting_notes_hard.md,ground_truth.json,ground_truth_hard.json,buggy_code.py,hidden_tests.py
실행하려면 환경 변수 OFOX_API_KEY를 설정하세요. escalate.py를 실행하기 전에 같은 폴더에 cron-task.txt를 task.txt로, cron-tests.json을 tests.json으로 저장합니다. 코딩 작업 결과에는 6,000토큰 상한으로 실행한 GLM 5.3 Flash와 Qwen 3.8 Flash 결과도 들어 있습니다. 그 대부분은 빈 응답이었고 본문에서는 다루지 않았습니다. 호출 단위가 아니라 사용 한도 대비 비용을 측정하고 싶다면 Codex 주간 한도(영어)와 Claude Code 사용량 한도(영어) 가이드에서 구독 요금제 관점을 다룹니다.
자주 묻는 질문
- 토큰 단가가 가장 싼 모델이 작업 단위로도 가장 싼가요?
- 항상 그렇지는 않습니다. 더 어려운 테스트에서 DeepSeek V4.1 Flash의 출력 토큰 단가는 GPT-6 Sol의 약 8분의 1이었지만, 정답 1건당 비용은 Sol의 $0.0040에 비해 $0.0059였습니다. 출력 토큰을 약 4,900개 사용했고 그중 97%가 추론이었기 때문입니다.
- 추론 모델의 빈 응답에도 비용이 청구되나요?
- 네. API가 반환한 usage에는 출력 토큰 4,000개가 모두 집계되었고, ofox 청구에도 그대로 반영되었습니다. 예를 들어 DeepSeek V4.1 Flash의 빈 응답 1건에 $0.00480307이 청구되었습니다.
- 이 결과로 Codex나 ChatGPT 구독 할당량을 얼마나 아낄 수 있는지 알 수 있나요?
- 알 수 없습니다. 이번에 측정한 것은 API 토큰 비용입니다. 구독 요금제는 사용량이 할당량으로 어떻게 환산되는지 공개하지 않습니다.