便宜模型真的省钱吗?7 个模型 86 次计费调用,算出每个正确结果花多少
同样的任务交给 7 个模型,按 ofox 实际账单算出每拿到一个正确结果的成本。在我们测试的日常任务里,最便宜的模型全部答对;难题上,推理模型可能在思考上用光输出 token 上限,返回空回复,照样扣费。附先验证再升级的脚本。
 Ofox
在我们测试的日常任务里,最便宜的模型和最贵的模型答对了同样的内容,计费成本只有后者的 1/75(会议纪要)和 1/45(修 bug)。 换成更难的任务,token 单价低就不再意味着结果便宜:DeepSeek V4.1 Flash 和 Qwen 3.8 Flash 有时在思考上用光了全部输出 token 上限,最后什么也没返回,费用却照扣。所以该比的是拿到一个正确结果要花多少钱,而且在信任结果之前先验证。
本文是我们视频教程的文字版,视频由 AI 生成的主持人 Marie 讲解。所有测试由 ofox 团队设计,于 2026 年 10 月 20 日至 21 日完成,每次调用都和 ofox 账单逐条对账,测试脚本和原始结果见文末下载。
在 YouTube 观看(英文,5 分钟):How to Cut AI API Costs Without Losing Accuracy (7 Models Tested)
本文适合通过 API 调用大模型、想少花钱又不想靠猜的开发者和小团队。本文不测 Codex、ChatGPT 或 Claude 应用的订阅额度,因为这些套餐没有公开用量如何折算成额度。
为什么 token 单价不是该看的数字
从模型价目表到你的账单,中间隔着三件事。
- 任务难度决定便宜模型够不够用。 便宜模型做不出来,你还得再付一次钱换更强的模型。
- 推理模型把思考算作输出。
completion_tokens里包含的reasoning_tokens,即使你看不到也照样计费。 - 失败也计费。 空回复或错误答案消耗的 token,和正确答案一样要付钱。
因此真正可比的数字是每个正确结果的成本:为了拿到一个通过你检查的答案,所有尝试实际被扣了多少钱。我们在视频场景用过同样的思路,见可用片段成本(英文);Luna 到 Sol 的路由指南用作者编写的示例讲了决策规则。本文补上的是实测并实际计费的数字。
测试方法
| 项目 | 说明 |
|---|---|
| 日期 | 主测试 2026 年 10 月 20 日;升级演示和编程检查 2026 年 10 月 21 日 |
| 接入方式 | ofox 的 OpenAI 兼容端点 https://api.ofox.io/v1/chat/completions |
| 模型 | anthropic/claude-opus-5.5、anthropic/claude-sonnet-5.5、anthropic/claude-haiku-5.5、openai/gpt-6-sol、openai/gpt-6-luna、deepseek/deepseek-v4.1-flash、qwen/qwen3.8-flash |
| 输入 | 我们自己编写的两份会议纪要和一个有 bug 的 Python 函数,不含任何客户数据 |
| 评分 | 自动评分。会议纪要:每一组预期的“负责人 + 截止日期”都必须出现,且不能多出条目(不评任务描述的措辞)。代码:在子进程里跑 8 个隐藏测试 |
| 重复次数 | 每个计分配置跑两到三次。这是小规模测试,不是基准评测 |
| 费用 | 每次调用的 ofox 实际扣费金额,按模型、token 数和时间与全部 86 次已完成调用逐一对应 |
86 次已完成调用 = 主测试的 83 次 + 额外 3 次 GPT-6 Sol 低推理强度运行。这 3 次在难版会议纪要上每次都对上了全部 7 项,每次 $0.003582。83 次里有 17 次不计分的 GPT-6 Luna 调用,来自一项长对话实验,因为两组对照的任务并不等价,本文没有采用;另有 6 次 GPT-6 Sol 调用,用于在修 bug 任务上比较低、高两档推理强度(两档都通过,高档费用约多 18%)。有两条测试记录触发了限流(HTTP 429)。10 月 20 日时,Claude 模型还能通过 OpenAI 兼容端点调用;从 10 月 21 日起,ofox 改为通过 Anthropic 兼容端点(/anthropic/v1)提供这些模型。
结果一:日常任务
从会议纪要提取待办事项。 纪要里有 8 项带日期的待办,还埋了 5 个陷阱:没人认领的想法、没有日期的决定、一条维护通知等。所有模型在两次运行中都找出了全部 8 组“负责人 + 截止日期”,没有多出任何条目。
| 模型 | 完全匹配的次数 | 每次计费(平均) | 输出 token(平均) |
|---|---|---|---|
| Claude Opus 5.5 | 2/2 | $0.019712 | 657 |
| Claude Sonnet 5.5 | 2/2 | $0.011491 | 820 |
| GPT-6 Sol | 2/2 | $0.004806 | 337 |
| DeepSeek V4.1 Flash | 2/2 | $0.002470 | 1,908 |
| Qwen 3.8 Flash | 2/2 | $0.001405 | 1,852 |
| Claude Haiku 5.5 | 2/2 | $0.000607 | 885 |
| GPT-6 Luna | 2/2 | $0.000262 | 381 |
同样完全匹配的结果,Opus 的费用是 Luna 的 75.2 倍。价格也预测不了速度:Luna 大约 5 秒就答完,DeepSeek V4.1 Flash 一次用了 264.5 秒,另一次 13.2 秒。
修一个有四处 bug 的函数。 这个函数负责合并时间重叠的会议室预订,需要排序、合并首尾相接的时段、保留较晚的结束时间,并丢弃无效预订。所有模型在两次运行中都通过了全部 8 个隐藏测试。Opus 平均每次 $0.010086,Luna 为 $0.000225,Opus 的费用是 Luna 的 44.8 倍。
结果二:更难的任务,第一次出现真正的失败
简单任务拉不开差距,所以我们写了一份与会者中途改主意的纪要,日期标为 2026 年 10 月 20 日星期二。其中一项任务从 Priya 改派给 Omar,一个截止日期从 27 日推迟到 31 日,一项任务被取消,日期还是相对说法:“明天”“从今天起两个工作日”“下周结束前”。正确条目共 7 项,输出上限设为 4,000 token。
| 模型 | 完全匹配的次数 | 每次计费(平均) | 问题 |
|---|---|---|---|
| Claude Opus 5.5 | 3/3 | $0.019053 | 无 |
| Claude Sonnet 5.5 | 3/3 | $0.011207 | 无 |
| GPT-6 Sol | 3/3 | $0.003999 | 无 |
| GPT-6 Luna | 3/3 | $0.000276 | 无 |
| Claude Haiku 5.5 | 2/3 | $0.000675 | 有一次漏掉了“下周结束前”那一项 |
| Qwen 3.8 Flash | 1/2 | $0.002938 | 一次空回复;另一次请求触发了限流 |
| DeepSeek V4.1 Flash | 1/3 | $0.004423 | 两次空回复 |
DeepSeek 和 Qwen 的失败不是答错,而是什么都没答。每一次失败中,completion_tokens 和 reasoning_tokens 都是 4,000,正好顶到上限,content 是空字符串。
空回复照样计费
我们查了账单。ofox 的 Activity 页面列出了 10 月 20 日下午 3:07:37 的那次请求:输出 4K token,其中 4K 是推理,扣费 $0.00480307。
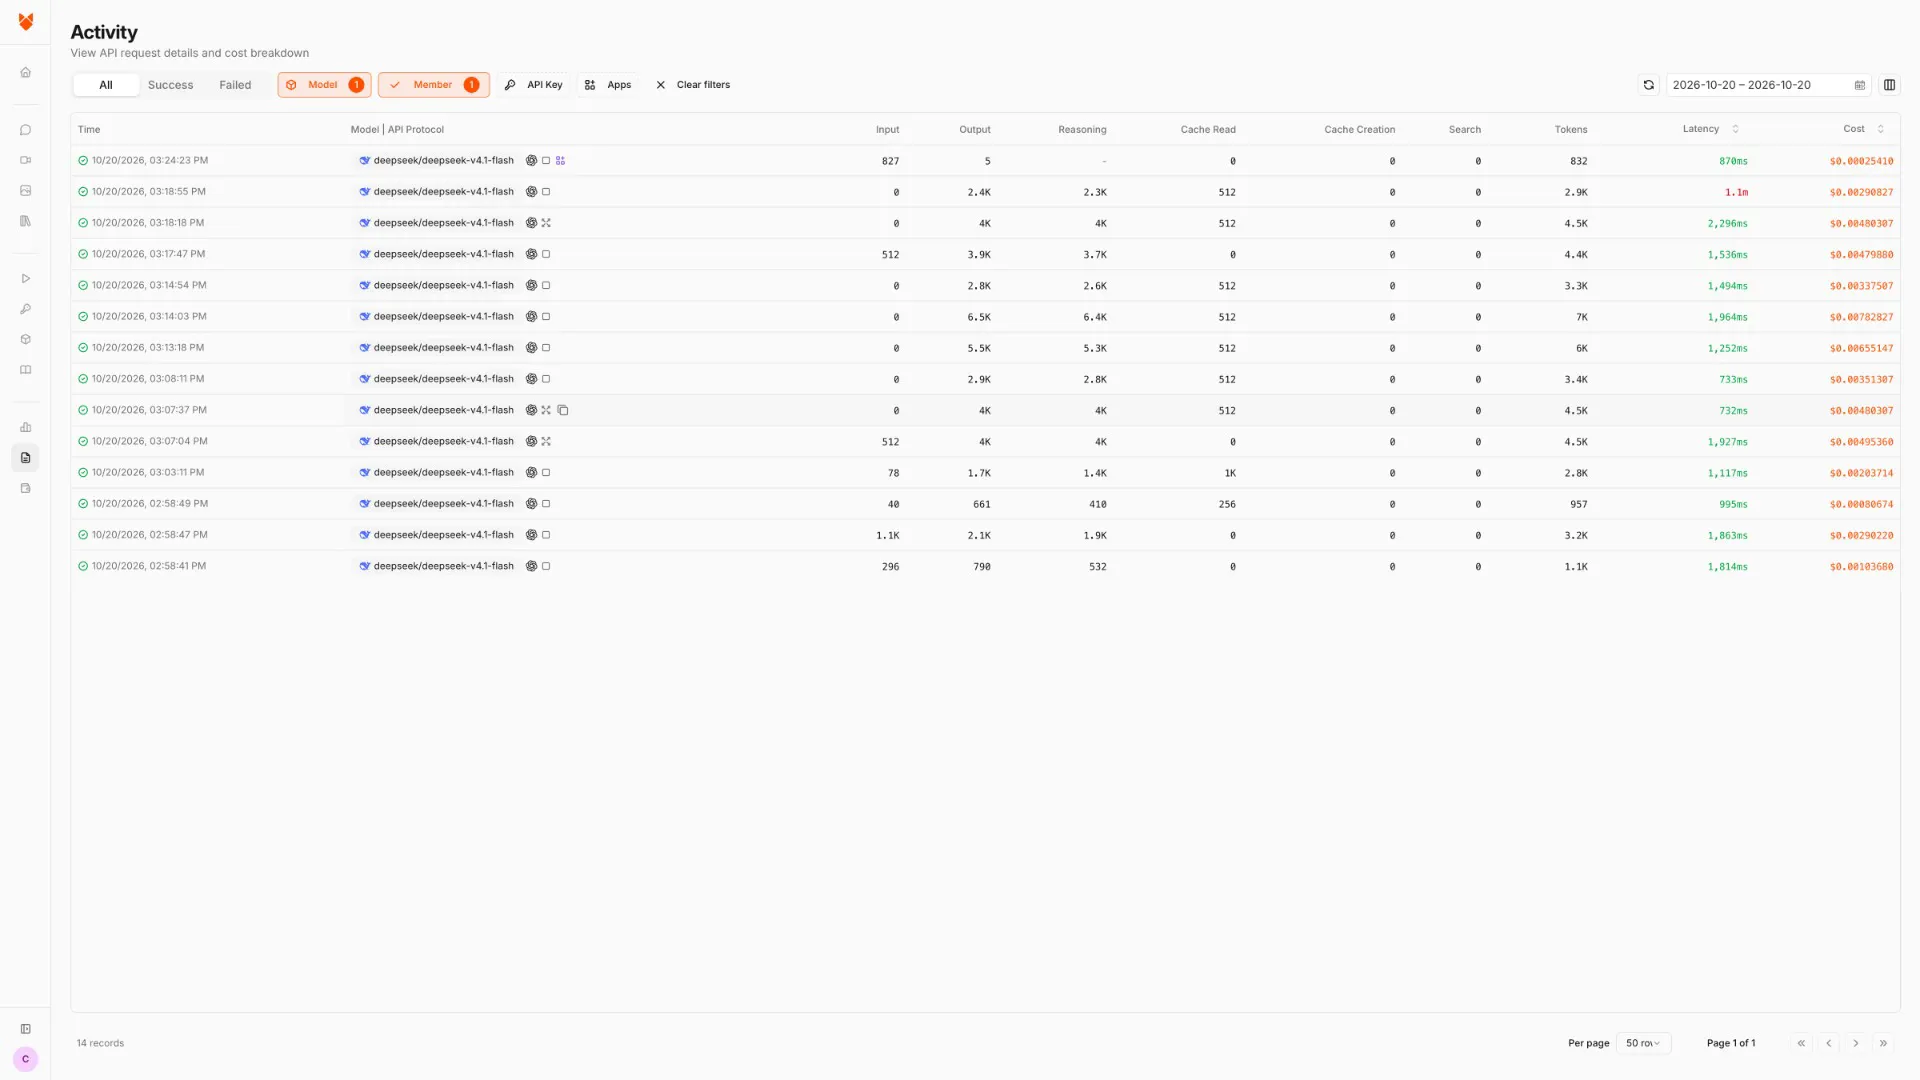
截图来自真实的后台英文界面,录制前已筛选为我们自己的测试请求,没有显示团队、余额和其他成员的数据。本次测试中 DeepSeek 的两次空回复分别扣费 $0.004803072 和 $0.0049536。
怎么避开推理模型的坑
我们让 DeepSeek V4.1 Flash 和 Qwen 3.8 Flash 在同一份难版纪要上重跑,要么放宽输出上限,要么调低推理强度,每种设置各跑三次。
| 设置 | 完全匹配的次数 | 每次计费(平均) | 输出 token(平均) | 响应时间(中位数) |
|---|---|---|---|---|
| DeepSeek V4.1 Flash,上限 16,000 | 3/3 | $0.005918 | 4,929 | 45.2 秒 |
DeepSeek V4.1 Flash,reasoning_effort: "low" | 2/3 | $0.004170 | 3,431 | 37.2 秒 |
| Qwen 3.8 Flash,上限 16,000 | 3/3 | $0.002560 | 3,348 | 41.4 秒 |
Qwen 3.8 Flash,reasoning_effort: "low" | 3/3 | $0.000682 | 910 | 17.5 秒 |
给足空间之后,DeepSeek 每次都答对了,但每次正确运行要花 $0.0059。同样的任务,GPT-6 Sol 只用了约 305 个输出 token,花费 $0.0040。按 ofox 价目表,DeepSeek V4.1 Flash 每百万 token 输入 $0.30、输出 $1.20,GPT-6 Sol 是 $2.00 和 $10.00,DeepSeek 的输入价约为 Sol 的 1/7,输出价约为 1/8。可它每个正确结果反而更贵,因为约 96.7% 的输出都是思考。
调低推理强度对 Qwen 帮助最大:三次全部匹配,每次 $0.000682,响应时间中位数 17.5 秒。DeepSeek 却没有因此解决问题,低推理强度下仍有一次空回复。在这几组三次运行的测试里,两种设置中让 DeepSeek 每次都通过的是放宽上限。
由此得出两条实用规则:
- 有意识地设置输出上限和推理强度,并把
content为空且finish_reason: "length"的响应当作失败,而不是答案。 - 比较每个正确结果的实际计费成本,不要只看每百万 token 的单价。我们的路由盈亏平衡计算器展示了重试和回退会怎样改变这个数字。
先验证,再升级
常见建议是先用便宜模型,失败了再换好模型。但真要执行,“失败了”需要一个能跑的检查。对代码来说,这个检查就是测试。下面的脚本从最便宜的模型开始依次尝试,对每次回复跑测试,只有测试不通过时才升级到下一档。
为了演示这套兜底机制确实起作用,我们得找一个会失败的便宜模型。GPT-6 Luna 从没失败过:主测试里 7 次计分运行全部通过,我们为此另写的五个编程任务(工作日计算、时长解析、账单分摊、cron 调度和夏令时)也是 15 次全过。GPT-6 Sol 在低推理强度下的 18 次编程运行中,有一次漏了三个用例(时长解析,19 个用例过了 16 个)。所以演示从 DeepSeek V4.1 Flash 起步:在其中一个任务上,也就是带 12 个测试的 cron“下次运行时间”函数,它在 4,000 token 上限下三次运行全部返回空回复。
import json, os, re
from openai import OpenAI

client = OpenAI(base_url="https://api.ofox.io/v1",
                api_key=os.environ["OFOX_API_KEY"])

# Cheapest first. $ per 1M tokens (in, out), ofox, Oct 2026
TIERS = [
    ("deepseek/deepseek-v4.1-flash", 0.30, 1.20, {}),
    ("openai/gpt-6-sol", 2.00, 10.00,
     {"reasoning_effort": "low"}),
]

def passes(reply):
    m = re.search(r"```(?:python)?\n(.*?)```", reply, re.S)
    if not m:
        return 0
    ns = {}
    exec(m.group(1), ns)
    tests = json.load(open("tests.json"))
    return sum(ns["next_run"](*a) == want for a, want in tests)

task, total = open("task.txt").read(), 0.0
for model, p_in, p_out, extra in TIERS:
    r = client.chat.completions.create(
        model=model, max_tokens=4000,
        messages=[{"role": "user", "content": task}], **extra)
    u = r.usage
    cost = (u.prompt_tokens * p_in + u.completion_tokens * p_out) / 1e6
    total += cost
    ok = passes(r.choices[0].message.content or "")
    print(f"{model}\n  {u.completion_tokens} out tokens  ${cost:.4f}  tests {ok}/12")
    if ok == 12:
        print(f"PASS  total ${total:.4f}")
        break
    print("  check failed -> moving up")
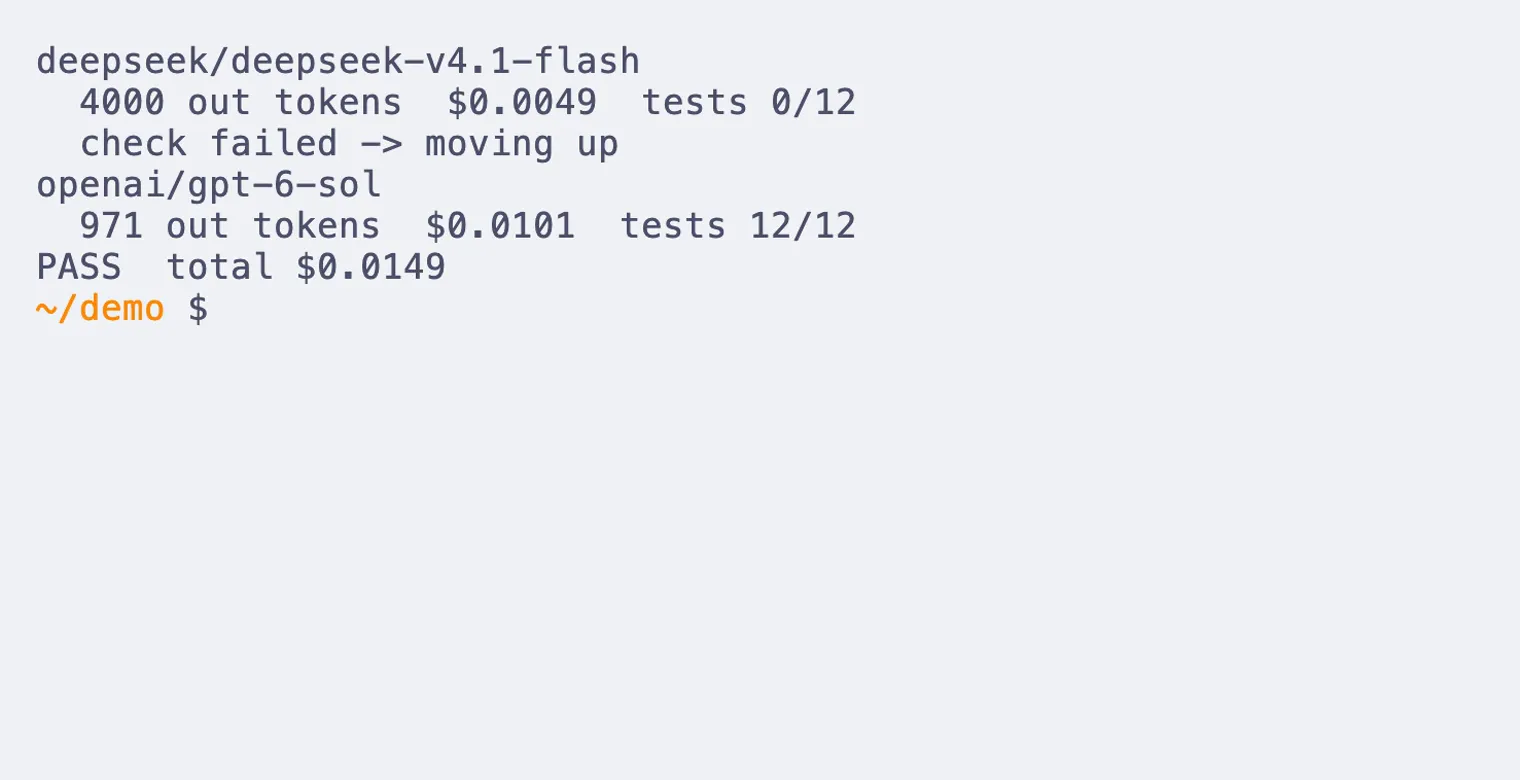
2026 年 10 月 21 日的真实运行结果:
deepseek/deepseek-v4.1-flash
  4000 out tokens  $0.0049  tests 0/12
  check failed -> moving up
openai/gpt-6-sol
  971 out tokens  $0.0101  tests 12/12
PASS  total $0.0149
这里打印的费用,是 API 返回的 token 用量乘以 ofox 牌价。注意看合计:DeepSeek 那次失败多花了大约半美分,所以这次运行比直接从 Sol 开始还贵。
设置检查,不是为了让你每次都先试一遍便宜模型,而是为了弄清每类任务该从哪一档起步。对这个任务来说,DeepSeek V4.1 Flash 是错误的起点。GPT-6 Luna 的 token 单价比这两个模型都低,在同一个 cron 任务上三次运行全部通过(那次检查的上限是 6,000 token),在会议纪要上也对上了每一项。从我们的运行结果看,会议纪要这类信息提取任务和这五个编程任务都可以从 Luna 起步。只有当你自己的检查显示便宜模型会失败时,才让那类任务从更高一档开始,并为这些情况保留升级路径。
注意,exec 会在你的进程里执行模型写的代码。如果只是演示,而且这段代码你本来就要审阅,这样做可以接受。凡是自动化场景,都应该像我们完整的测试运行器那样,在沙箱或子进程里跑测试。
怎么用到你自己的工作中
实际工作里没有现成的标准答案,所以要自己建一个小的。
- 挑三项你每天都在做的任务,每项保存 5 到 10 个真实输入。
- 先写检查,再选模型。 代码就写几个测试;信息提取就列出预期字段,再对照原文抽查几条;摘要就列一份必须出现的事实清单。
- 对每个输入,把看起来能胜任的最便宜模型跑两到三次,记录通过率、输出 token 和实际计费。以账单为准,不要用自己的估算。推理量大的模型,实际花费可能远超单价给人的印象。
- 给每项任务定下起步模型,选在你的运行中稳定通过的最便宜那个。升级只用来处理失败,不要当成默认路径。
- 价格或模型版本变化时,重新跑一遍检查。
| 现象 | 可能原因 | 处理办法 |
|---|---|---|
content 为空,且 completion_tokens 等于你设的上限 | 推理用光了全部输出 token 上限 | 提高 max_tokens、调低 reasoning_effort,或者这项任务改用非推理模型 |
| HTTP 429 | 限流 | 退避后重试。我们在 Qwen 3.8 Flash 上遇到过 |
| JSON 或代码块解析失败 | 模型在答案前后加了说明文字 | 在提示里明确要求格式,并提取第一个代码块或 JSON 数组 |
| 某次运行要好几分钟 | 思考时间长或波动大 | 设置请求超时。对延迟敏感的任务,避免使用长推理模型 |
在 /v1 上调用 Claude 模型被拒,提示 “does not support the ‘openai’ protocol” | 自 2026 年 10 月 21 日起,ofox 模型目录中的 Claude 只列 Anthropic 协议;我们在 10 月 21 日和 22 日的测试中遇到了这个报错 | 使用 Anthropic SDK,base URL 设为 https://api.ofox.io/anthropic。在 10 月 22 日的测试中,/anthropic/v1/messages 接受了 claude-sonnet-5.5 和 anthropic/claude-sonnet-5.5 这两种写法的模型 ID |
这次测试的局限
- 输入是合成的,而且很短,会议纪要大约一千个 token。
- 每个配置只跑了两到三次。通过率只代表这几次运行的情况,不是稳定的成功率。
- 会议纪要评分只检查“负责人 + 截止日期”的组合和是否多出条目,不评每项任务的措辞。
- 金额是 ofox 在 2026 年 10 月 20 日至 21 日的实际扣费;升级演示除外,它用的是 API 返回的用量乘以牌价。通过 OpenAI 兼容端点拿到的 Claude 响应里,没有提示缓存的明细。
- 价格和模型版本会变化。复用这些数字之前,请查看当前的 ofox 模型列表。
- 我们没有测试提示缓存策略、批处理 API 或语义缓存,这些内容见我们的降低 API 成本概览(英文)。
- 本文由 Ofox 发布,测试也在 Ofox 自己的平台上进行。
下载
所有文件都在 /blog/_assets/evidence/cost-per-correct-result-20261022/:
results-billed.csv:全部 86 次调用,含 token 数、得分和计费金额runner.py:测试运行器和评分脚本escalate.py、cron-task.txt、cron-tests.json:升级演示coding-tasks/results.csv:五个编程任务的检查结果- 输入和标准答案:
meeting_notes.md、meeting_notes_hard.md、ground_truth.json、ground_truth_hard.json、buggy_code.py、hidden_tests.py
运行前在环境变量里设置 OFOX_API_KEY。运行 escalate.py 之前,把 cron-task.txt 另存为 task.txt,把 cron-tests.json 另存为 tests.json,放在同一个文件夹里。编程任务的结果还包括 GLM 5.3 Flash 和 Qwen 3.8 Flash 在 6,000 token 上限下的运行,其中大部分返回了空回复,上文没有讨论。如果你想看的是费用与额度上限的关系,而不是单次调用成本,订阅这一侧可以参考我们的 Codex 每周额度和 Claude Code 用量上限两篇指南。
常见问题
- 按 token 计价最便宜的模型,完成一项任务也最便宜吗?
- 不一定。在难度更高的测试里,DeepSeek V4.1 Flash 的输出单价约为 GPT-6 Sol 的八分之一,但每次答对的成本是 $0.0059,Sol 只要 $0.0040。原因是 DeepSeek 用了约 4,900 个输出 token,其中 97% 是推理。
- 推理模型返回空回复,也要付钱吗?
- 要。API 返回的 usage 把 4,000 个输出 token 全部计入,ofox 账单也照此扣费。例如一次 DeepSeek V4.1 Flash 空回复扣了 $0.00480307。
- 这些结果能说明 Codex 或 ChatGPT 订阅额度能省多少吗?
- 不能。我们测的是 API 的 token 费用,订阅套餐没有公开用量如何折算成额度。