Сколько стоит правильный ответ LLM: 7 моделей и 86 оплаченных вызовов API
Семь моделей, одни и те же задачи: во что по счёту обходится правильный результат. Оплаченные пустые ответы и скрипт, который сначала проверяет ответ, а потом переходит к модели сильнее.
 Ofox
На проверенных нами повседневных задачах самая дешёвая модель выдала все те же совпадающие с эталоном ответы, что и самая дорогая, — при списанной сумме в 1/75 на протоколе встречи и в 1/45 на исправлении бага. На более сложной работе низкая цена за токен перестала предсказывать низкую цену за результат: DeepSeek V4.1 Flash и Qwen 3.8 Flash иногда тратили весь бюджет вывода на рассуждения, ничего не возвращали — и за это всё равно списывались деньги. Поэтому сравнивайте стоимость правильного результата и проверяйте ответ, прежде чем ему доверять.
Это текстовая версия нашего видеоразбора; ведущая в видео, Мари, сгенерирована ИИ. Команда ofox спроектировала и провела все тесты 20–21 октября 2026 года, сверила каждый вызов со счётом ofox и выложила скрипты и сырые результаты (ссылки ниже).
Смотреть на YouTube (на английском, 5 минут): How to Cut AI API Costs Without Losing Accuracy (7 Models Tested)
Для кого статья: для разработчиков и небольших команд, которые вызывают LLM через API и хотят тратить меньше, не действуя наугад. Квоту подписок в приложениях Codex, ChatGPT или Claude мы не измеряли: эти тарифы не публикуют, как использование пересчитывается в квоту.
Почему цена за токен — не та цифра
Между прайсом модели и вашим счётом стоят три вещи.
- От сложности задачи зависит, хватит ли дешёвой модели. Если она не справится, вы заплатите ещё раз — уже за более сильную.
- Рассуждающие модели засчитывают рассуждения в выходные токены.
reasoning_tokensвнутриcompletion_tokensоплачиваются, даже если вы их не видите. - Неудачи тоже оплачиваются. Пустой или неверный ответ стоит столько же токенов, сколько хороший.
Поэтому сопоставимая величина — стоимость правильного результата: списанная сумма за все прогоны, которые понадобились, чтобы получить ответ, прошедший вашу проверку. Ту же идею мы применяли к видео в статье о стоимости пригодного клипа (на английском), а в руководстве по маршрутизации Luna → Sol правила принятия решений изложены на условных примерах. Эта статья добавляет измеренные и реально списанные цифры.
Как мы тестировали
| Пункт | Подробности |
|---|---|
| Даты | Основной тест — 20 октября 2026 года; демонстрация эскалации и проверки на коде — 21 октября 2026 года |
| Доступ | OpenAI-совместимый эндпоинт ofox https://api.ofox.io/v1/chat/completions |
| Модели | anthropic/claude-opus-5.5, anthropic/claude-sonnet-5.5, anthropic/claude-haiku-5.5, openai/gpt-6-sol, openai/gpt-6-luna, deepseek/deepseek-v4.1-flash, qwen/qwen3.8-flash |
| Входные данные | Написаны нами: два протокола встреч и Python-функция с багами. Данных клиентов нет. |
| Оценка | Автоматическая. Протоколы: должна присутствовать каждая ожидаемая пара исполнитель + срок, без лишних пунктов (формулировка задач не оценивается). Код: восемь скрытых тестов в отдельном подпроцессе. |
| Повторы | Каждая оцениваемая конфигурация запускалась два или три раза. Это небольшой тест, а не бенчмарк. |
| Стоимость | Сумма, которую ofox фактически списал за каждый вызов; все 86 завершённых вызовов сопоставлены со счётом по модели, числу токенов и времени. |
86 завершённых вызовов — это 83 вызова основного теста плюс три дополнительных прогона GPT-6 Sol с низким уровнем рассуждений: каждый раз они совпали со всеми семью пунктами сложного протокола, по $0,003582 за прогон. В число 83 входят 17 неоцениваемых вызовов GPT-6 Luna из эксперимента с длинным диалогом, который мы исключили из статьи, потому что его две ветки не были равноценными задачами, и 6 вызовов GPT-6 Sol, сравнивавших низкий и высокий уровень рассуждений на исправлении бага (оба прошли; высокий обошёлся примерно на 18% дороже). Две тестовые записи упёрлись в лимит запросов (HTTP 429). 20 октября модели Claude были доступны через OpenAI-совместимый эндпоинт. С 21 октября ofox обслуживает их вместо этого через Anthropic-совместимый эндпоинт (/anthropic/v1).
Результат 1: повседневные задачи
Из протокола встречи — в список задач. В протоколе восемь задач со сроками и пять ловушек: идеи, за которые никто не отвечает, решение без даты, уведомление о техработах. Все модели нашли все восемь пар исполнитель + срок без лишних пунктов в обоих прогонах.
| Модель | Полностью совпавшие прогоны | Списано за прогон (в среднем) | Выходные токены (в среднем) |
|---|---|---|---|
| Claude Opus 5.5 | 2/2 | $0,019712 | 657 |
| Claude Sonnet 5.5 | 2/2 | $0,011491 | 820 |
| GPT-6 Sol | 2/2 | $0,004806 | 337 |
| DeepSeek V4.1 Flash | 2/2 | $0,002470 | 1908 |
| Qwen 3.8 Flash | 2/2 | $0,001405 | 1852 |
| Claude Haiku 5.5 | 2/2 | $0,000607 | 885 |
| GPT-6 Luna | 2/2 | $0,000262 | 381 |
За тот же совпавший результат Opus обошёлся в 75,2 раза дороже Luna. Скорость цена тоже не предсказывала: Luna отвечала примерно за 5 секунд, а DeepSeek V4.1 Flash в одном прогоне отвечала 264,5 секунды, в другом — 13,2.
Исправление функции с четырьмя багами. Функция объединяет пересекающиеся бронирования переговорных: она должна сортировать, объединять соприкасающиеся интервалы, сохранять более позднее время окончания и отбрасывать некорректные брони. Все модели прошли все восемь скрытых тестов в обоих прогонах. Opus в среднем стоил $0,010086 за прогон, Luna — $0,000225, разница в 44,8 раза.
Результат 2: задача посложнее и первые настоящие сбои
Простые задачи модели не различают, поэтому мы написали протокол, в котором участники по ходу встречи меняют решения; дата встречи — вторник, 20 октября 2026 года. Одну задачу передают от Priya к Omar, срок сдвигается с 27-го на 31-е, одну задачу отменяют, а даты указаны относительно: “tomorrow”, “two business days from today”, “end of next week”. Правильных пунктов семь. Вывод был ограничен 4000 токенов.
| Модель | Полностью совпавшие прогоны | Списано за прогон (в среднем) | Что пошло не так |
|---|---|---|---|
| Claude Opus 5.5 | 3/3 | $0,019053 | Ничего |
| Claude Sonnet 5.5 | 3/3 | $0,011207 | Ничего |
| GPT-6 Sol | 3/3 | $0,003999 | Ничего |
| GPT-6 Luna | 3/3 | $0,000276 | Ничего |
| Claude Haiku 5.5 | 2/3 | $0,000675 | В одном прогоне пропущен пункт со сроком “end of next week” |
| Qwen 3.8 Flash | 1/2 | $0,002938 | Один пустой ответ; второй запрос упёрся в лимит запросов |
| DeepSeek V4.1 Flash | 1/3 | $0,004423 | Два пустых ответа |
Сбои DeepSeek и Qwen были не неверными ответами, а пустыми. В каждом из них completion_tokens и reasoning_tokens равнялись 4000 — весь лимит, — а content был пустой строкой.
Пустые ответы оплачиваются
Мы проверили счёт. На странице Activity в ofox виден запрос от 20 октября в 15:07:37 (в интерфейсе — 3:07:37 PM): 4K выходных токенов, из них 4K рассуждений, списано $0,00480307.
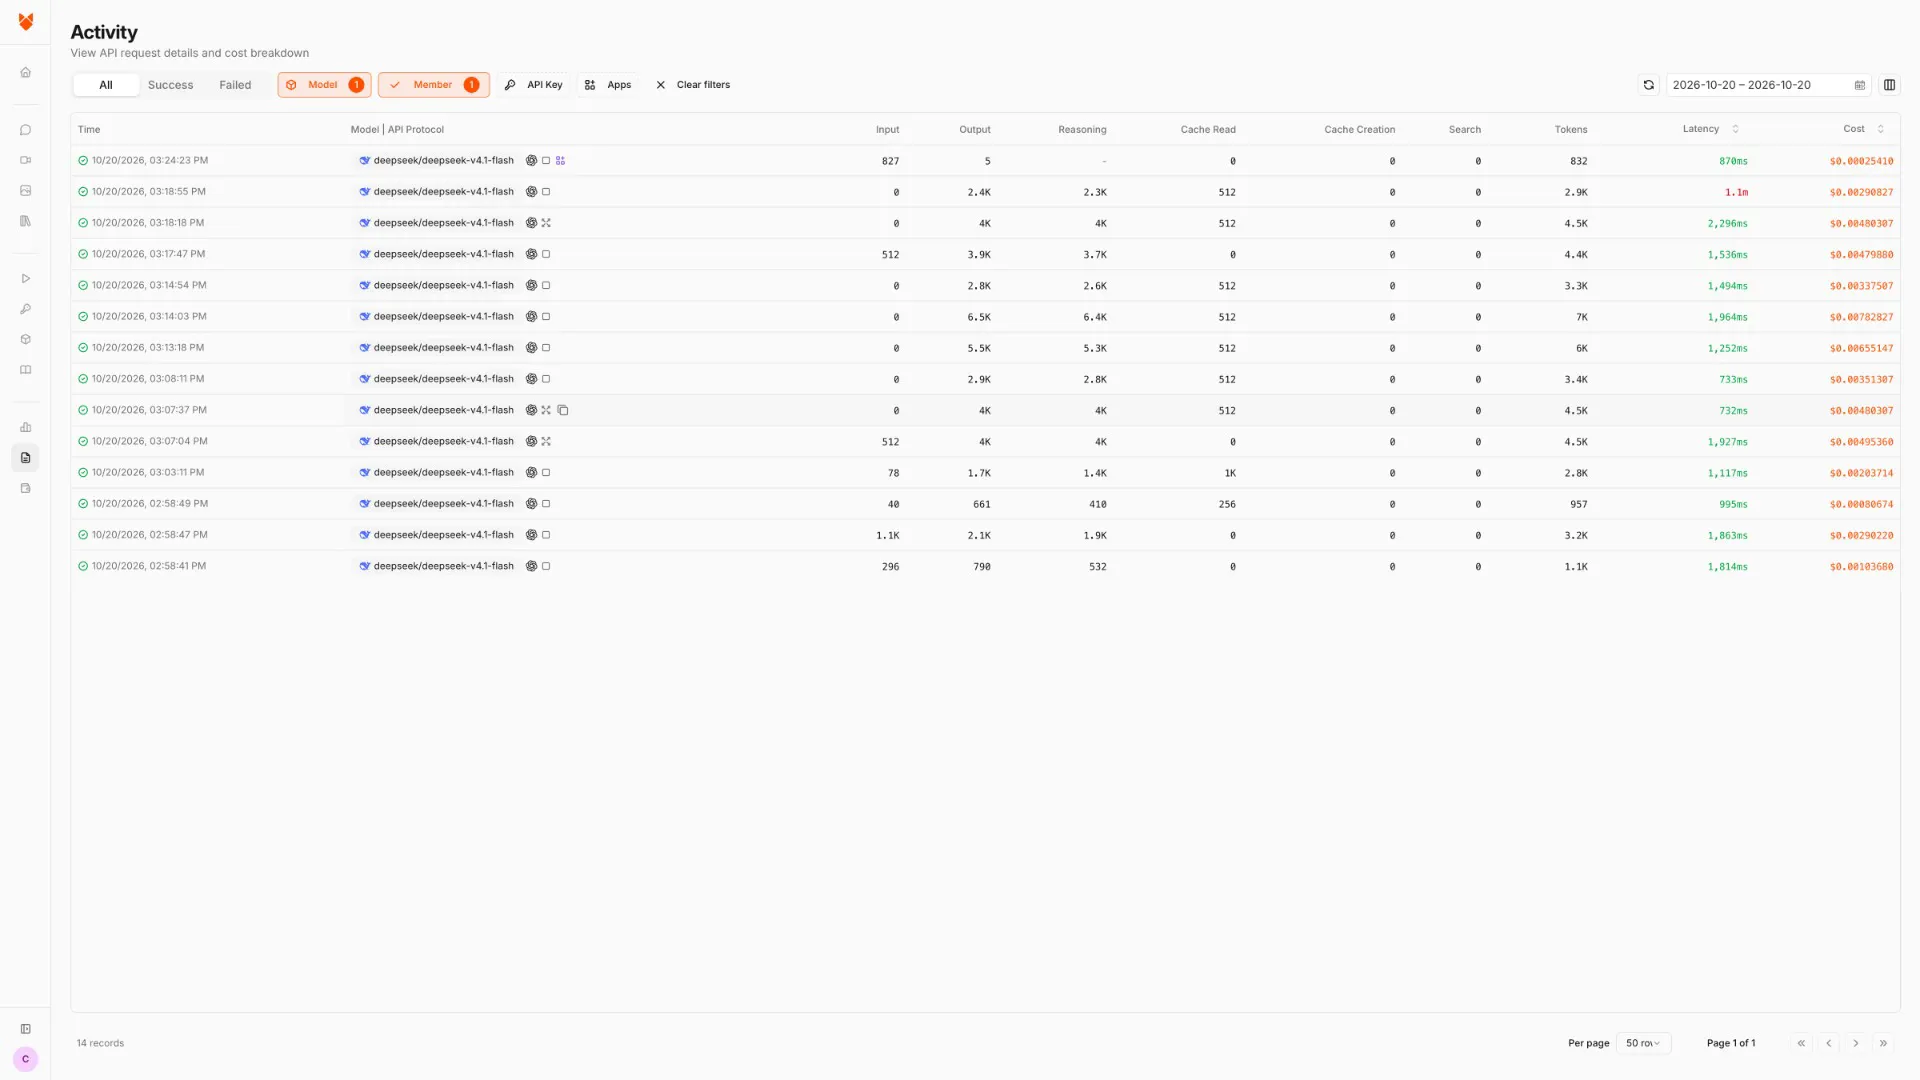
На скриншоте — настоящая панель на английском языке; перед записью мы отфильтровали её по нашим собственным тестовым запросам. Команда, баланс и данные других участников не показаны. Два пустых ответа DeepSeek в этом тесте обошлись в $0,004803072 и $0,0049536.
Как обойти ловушку рассуждающих моделей
Мы повторно запустили DeepSeek V4.1 Flash и Qwen 3.8 Flash на том же сложном протоколе — с бо́льшим запасом токенов или с пониженным уровнем рассуждений. По три прогона на каждую настройку.
| Настройка | Полностью совпавшие прогоны | Списано за прогон (в среднем) | Выходные токены (в среднем) | Время ответа (медиана) |
|---|---|---|---|---|
| DeepSeek V4.1 Flash, лимит 16 000 | 3/3 | $0,005918 | 4929 | 45,2 с |
DeepSeek V4.1 Flash, reasoning_effort: "low" | 2/3 | $0,004170 | 3431 | 37,2 с |
| Qwen 3.8 Flash, лимит 16 000 | 3/3 | $0,002560 | 3348 | 41,4 с |
Qwen 3.8 Flash, reasoning_effort: "low" | 3/3 | $0,000682 | 910 | 17,5 с |
Когда токенов хватало до конца ответа, DeepSeek каждый раз решала задачу правильно, но каждый правильный прогон стоил $0,0059. GPT-6 Sol справилась с той же задачей за $0,0040, потратив около 305 выходных токенов. По прайсу ofox у DeepSeek V4.1 Flash $0,30 за вход и $1,20 за выход за миллион токенов, у GPT-6 Sol — $2,00 и $10,00: примерно 1/7 цены входа и 1/8 цены выхода. И всё же за правильный результат DeepSeek обошлась дороже, потому что около 96,7% её вывода составляли рассуждения.
Снижение уровня рассуждений здесь сильнее всего помогло Qwen: все три прогона совпали, по $0,000682 каждый, медиана — 17,5 секунды. DeepSeek это не исправило: на низком уровне она всё равно вернула один пустой ответ. В этих тестах по три прогона именно повышение лимита позволило DeepSeek проходить каждый раз.
Отсюда два практических правила:
- Задавайте лимит вывода и уровень рассуждений осознанно, а пустой
contentсfinish_reason: "length"считайте сбоем, а не ответом. - Сравнивайте списанную стоимость правильного результата, а не только цену за миллион токенов. Наш калькулятор окупаемости маршрутизации показывает, как повторы и резервные вызовы меняют эту величину.
Сначала проверка, потом модель сильнее
Обычный совет — начинать с дешёвой модели и переходить на более сильную, когда она не справляется. На практике для «не справляется» нужна проверка, которую можно запустить. Для кода такая проверка — тесты. Скрипт ниже запускает модели от самой дешёвой, прогоняет тесты на каждом ответе и переходит выше, только если они не проходят.
Чтобы показать, как срабатывает страховка, нам нужна была дешёвая модель, которая ошибается. GPT-6 Luna не ошиблась ни разу: она прошла все 7 своих оцениваемых прогонов в основном тесте и 15 из 15 на пяти задачах по программированию, которые мы написали специально для этого (рабочие дни, разбор длительностей, разделение счёта, расписания cron и переход на летнее время). GPT-6 Sol на низком уровне рассуждений в одном из своих 18 прогонов на коде провалила три случая (разбор длительностей, 16 из 19). Поэтому демонстрация начинается с DeepSeek V4.1 Flash: на одной из этих задач — функции, вычисляющей время следующего запуска cron, с двенадцатью тестами — она возвращала пустые ответы во всех трёх своих прогонах при лимите 4000 токенов.
import json, os, re
from openai import OpenAI

client = OpenAI(base_url="https://api.ofox.io/v1",
                api_key=os.environ["OFOX_API_KEY"])

# Cheapest first. $ per 1M tokens (in, out), ofox, Oct 2026
TIERS = [
    ("deepseek/deepseek-v4.1-flash", 0.30, 1.20, {}),
    ("openai/gpt-6-sol", 2.00, 10.00,
     {"reasoning_effort": "low"}),
]

def passes(reply):
    m = re.search(r"```(?:python)?\n(.*?)```", reply, re.S)
    if not m:
        return 0
    ns = {}
    exec(m.group(1), ns)
    tests = json.load(open("tests.json"))
    return sum(ns["next_run"](*a) == want for a, want in tests)

task, total = open("task.txt").read(), 0.0
for model, p_in, p_out, extra in TIERS:
    r = client.chat.completions.create(
        model=model, max_tokens=4000,
        messages=[{"role": "user", "content": task}], **extra)
    u = r.usage
    cost = (u.prompt_tokens * p_in + u.completion_tokens * p_out) / 1e6
    total += cost
    ok = passes(r.choices[0].message.content or "")
    print(f"{model}\n  {u.completion_tokens} out tokens  ${cost:.4f}  tests {ok}/12")
    if ok == 12:
        print(f"PASS  total ${total:.4f}")
        break
    print("  check failed -> moving up")
Реальный запуск 21 октября 2026 года:
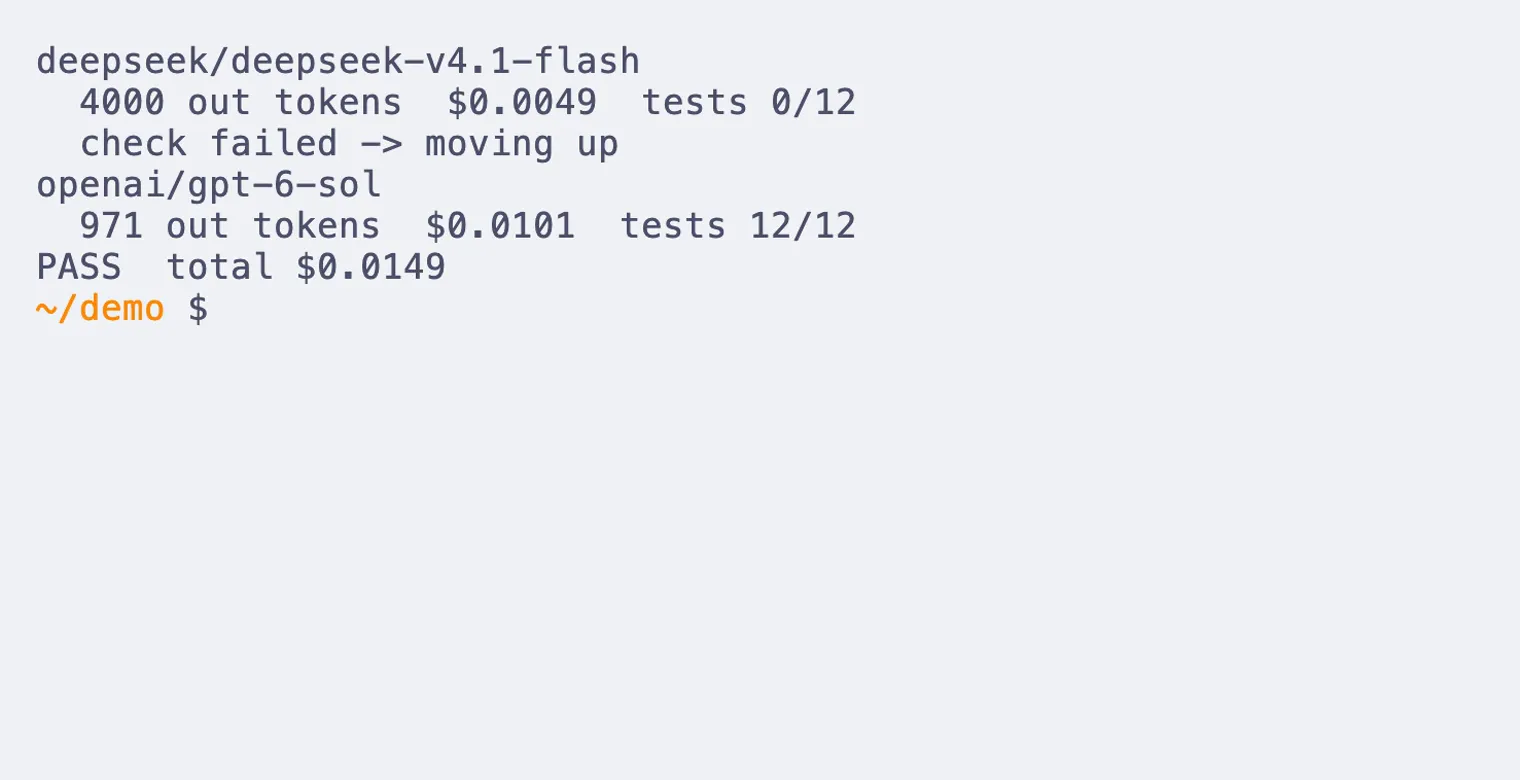
deepseek/deepseek-v4.1-flash
  4000 out tokens  $0.0049  tests 0/12
  check failed -> moving up
openai/gpt-6-sol
  971 out tokens  $0.0101  tests 12/12
PASS  total $0.0149
Стоимость в этом выводе — это usage, который вернул API, умноженный на прайс ofox. Посмотрите на итог. Неудачная попытка DeepSeek добавила около половины цента, так что этот запуск обошёлся дороже, чем если бы мы сразу начали с Sol.
Проверка нужна не для того, чтобы каждый раз пробовать дешёвую модель. Она показывает, с какой модели стоит начинать каждый тип задач. Для этой задачи DeepSeek V4.1 Flash оказалась неверным первым уровнем. GPT-6 Luna, которая дешевле за токен, чем обе эти модели, прошла ту же задачу с cron во всех трёх своих прогонах (в той проверке лимит был 6000 токенов), а также совпала по каждому пункту протоколов встреч. По нашим прогонам, извлечение данных вроде задачи с протоколом и эти пять задач по программированию можно начинать с Luna. Начинайте с модели выше только там, где ваша собственная проверка показывает, что дешёвая модель не справляется, и оставляйте путь эскалации для таких случаев.
Учтите: exec выполняет написанный моделью код в вашем процессе. Для демонстрации на коде, который вы всё равно собираетесь просмотреть, это допустимо. Для любой автоматизации запускайте тесты в песочнице или подпроцессе, как это делает наш полный тестовый скрипт.
Как применить это к своей работе
В реальной работе эталонных ответов у вас нет, поэтому соберите небольшой набор сами.
- Выберите три задачи, которые вы выполняете каждый день, и сохраните для каждой от пяти до десяти реальных входных данных.
- Напишите проверку до того, как выбирать модель. Для кода — несколько тестов. Для извлечения данных — ожидаемые поля плюс выборочная сверка нескольких пунктов с источником. Для резюме — короткий список фактов, которые обязаны в нём быть.
- Запустите самую дешёвую из подходящих моделей два-три раза на каждом входе и запишите долю успешных прогонов, выходные токены и списанную сумму. Смотрите на счёт, а не на свою оценку. Модели с интенсивными рассуждениями могут стоить гораздо дороже, чем подсказывает их тариф.
- Назначьте для каждой задачи стартовую модель — самую дешёвую из тех, что стабильно проходят проверку в ваших прогонах. Эскалацию используйте для сбоев, а не как путь по умолчанию.
- Повторяйте проверку, когда меняются цены или версии моделей.
| Симптом | Вероятная причина | Что делать |
|---|---|---|
content пустой, а completion_tokens равен вашему лимиту | Рассуждения израсходовали весь бюджет вывода | Повысьте max_tokens, понизьте reasoning_effort или возьмите для этой задачи модель без рассуждений |
| HTTP 429 | Лимит запросов | Подождите и повторите запрос. Мы встречали это у Qwen 3.8 Flash. |
| JSON или блок кода не разбирается | Модель добавила текст вокруг ответа | Явно укажите формат и извлекайте первый блок в тройных обратных кавычках или первый JSON-массив |
| Один прогон длится минуты | Долгое или нестабильное время рассуждений | Задайте таймаут запроса. Для задач, чувствительных к задержке, избегайте моделей с долгими рассуждениями. |
Модель Claude отклоняется на /v1 с ошибкой “does not support the ‘openai’ protocol” | С 21 октября 2026 года каталог ofox указывает для Claude только протокол Anthropic; эту ошибку мы видели в тестах 21 и 22 октября | Используйте Anthropic SDK с базовым URL https://api.ofox.io/anthropic. В нашем тесте 22 октября идентификаторы вида claude-sonnet-5.5 и anthropic/claude-sonnet-5.5 принимались на /anthropic/v1/messages. |
Ограничения теста
- Входные данные синтетические и короткие. Протоколы встреч — около тысячи токенов.
- Каждая конфигурация запускалась два или три раза. Считайте доли успеха тем, что произошло в этих прогонах, а не стабильными показателями.
- Оценка протоколов проверяет пары исполнитель + срок и лишние пункты. Формулировку каждой задачи она не оценивает.
- Суммы — это то, что ofox списал 20–21 октября 2026 года; исключение — демонстрация эскалации, где используется usage из ответа API, умноженный на прайс. В ответах Claude, полученных через OpenAI-совместимый эндпоинт, не было разбивки по кешу промптов.
- Цены и версии моделей меняются. Прежде чем использовать эти цифры, проверьте актуальный список моделей ofox.
- Мы не тестировали стратегии кеширования промптов, пакетные API и семантическое кеширование. Об этом — наш обзор способов снизить расходы (на английском).
- Статью опубликовал ofox, и тесты проводились на его собственной платформе.
Файлы для скачивания
Все файлы лежат в /blog/_assets/evidence/cost-per-correct-result-20261022/:
results-billed.csv: все 86 вызовов с токенами, оценкой и списанной суммойrunner.py: тестовый скрипт и функции оценкиescalate.py,cron-task.txt,cron-tests.json: демонстрация эскалацииcoding-tasks/results.csv: проверки на пяти задачах по программированию- Входные данные и эталонные ответы:
meeting_notes.md,meeting_notes_hard.md,ground_truth.json,ground_truth_hard.json,buggy_code.py,hidden_tests.py
Чтобы их запустить, задайте в окружении OFOX_API_KEY. Перед запуском escalate.py сохраните cron-task.txt как task.txt, а cron-tests.json — как tests.json в той же папке. В результатах задач по программированию есть также прогоны GLM 5.3 Flash и Qwen 3.8 Flash с лимитом 6000 токенов; большинство из них вернули пустые ответы, и выше они не разбираются. Если вы хотите соотносить расходы с лимитами, а не с отдельными вызовами, подписочную сторону разбирают наши руководства о недельных лимитах Codex и лимитах использования Claude Code (на английском).
Часто задаваемые вопросы
- Самая дешёвая модель за токен — самая дешёвая и за задачу?
- Не всегда. В нашем сложном тесте выходной токен DeepSeek V4.1 Flash стоил примерно в восемь раз меньше, чем у GPT-6 Sol, но правильный прогон обходился в $0,0059 против $0,0040 у Sol: модель расходовала около 4900 выходных токенов, 97% из них приходилось на рассуждения.
- Платим ли мы за пустые ответы рассуждающих моделей?
- Да. В usage, который вернул API, учитывались все 4000 выходных токенов, и ofox их списал: например, $0,00480307 за один пустой ответ DeepSeek V4.1 Flash.
- Можно ли по этим данным понять, сколько квоты подписки Codex или ChatGPT я сэкономлю?
- Нет. Мы измеряли стоимость токенов API. Подписочные тарифы не публикуют, как использование пересчитывается в квоту.