安いLLMで足りる?7モデルの「正解1件あたりの費用」を請求額で比較
7モデルに同じタスクを解かせ、正しい結果1件に実際いくら請求されたかを86回のAPI呼び出しで集計しました。空の応答も課金される落とし穴と、検証してから上位モデルへ切り替えるスクリプトも紹介します。
 Ofox
今回テストした日常的なタスクでは、最も安いモデルが最も高いモデルと同じ答えをすべて出し、請求額は議事録の処理で75分の1、バグ修正で45分の1でした。 ただし、難しいタスクになると、トークン単価の安さが結果1件あたりの安さにつながらなくなりました。DeepSeek V4.1 FlashとQwen 3.8 Flashは、出力枠をすべて思考に使い切って何も返さないことがあり、その分も課金されました。比べるべきは正しい結果1件にかかる費用で、その結果を信用する前に検証が必要です。
この記事は動画解説の文章版です。動画の進行役MarieはAIで生成したプレゼンターです。テストはすべてofoxチームが設計し、2026年10月20日から21日にかけて実施しました。各呼び出しをofoxの請求と突き合わせ、スクリプトと生の結果を記事末尾で公開しています。
YouTubeで見る(英語・5分):How to Cut AI API Costs Without Losing Accuracy (7 Models Tested)
対象読者は、LLM APIを呼び出していて、当て推量ではなく根拠を持って費用を下げたい開発者や小規模チームです。Codex、ChatGPT、Claudeアプリのサブスクリプション枠は測っていません。これらのプランは、利用量が枠にどう換算されるかを公開していないためです。
トークン単価が指標として不適切な理由
モデルの料金表と実際の請求額のあいだには、3つの要素があります。
- 安いモデルで足りるかどうかは、タスクの難しさで決まります。 失敗すれば、より強いモデルでもう一度料金を払うことになります。
- 推論モデルは思考を出力として課金します。
completion_tokensに含まれるreasoning_tokensは、画面に表示されなくても課金対象です。 - 失敗にも料金がかかります。 空の答えや誤った答えも、良い答えと同じだけトークンを消費します。
そのため、比較できる数字は「正解1件あたりの費用」です。これは、自分のチェックに合格する答えが得られるまでに要した実行の請求額を指します。動画生成でも同じ考え方を使えるクリップ1本あたりの費用(英語記事)で使いました。またLunaとSolの振り分けガイドでは、作例を用いて判断ルールを整理しています。この記事では、実測した請求額を加えます。
テスト方法
| 項目 | 内容 |
|---|---|
| 日付 | メインテストは2026年10月20日、上位モデルへの切り替えデモとコーディングの追加検証は2026年10月21日 |
| 接続先 | ofoxのOpenAI互換エンドポイント https://api.ofox.io/v1/chat/completions |
| モデル | anthropic/claude-opus-5.5、anthropic/claude-sonnet-5.5、anthropic/claude-haiku-5.5、openai/gpt-6-sol、openai/gpt-6-luna、deepseek/deepseek-v4.1-flash、qwen/qwen3.8-flash |
| 入力 | 自作の議事録2種類と、バグのあるPython関数1つ。顧客データは使っていません。 |
| 採点 | 自動採点。議事録:想定される「担当者と期限」の組がすべて含まれ、余計な項目がないこと(タスクの言い回しは採点対象外)。コード:サブプロセスで実行する非公開テスト8件。 |
| 試行回数 | 採点対象の各設定を2〜3回実行。小規模なテストであり、ベンチマークではありません。 |
| 費用 | 各呼び出しにofoxが実際に請求した金額。完了した86件すべてについて、モデル、トークン数、時刻で照合しました。 |
完了した86件の内訳は、メインテストの83件に、GPT-6 Solを推論レベルlowで追加実行した3件を加えたものです。この3件は、難しい方の議事録で毎回7項目すべてに一致し、1回あたり$0.003582でした。83件には、長い会話の実験で行った採点なしのGPT-6 Luna呼び出し17件が含まれます。この実験は比較する2つの条件が同等のタスクになっていなかったため、記事からは外しました。また、バグ修正でGPT-6 Solの推論レベルlowとhighを比べた6件も含まれます(どちらも合格し、highの費用は約18%多くなりました)。テスト記録のうち2件はレート制限(HTTP 429)に当たりました。10月20日の時点では、ClaudeモデルにはOpenAI互換エンドポイントから接続できました。10月21日以降、ofoxはClaudeモデルをOpenAI互換エンドポイントではなく、Anthropic互換エンドポイント(/anthropic/v1)で提供しています。
結果1:日常的なタスク
議事録からアクションアイテムを抜き出す。 議事録には、日付付きのアクションアイテムが8件と、5つのひっかけを入れました。担当者のいないアイデア、日付のない決定事項、メンテナンスのお知らせなどです。すべてのモデルが、2回の実行とも「担当者と期限」の組8件をすべて見つけ、余計な項目はありませんでした。
| モデル | 完全一致した回数 | 1回あたりの請求額(平均) | 出力トークン(平均) |
|---|---|---|---|
| Claude Opus 5.5 | 2/2 | $0.019712 | 657 |
| Claude Sonnet 5.5 | 2/2 | $0.011491 | 820 |
| GPT-6 Sol | 2/2 | $0.004806 | 337 |
| DeepSeek V4.1 Flash | 2/2 | $0.002470 | 1,908 |
| Qwen 3.8 Flash | 2/2 | $0.001405 | 1,852 |
| Claude Haiku 5.5 | 2/2 | $0.000607 | 885 |
| GPT-6 Luna | 2/2 | $0.000262 | 381 |
同じく完全一致という結果に対して、OpusはLunaの75.2倍の費用がかかりました。価格は速度の目安にもなりませんでした。Lunaは約5秒で答えましたが、DeepSeek V4.1 Flashは一方の実行で264.5秒、もう一方で13.2秒かかりました。
4つのバグがある関数を修正する。 この関数は重複する会議室の予約をまとめるもので、並べ替え、接している時間帯の結合、遅い方の終了時刻の保持、無効な予約の除外が必要です。すべてのモデルが2回とも非公開テスト8件に合格しました。1回あたりの平均はOpusが$0.010086、Lunaが$0.000225で、差は44.8倍です。
結果2:難しいタスクで初めて出た失敗
簡単なタスクではモデル間の差が出ないため、会議の途中で参加者が考えを変える議事録を用意しました。日付は2026年10月20日(火)です。あるタスクの担当はPriyaからOmarに変わり、ある締め切りは27日から31日に延び、1つのタスクは取りやめになります。日付は”tomorrow”(明日)、“two business days from today”(今日から2営業日後)、“end of next week”(来週末)のような相対表現です。正解の項目は7件で、出力の上限は4,000トークンにしました。
| モデル | 完全一致した回数 | 1回あたりの請求額(平均) | 問題点 |
|---|---|---|---|
| Claude Opus 5.5 | 3/3 | $0.019053 | なし |
| Claude Sonnet 5.5 | 3/3 | $0.011207 | なし |
| GPT-6 Sol | 3/3 | $0.003999 | なし |
| GPT-6 Luna | 3/3 | $0.000276 | なし |
| Claude Haiku 5.5 | 2/3 | $0.000675 | 1回、“end of next week”の項目が抜けた |
| Qwen 3.8 Flash | 1/2 | $0.002938 | 空の応答が1回。もう1件のリクエストはレート制限に当たった |
| DeepSeek V4.1 Flash | 1/3 | $0.004423 | 空の応答が2回 |
DeepSeekとQwenの失敗は、誤答ではなく空の応答でした。どの失敗でもcompletion_tokensとreasoning_tokensがともに上限いっぱいの4,000で、contentは空文字列でした。
空の応答にも課金される
請求を確認しました。ofoxのActivityページには、10月20日 3:07:37 PMのリクエストが記録されています。出力4Kトークンのうち4Kが推論で、請求額は$0.00480307でした。
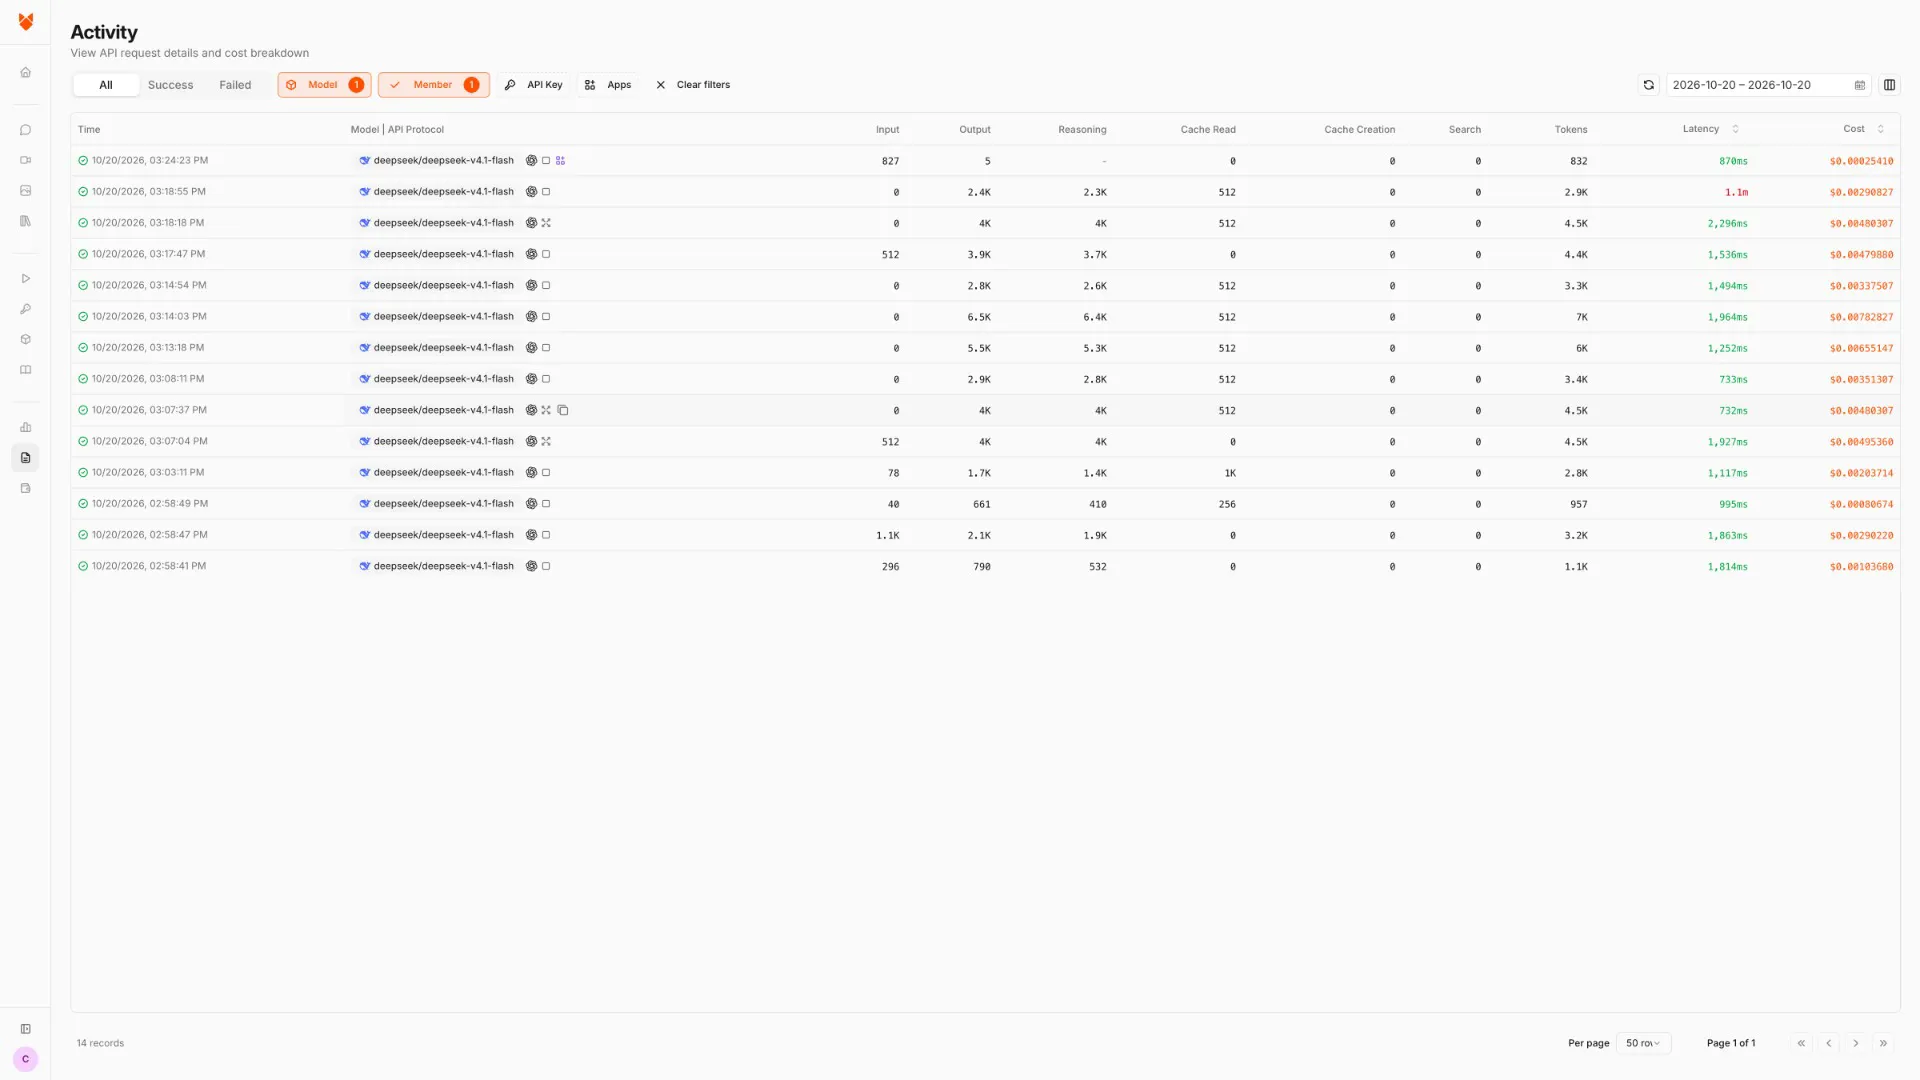
スクリーンショットは実際のダッシュボードで、英語表示のままです。録画の前に自分たちのテストリクエストだけに絞り込んであり、チーム、残高、他のメンバーのデータは表示していません。このテストでのDeepSeekの空の応答2件には、それぞれ$0.004803072と$0.0049536が請求されました。
推論モデルの落とし穴への対処
DeepSeek V4.1 FlashとQwen 3.8 Flashを、同じ難しい議事録で、出力枠を広げるか推論レベルを下げて再実行しました。それぞれ3回ずつです。
| 設定 | 完全一致した回数 | 1回あたりの請求額(平均) | 出力トークン(平均) | 応答時間(中央値) |
|---|---|---|---|---|
| DeepSeek V4.1 Flash、上限16,000 | 3/3 | $0.005918 | 4,929 | 45.2秒 |
DeepSeek V4.1 Flash、reasoning_effort: "low" | 2/3 | $0.004170 | 3,431 | 37.2秒 |
| Qwen 3.8 Flash、上限16,000 | 3/3 | $0.002560 | 3,348 | 41.4秒 |
Qwen 3.8 Flash、reasoning_effort: "low" | 3/3 | $0.000682 | 910 | 17.5秒 |
出力枠に余裕があれば、DeepSeekは毎回正解しましたが、正解1件あたり$0.0059かかりました。GPT-6 Solは同じタスクを、出力トークン約305で$0.0040でこなしています。ofoxの価格表では、DeepSeek V4.1 Flashは100万トークンあたり入力$0.30・出力$1.20、GPT-6 Solは入力$2.00・出力$10.00です。DeepSeekは入力単価が約7分の1、出力単価が約8分の1です。それでも正解1件あたりではDeepSeekの方が高くつきました。出力の約96.7%が思考だったためです。
今回、推論レベルを下げて最も効果があったのはQwenです。3回すべて完全一致し、1回あたり$0.000682、応答時間の中央値は17.5秒でした。一方、DeepSeekはlowでも空の応答が1回出ており、解決しませんでした。この3回ずつのテストでは、DeepSeekが毎回合格したのは出力上限を引き上げた設定でした。
ここから実務上のルールが2つ導けます。
- 出力上限と推論レベルは意図して設定してください。
contentが空でfinish_reason: "length"になっている応答は、答えではなく失敗として扱います。 - 正解1件あたりの請求額で比較してください。 100万トークンあたりの単価だけで判断してはいけません。リトライやフォールバックでこの数字がどう変わるかは、ルーティングの損益分岐点計算で解説しています。
検証してから上位モデルへ
よくある助言は、安いモデルから始めて、失敗したら上位のモデルに切り替えるというものです。ただし実際には、「失敗したら」を判定するために実行できるチェックが必要です。コードの場合、そのチェックはテストです。以下のスクリプトは安いモデルから順に呼び出し、各応答にテストを実行して、不合格のときだけ次のモデルに進みます。
このセーフティネットが働く様子を見せるには、失敗する安いモデルが必要でした。ところがGPT-6 Lunaは一度も失敗しませんでした。メインテストでは採点対象の7回すべてに合格し、今回のために作った5つのコーディングタスク(営業日の計算、所要時間の解析、割り勘、cronスケジュール、夏時間をまたぐ時刻)でも15回中15回合格しています。推論レベルlowのGPT-6 Solは、18回のコーディング実行のうち1回(所要時間の解析)で3ケースを落とし、19件中16件の合格でした。そこでデモはDeepSeek V4.1 Flashから始めます。DeepSeekは、そのうちの1つである12件のテスト付きのcron「次回実行時刻」関数で、上限4,000トークンの3回の実行すべてで空の応答を返したモデルです。
import json, os, re
from openai import OpenAI

client = OpenAI(base_url="https://api.ofox.io/v1",
                api_key=os.environ["OFOX_API_KEY"])

# Cheapest first. $ per 1M tokens (in, out), ofox, Oct 2026
TIERS = [
    ("deepseek/deepseek-v4.1-flash", 0.30, 1.20, {}),
    ("openai/gpt-6-sol", 2.00, 10.00,
     {"reasoning_effort": "low"}),
]

def passes(reply):
    m = re.search(r"```(?:python)?\n(.*?)```", reply, re.S)
    if not m:
        return 0
    ns = {}
    exec(m.group(1), ns)
    tests = json.load(open("tests.json"))
    return sum(ns["next_run"](*a) == want for a, want in tests)

task, total = open("task.txt").read(), 0.0
for model, p_in, p_out, extra in TIERS:
    r = client.chat.completions.create(
        model=model, max_tokens=4000,
        messages=[{"role": "user", "content": task}], **extra)
    u = r.usage
    cost = (u.prompt_tokens * p_in + u.completion_tokens * p_out) / 1e6
    total += cost
    ok = passes(r.choices[0].message.content or "")
    print(f"{model}\n  {u.completion_tokens} out tokens  ${cost:.4f}  tests {ok}/12")
    if ok == 12:
        print(f"PASS  total ${total:.4f}")
        break
    print("  check failed -> moving up")
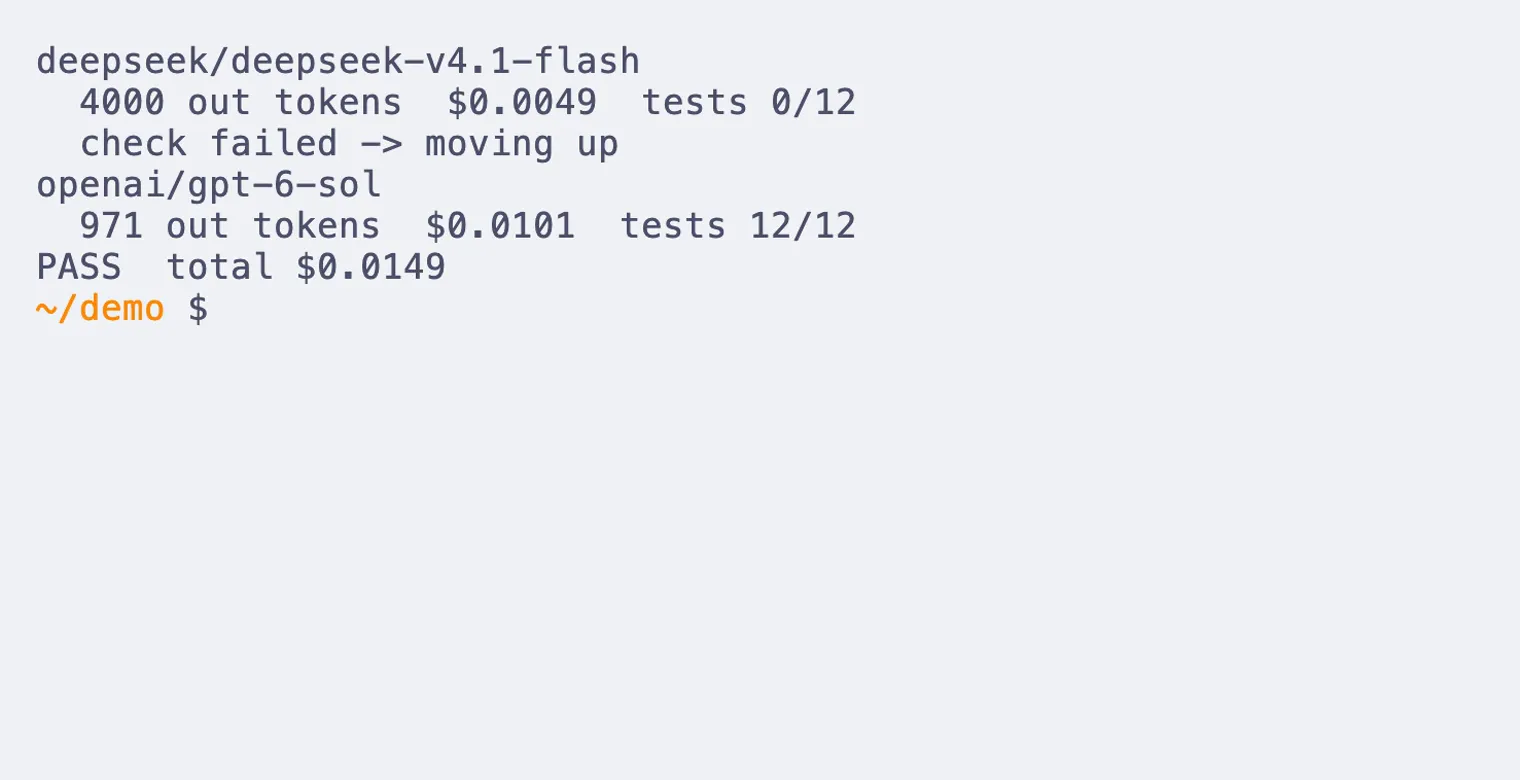
2026年10月21日の実際の実行結果です。
deepseek/deepseek-v4.1-flash
  4000 out tokens  $0.0049  tests 0/12
  check failed -> moving up
openai/gpt-6-sol
  971 out tokens  $0.0101  tests 12/12
PASS  total $0.0149
ここに表示される費用は、APIが返したトークン使用量にofoxの表示価格を掛けたものです。合計に注目してください。DeepSeekでの失敗が約0.5セント上乗せされたため、この実行は最初からSolで始めた場合より高くつきました。
チェックの目的は、毎回安いモデルを試させることではありません。タスクの種類ごとに、どのモデルから始めるべきかを教えてくれるのがチェックです。このタスクでは、DeepSeek V4.1 Flashは最初の段として不適切でした。トークン単価がDeepSeekとSolのどちらよりも安いGPT-6 Lunaは、同じcronタスクで3回すべて合格し(この検証での上限は6,000トークン)、議事録でもすべての項目に一致しています。今回の実行結果からは、議事録タスクのような抽出作業と、この5つのコーディングタスクはLunaから始めてよいと判断できます。上位モデルから始めるのは、自分のチェックで安いモデルの失敗が確認されたタスクに限り、そうしたケースのために切り替えの経路を残しておきましょう。
なお、execはモデルが書いたコードを自分のプロセス内で実行します。どのみちレビューするコードを使ったデモであれば許容範囲です。自動化する処理では、今回のテストランナーと同様に、サンドボックスかサブプロセスでテストを実行してください。
自分の業務に当てはめる方法
実際の業務には正解表がないので、小さな正解表を自分で作ります。
- 毎日実行するタスクを3つ選び、それぞれ実際の入力を5〜10件保存します。
- モデルを選ぶ前にチェックを書きます。 コードなら少数のテスト、抽出なら期待するフィールドに加え、いくつかの項目を元データと照らし合わせる抜き取り確認、要約なら必ず含まれるべき事実の短いリストです。
- 候補になりうる最も安いモデルを、入力ごとに2〜3回実行し、合格率、出力トークン、請求額を記録します。見積もりではなく請求を確認してください。推論を多用するモデルは、単価から想像するよりはるかに高くつくことがあります。
- 各タスクの開始モデルを、自分の実行で安定して合格した最も安いモデルに設定します。 上位モデルへの切り替えは失敗時の手段として使い、標準の経路にはしません。
- 価格やモデルのバージョンが変わったら、チェックを再実行します。
| 症状 | 考えられる原因 | 対処 |
|---|---|---|
contentが空で、completion_tokensが設定した上限と同じ | 推論が出力枠をすべて使い切った | max_tokensを上げる、reasoning_effortを下げる、またはこのタスクには推論なしのモデルを使う |
| HTTP 429 | レート制限 | 間隔を空けてリトライする。今回はQwen 3.8 Flashで発生した。 |
| JSONやコードブロックをパースできない | モデルが答えの前後に説明文を加えた | 形式を明示的に指定し、最初のコードフェンスかJSON配列を抽出する |
| 1回の実行に数分かかる | 思考時間が長い、またはばらつく | リクエストのタイムアウトを設定する。レイテンシが重要なタスクでは長く推論するモデルを避ける。 |
/v1でClaudeモデルが”does not support the ‘openai’ protocol”として拒否される | 2026年10月21日以降、ofoxのカタログではClaudeがAnthropicプロトコルのみで掲載されている。このエラーは10月21日と22日のテストで確認した | ベースURLをhttps://api.ofox.io/anthropicにしてAnthropic SDKを使う。10月22日のテストでは、claude-sonnet-5.5形式とanthropic/claude-sonnet-5.5形式のIDが/anthropic/v1/messagesで受け付けられた。 |
このテストの限界
- 入力は合成データで、短いものです。議事録は約1,000トークンです。
- 各設定の実行は2〜3回です。合格率は今回の実行で起きたこととして扱い、安定した成功率とはみなさないでください。
- 議事録の採点では、「担当者と期限」の組と余計な項目の有無を確認しています。各タスクの言い回しは採点していません。
- 金額は2026年10月20〜21日にofoxが請求したものです。ただし切り替えデモは、APIが報告した使用量に表示価格を掛けた値です。OpenAI互換エンドポイント経由で受け取ったClaudeの応答には、プロンプトキャッシュの内訳が含まれていませんでした。
- 価格とモデルのバージョンは変わります。これらの数字を流用する前に、最新のofoxモデル一覧を確認してください。
- プロンプトキャッシュの戦略、バッチAPI、セマンティックキャッシュはテストしていません。これらはコスト削減の概要(英語記事)で扱っています。
- この記事はOfoxが公開し、テストも自社プラットフォーム上で実施しました。
ダウンロード
すべてのファイルは/blog/_assets/evidence/cost-per-correct-result-20261022/にあります。
results-billed.csv:全86件の呼び出しのトークン数、スコア、請求額runner.py:テストランナーと採点スクリプトescalate.py、cron-task.txt、cron-tests.json:切り替えデモcoding-tasks/results.csv:5つのコーディングタスクの検証結果- 入力と正解表:
meeting_notes.md、meeting_notes_hard.md、ground_truth.json、ground_truth_hard.json、buggy_code.py、hidden_tests.py
実行するには、環境変数OFOX_API_KEYを設定してください。escalate.pyを実行する前に、同じフォルダでcron-task.txtをtask.txt、cron-tests.jsonをtests.jsonとして保存します。コーディングタスクの結果には、上限6,000トークンで実行したGLM 5.3 FlashとQwen 3.8 Flashの結果も含まれています。その大半は空の応答で、本文では取り上げていません。呼び出し単位ではなく利用上限に対する費用を測りたい場合は、Codexの週間上限とClaude Codeの使用量上限のガイドでサブスクリプション側を解説しています。
よくある質問
- トークン単価が最も安いモデルは、タスク単位でも最も安いのですか?
- そうとは限りません。難しい方のテストでは、DeepSeek V4.1 Flashの出力トークン単価はGPT-6 Solの約8分の1でしたが、正解1件あたりの費用はSolの$0.0040に対して$0.0059でした。出力トークンを約4,900使い、その97%が推論だったためです。
- 推論モデルの空の応答にも料金はかかりますか?
- かかります。APIが返したusageには出力トークン4,000がすべて計上され、ofoxの請求にもそのまま反映されました。たとえばDeepSeek V4.1 Flashの空の応答1件は$0.00480307でした。
- この結果から、CodexやChatGPTのサブスクリプション枠がどれだけ節約できるか分かりますか?
- 分かりません。今回測ったのはAPIのトークン費用です。サブスクリプションのプランは、利用量が枠にどう換算されるかを公開していません。