O LLM mais barato que acerta: custo por resultado correto
Sete modelos, as mesmas tarefas e 86 chamadas cobradas: quanto custa um resultado correto. Com respostas vazias cobradas e um script que testa antes de escalar.
 Ofox
Nas tarefas do dia a dia que testamos, o modelo mais barato acertou todas as respostas que o mais caro acertou, por 1/75 do valor cobrado nas notas de reunião e 1/45 na correção de bug. Em trabalhos mais difíceis, um preço baixo por token deixou de indicar um preço baixo por resultado: o DeepSeek V4.1 Flash e o Qwen 3.8 Flash às vezes gastaram todo o orçamento de saída pensando, não retornaram nada e foram cobrados por isso. Por isso, compare quanto custa um resultado correto e verifique o resultado antes de confiar nele.
Este artigo é a versão escrita do nosso vídeo explicativo, apresentado por Marie, uma apresentadora gerada por IA. A equipe da ofox planejou e executou todos os testes entre 20 e 21 de outubro de 2026, conferiu cada chamada com a fatura da ofox e publicou os scripts e os resultados brutos abaixo.
Assista no YouTube (vídeo em inglês, 5 min): How to Cut AI API Costs Without Losing Accuracy (7 Models Tested).
Para quem é: desenvolvedores e equipes pequenas que chamam APIs de LLM e querem gastar menos sem adivinhar. O artigo não mede a cota da assinatura nos apps do Codex, do ChatGPT ou do Claude, porque esses planos não publicam como o uso é convertido em cota.
Por que o preço por token é o número errado
Três fatores ficam entre a tabela de preços de um modelo e a sua fatura.
- A dificuldade da tarefa decide se um modelo barato basta. Se ele falhar, você paga de novo por um modelo mais forte.
- Modelos de raciocínio cobram o pensamento como saída. Os
reasoning_tokensdentro decompletion_tokenssão cobrados mesmo que você nunca os veja. - Falhas também são cobradas. Uma resposta vazia ou errada custa os mesmos tokens que uma boa.
Então o número comparável é o custo por resultado correto: o valor cobrado pelas execuções necessárias até obter uma resposta aprovada na sua verificação. Usamos a mesma ideia para vídeo no custo por clipe aproveitável (em inglês), e o nosso guia de roteamento entre Luna e Sol (em inglês) apresenta as regras de decisão com exemplos elaborados por nós. Este artigo acrescenta números medidos e cobrados.
Como testamos
| Item | Detalhe |
|---|---|
| Datas | Teste principal em 20 de outubro de 2026; demonstração de escalonamento e verificações de código em 21 de outubro de 2026 |
| Acesso | Endpoint da ofox compatível com OpenAI: https://api.ofox.io/v1/chat/completions |
| Modelos | anthropic/claude-opus-5.5, anthropic/claude-sonnet-5.5, anthropic/claude-haiku-5.5, openai/gpt-6-sol, openai/gpt-6-luna, deepseek/deepseek-v4.1-flash, qwen/qwen3.8-flash |
| Entradas | Escritas por nós: dois conjuntos de notas de reunião e uma função Python com bugs. Nenhum dado de cliente. |
| Avaliação | Automática. Notas: todo par esperado de responsável + prazo precisa aparecer, sem itens extras (a redação da tarefa não é avaliada). Código: oito testes ocultos executados em um subprocesso. |
| Repetições | Cada configuração avaliada rodou duas ou três vezes. É um teste pequeno, não um benchmark. |
| Custo | O valor que a ofox efetivamente cobrou por chamada, associado a cada uma das 86 chamadas concluídas pelo modelo, pela contagem de tokens e pelo horário. |
As 86 chamadas concluídas são as 83 do teste principal mais três execuções extras do GPT-6 Sol com esforço de raciocínio baixo, que acertaram os sete itens das notas difíceis em todas as vezes, a $0.003582 por execução. As 83 incluem 17 chamadas não avaliadas do GPT-6 Luna, de um experimento com conversa longa que deixamos fora deste artigo porque as duas variantes não eram tarefas equivalentes, e 6 chamadas do GPT-6 Sol comparando esforço de raciocínio baixo e alto na correção de bug (as duas configurações passaram; o esforço alto custou cerca de 18% a mais). Dois registros de teste atingiram limites de taxa (HTTP 429). Os modelos Claude estavam acessíveis pelo endpoint compatível com OpenAI em 20 de outubro. Desde 21 de outubro, a ofox passou a oferecê-los pelo endpoint compatível com Anthropic (/anthropic/v1), e não mais pelo compatível com OpenAI.
Resultado 1: tarefas do dia a dia
De notas de reunião para itens de ação. As notas contêm oito itens de ação com data e cinco armadilhas: ideias sem responsável, uma decisão sem data, um aviso de manutenção. Todos os modelos encontraram os oito pares de responsável + prazo, sem nada extra, nas duas execuções.
| Modelo | Execuções com acerto total | Cobrado por execução (média) | Tokens de saída (média) |
|---|---|---|---|
| Claude Opus 5.5 | 2/2 | $0.019712 | 657 |
| Claude Sonnet 5.5 | 2/2 | $0.011491 | 820 |
| GPT-6 Sol | 2/2 | $0.004806 | 337 |
| DeepSeek V4.1 Flash | 2/2 | $0.002470 | 1.908 |
| Qwen 3.8 Flash | 2/2 | $0.001405 | 1.852 |
| Claude Haiku 5.5 | 2/2 | $0.000607 | 885 |
| GPT-6 Luna | 2/2 | $0.000262 | 381 |
O Opus custou 75,2 vezes o valor do Luna pelo mesmo resultado correto. O preço também não indicou velocidade: o Luna respondeu em cerca de 5 segundos, enquanto o DeepSeek V4.1 Flash levou 264,5 segundos em uma execução e 13,2 na outra.
Corrigir uma função com quatro bugs. A função mescla reservas de sala sobrepostas e precisa ordenar, mesclar intervalos adjacentes, manter o horário de término mais tardio e descartar reservas inválidas. Todos os modelos passaram nos oito testes ocultos nas duas execuções. O Opus custou em média $0.010086 por execução e o Luna $0.000225, uma diferença de 44,8 vezes.
Resultado 2: uma tarefa mais difícil e as primeiras falhas reais
Tarefas fáceis não diferenciam os modelos, então escrevemos notas em que as pessoas mudam de ideia no meio da reunião, datadas de terça-feira, 20 de outubro de 2026. Uma tarefa é transferida de Priya para Omar, um prazo passa do dia 27 para o dia 31, uma tarefa é cancelada e as datas são relativas: “amanhã”, “daqui a dois dias úteis”, “fim da semana que vem”. Há sete itens corretos. A saída foi limitada a 4.000 tokens.
| Modelo | Execuções com acerto total | Cobrado por execução (média) | O que deu errado |
|---|---|---|---|
| Claude Opus 5.5 | 3/3 | $0.019053 | Nada |
| Claude Sonnet 5.5 | 3/3 | $0.011207 | Nada |
| GPT-6 Sol | 3/3 | $0.003999 | Nada |
| GPT-6 Luna | 3/3 | $0.000276 | Nada |
| Claude Haiku 5.5 | 2/3 | $0.000675 | Uma execução omitiu o item do “fim da semana que vem” |
| Qwen 3.8 Flash | 1/2 | $0.002938 | Uma resposta vazia; a outra requisição atingiu o limite de requisições (rate limit) |
| DeepSeek V4.1 Flash | 1/3 | $0.004423 | Duas respostas vazias |
As falhas do DeepSeek e do Qwen não foram respostas erradas. Foram respostas vazias. Em cada uma, completion_tokens e reasoning_tokens foram ambos 4.000, exatamente o limite, e content era uma string vazia.
Respostas vazias são cobradas
Conferimos a fatura. A página Activity da ofox mostra a requisição das 3:07:37 PM de 20 de outubro: 4K tokens de saída, 4K deles de raciocínio, cobrados a $0.00480307.
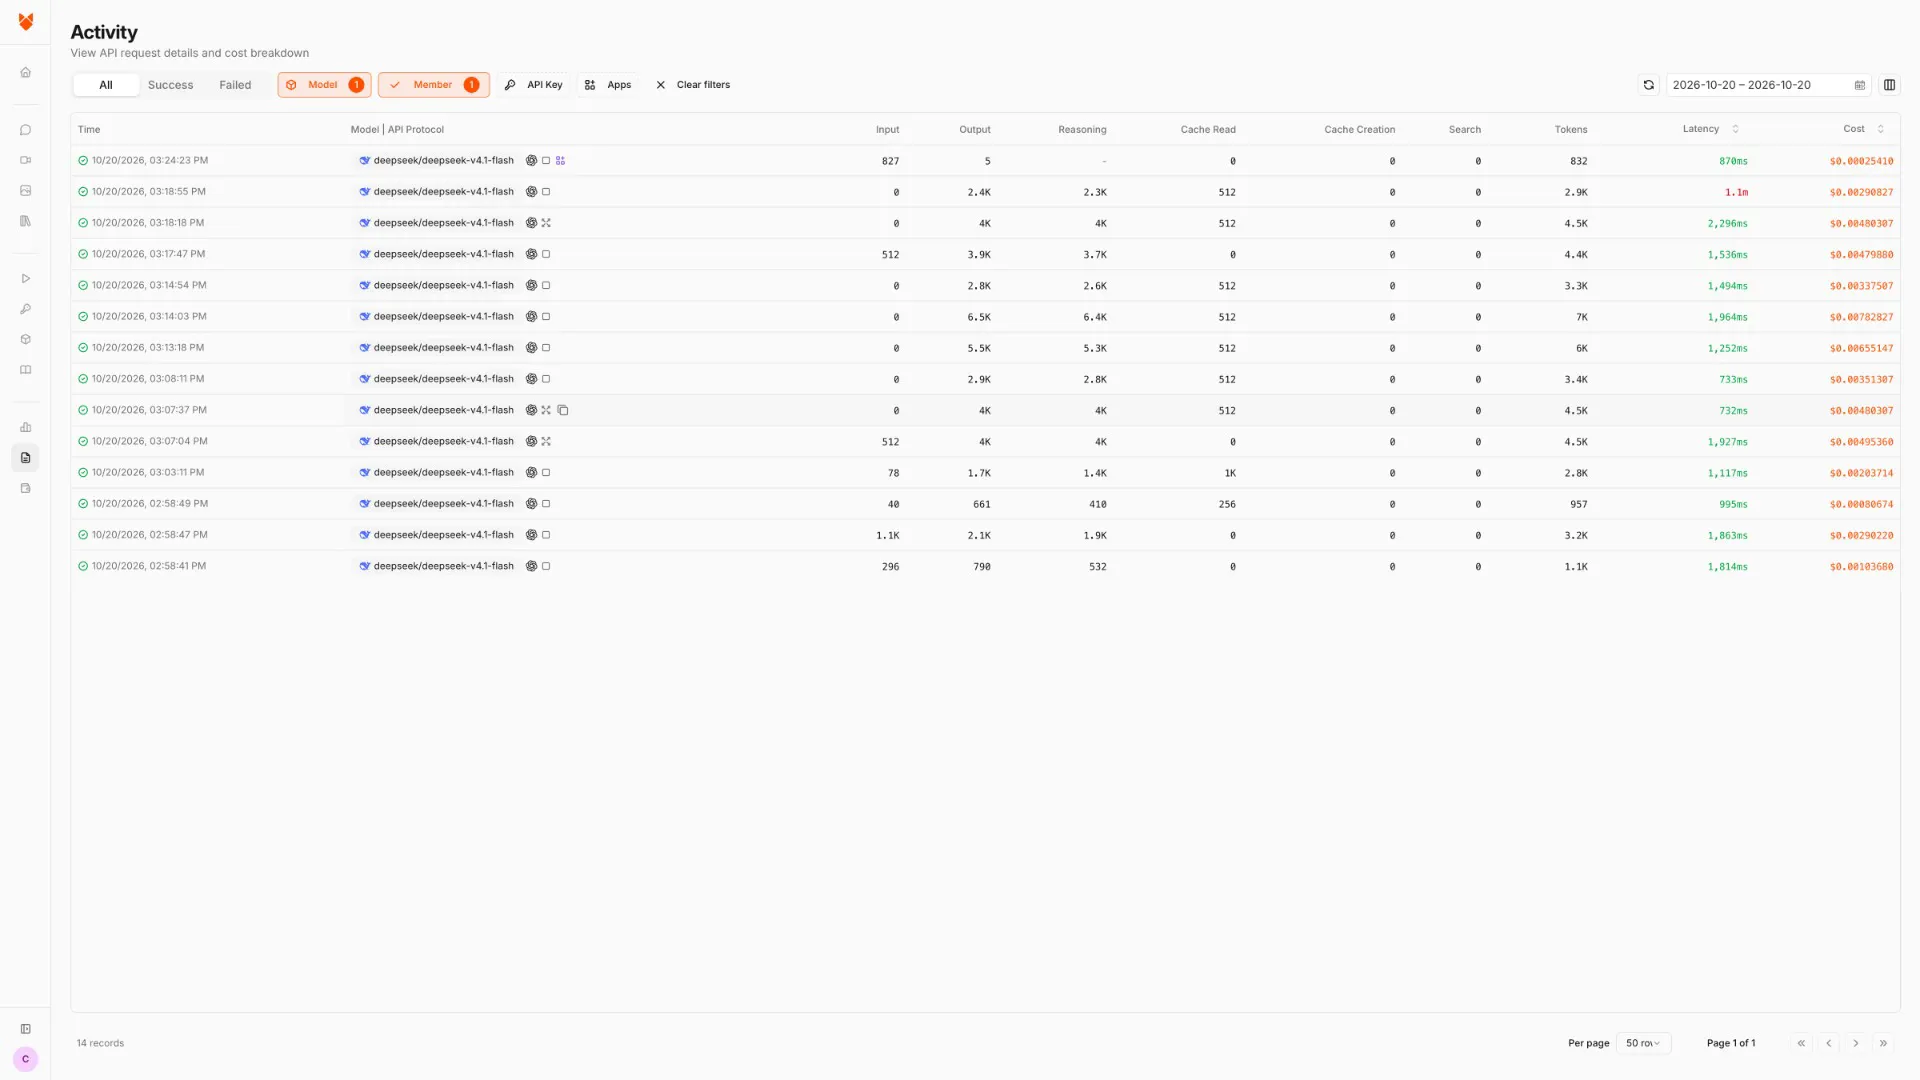
A captura de tela mostra o painel real, com a interface em inglês, filtrado antes da gravação para exibir só as nossas requisições de teste. Equipe, saldo e dados de outros membros não aparecem. As duas respostas vazias do DeepSeek neste teste foram cobradas a $0.004803072 e $0.0049536.
Como evitar a armadilha dos modelos de raciocínio
Executamos de novo o DeepSeek V4.1 Flash e o Qwen 3.8 Flash nas mesmas notas difíceis, com um limite de saída maior ou com esforço de raciocínio menor. Três execuções em cada caso.
| Configuração | Execuções com acerto total | Cobrado por execução (média) | Tokens de saída (média) | Tempo de resposta (mediana) |
|---|---|---|---|---|
| DeepSeek V4.1 Flash, limite 16.000 | 3/3 | $0.005918 | 4.929 | 45,2 s |
DeepSeek V4.1 Flash, reasoning_effort: "low" | 2/3 | $0.004170 | 3.431 | 37,2 s |
| Qwen 3.8 Flash, limite 16.000 | 3/3 | $0.002560 | 3.348 | 41,4 s |
Qwen 3.8 Flash, reasoning_effort: "low" | 3/3 | $0.000682 | 910 | 17,5 s |
Com espaço para terminar, o DeepSeek acertou a tarefa todas as vezes, mas cada execução correta custou $0.0059. O GPT-6 Sol fez a mesma tarefa por $0.0040, com cerca de 305 tokens de saída. Na tabela de preços da ofox, o DeepSeek V4.1 Flash custa $0.30 de entrada e $1.20 de saída por milhão de tokens, contra $2.00 e $10.00 do GPT-6 Sol: cerca de 1/7 do preço de entrada e 1/8 do preço de saída. Mesmo assim, custou mais por resultado correto, porque cerca de 96,7% da sua saída foi pensamento.
Reduzir o esforço ajudou mais o Qwen aqui: as três execuções acertaram tudo, a $0.000682 cada e com mediana de 17,5 segundos. Isso não resolveu o DeepSeek, que ainda retornou uma resposta vazia com esforço baixo. Nesses testes de três execuções, aumentar o limite foi a configuração que fez o DeepSeek passar todas as vezes.
Daí saem duas regras práticas:
- Defina de propósito um limite de tokens de saída e um esforço de raciocínio, e trate um
contentvazio comfinish_reason: "length"como falha, não como resposta. - Compare o custo cobrado por resultado correto, nunca apenas o preço por milhão de tokens. Nossa calculadora de ponto de equilíbrio do roteamento (em inglês) mostra como novas tentativas e fallbacks mudam esse número.
Verifique e só então suba de nível
O conselho comum é começar com um modelo barato e trocar por um melhor quando ele falhar. Na prática, “quando ele falhar” exige uma verificação que você consiga executar. Para código, essa verificação são testes. O script abaixo executa os modelos do mais barato para o mais caro, roda os testes em cada resposta e só sobe de nível quando eles falham.
Para mostrar a rede de segurança funcionando, precisávamos de um modelo barato que falhasse. O GPT-6 Luna nunca falhou: passou em todas as 7 execuções avaliadas no teste principal e em 15 de 15 em cinco tarefas de código que escrevemos para isso (dias úteis, interpretação de durações, divisão de contas, agendamentos cron e horário de verão). O GPT-6 Sol com esforço baixo errou três casos em uma das suas 18 execuções de código (interpretação de durações, 16 de 19). Por isso, a demonstração começa no DeepSeek V4.1 Flash, que retornou respostas vazias em uma dessas tarefas, uma função cron de “próximo horário de execução” com doze testes, em todas as suas três execuções com limite de 4.000 tokens.
import json, os, re
from openai import OpenAI

client = OpenAI(base_url="https://api.ofox.io/v1",
                api_key=os.environ["OFOX_API_KEY"])

# Cheapest first. $ per 1M tokens (in, out), ofox, Oct 2026
TIERS = [
    ("deepseek/deepseek-v4.1-flash", 0.30, 1.20, {}),
    ("openai/gpt-6-sol", 2.00, 10.00,
     {"reasoning_effort": "low"}),
]

def passes(reply):
    m = re.search(r"```(?:python)?\n(.*?)```", reply, re.S)
    if not m:
        return 0
    ns = {}
    exec(m.group(1), ns)
    tests = json.load(open("tests.json"))
    return sum(ns["next_run"](*a) == want for a, want in tests)

task, total = open("task.txt").read(), 0.0
for model, p_in, p_out, extra in TIERS:
    r = client.chat.completions.create(
        model=model, max_tokens=4000,
        messages=[{"role": "user", "content": task}], **extra)
    u = r.usage
    cost = (u.prompt_tokens * p_in + u.completion_tokens * p_out) / 1e6
    total += cost
    ok = passes(r.choices[0].message.content or "")
    print(f"{model}\n  {u.completion_tokens} out tokens  ${cost:.4f}  tests {ok}/12")
    if ok == 12:
        print(f"PASS  total ${total:.4f}")
        break
    print("  check failed -> moving up")
A execução real em 21 de outubro de 2026:
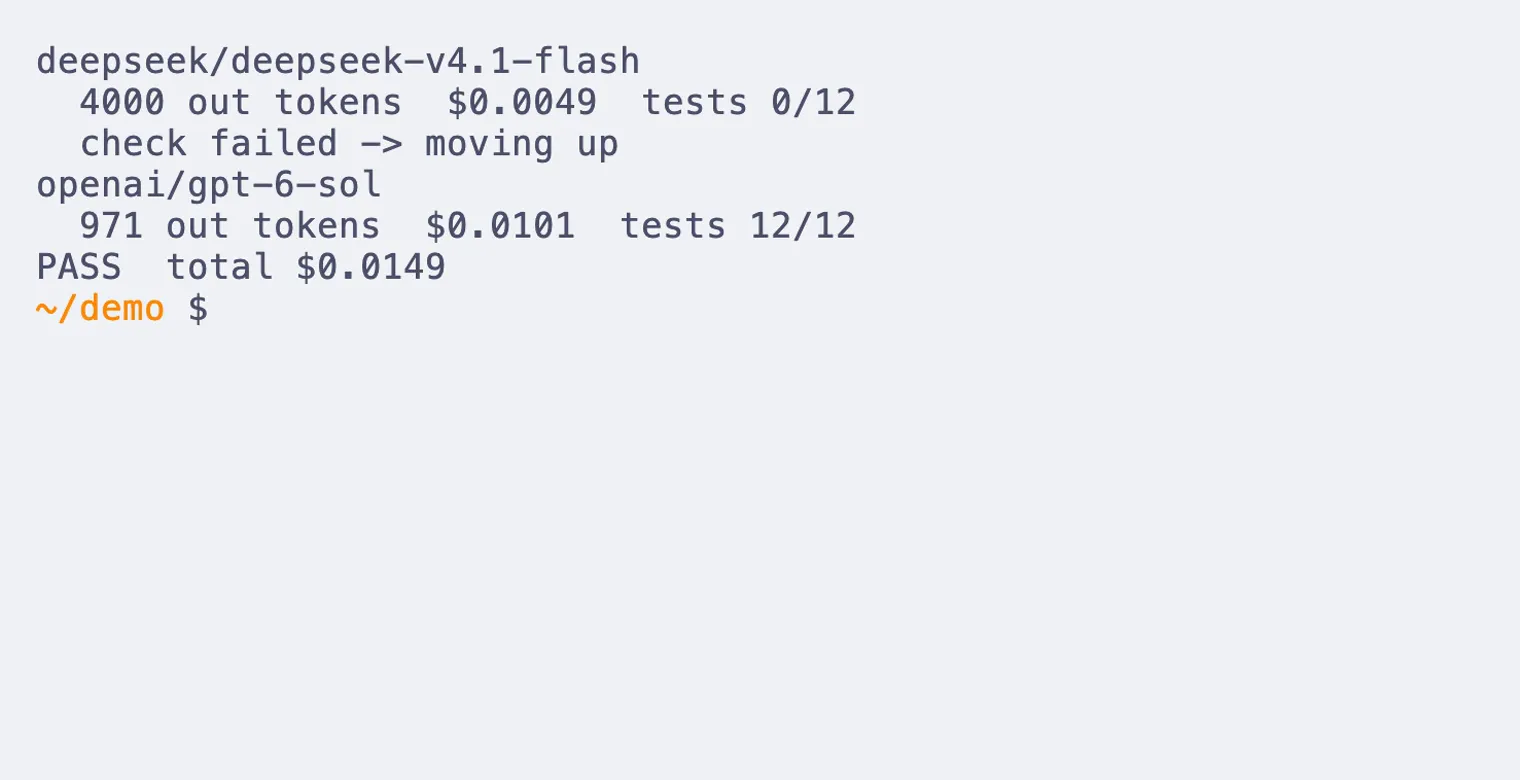
deepseek/deepseek-v4.1-flash
  4000 out tokens  $0.0049  tests 0/12
  check failed -> moving up
openai/gpt-6-sol
  971 out tokens  $0.0101  tests 12/12
PASS  total $0.0149
Os custos exibidos aqui são o uso de tokens retornado pela API multiplicado pelo preço de tabela da ofox. Repare no total. A tentativa fracassada do DeepSeek acrescentou cerca de meio centavo de dólar, então esta execução custou mais do que teria custado começar pelo Sol.
A verificação não existe para obrigar você a tentar o modelo barato toda vez. Ela indica por onde cada tipo de tarefa deve começar. O DeepSeek V4.1 Flash foi o primeiro nível errado para esta tarefa. O GPT-6 Luna, que é mais barato por token que os dois, passou na mesma tarefa cron em todas as suas três execuções (com limite de 6.000 tokens nessa verificação) e também acertou todos os itens das notas de reunião. Pelas nossas execuções, extrações como a tarefa das notas de reunião e essas cinco tarefas de código podem começar no Luna. Comece em um nível mais alto apenas nas tarefas em que a sua própria verificação mostrar o modelo barato falhando, e mantenha o caminho de escalonamento para esses casos.
Observe que exec executa código escrito pelo modelo dentro do seu processo. Isso é aceitável em uma demonstração com código que você vai revisar de qualquer forma. Para qualquer coisa automatizada, rode os testes em uma sandbox ou em um subprocesso, como faz o nosso executor de testes completo.
Como aplicar isso ao seu trabalho
No trabalho real você não tem um gabarito, então monte um pequeno.
- Escolha três tarefas que você executa todos os dias e guarde de cinco a dez entradas reais para cada uma.
- Escreva a verificação antes de escolher o modelo. Para código, alguns testes. Para extração, os campos esperados, mais a conferência de alguns itens com a fonte. Para resumos, uma lista curta de fatos que precisam aparecer.
- Execute o modelo plausível mais barato duas ou três vezes por entrada e registre a taxa de acerto, os tokens de saída e o custo cobrado. Confira a fatura, não a sua estimativa. Modelos com muito raciocínio podem custar bem mais do que o preço sugere.
- Defina o modelo inicial de cada tarefa como o mais barato que passa de forma confiável nas suas execuções. Use o escalonamento para as falhas, não como caminho padrão.
- Execute a verificação de novo quando preços ou versões de modelo mudarem.
| Sintoma | Causa provável | O que fazer |
|---|---|---|
content vazio e completion_tokens igual ao seu limite | O raciocínio consumiu todo o orçamento de saída | Aumente max_tokens, reduza reasoning_effort ou use um modelo sem raciocínio para esta tarefa |
| HTTP 429 | Limite de requisições (rate limit) | Espere e tente de novo. Vimos isso no Qwen 3.8 Flash. |
| O JSON ou o bloco de código falha no parse | O modelo acrescentou texto em volta da resposta | Peça o formato explicitamente e extraia o primeiro bloco delimitado ou array JSON |
| Uma execução leva minutos | Tempo de pensamento longo ou variável | Defina um timeout para a requisição. Evite modelos de raciocínio longo em tarefas sensíveis à latência. |
Modelo Claude rejeitado em /v1 com “does not support the ‘openai’ protocol” | Desde 21 de outubro de 2026, o catálogo da ofox lista o Claude apenas sob o protocolo Anthropic; vimos esse erro em testes em 21 e 22 de outubro | Use o SDK da Anthropic com a base URL https://api.ofox.io/anthropic. No nosso teste de 22 de outubro, IDs no formato claude-sonnet-5.5 e anthropic/claude-sonnet-5.5 foram aceitos em /anthropic/v1/messages. |
Limites deste teste
- As entradas são sintéticas e curtas. As notas de reunião têm cerca de mil tokens.
- Cada configuração rodou duas ou três vezes. Trate as taxas de acerto como o que aconteceu nessas execuções, não como taxas de sucesso estáveis.
- A avaliação das notas verifica os pares de responsável + prazo e os itens extras. Ela não avalia como cada tarefa foi redigida.
- Os valores são o que a ofox cobrou em 20 e 21 de outubro de 2026, exceto a demonstração de escalonamento, que usa o uso informado pela API multiplicado pelo preço de tabela. As respostas do Claude que recebemos pelo endpoint compatível com OpenAI não incluíam o detalhamento do cache de prompt.
- Preços e versões de modelo mudam. Consulte a lista de modelos da ofox atual antes de reutilizar estes números.
- Não testamos estratégias de cache de prompt, APIs de lote nem cache semântico. Nosso panorama de redução de custos (em inglês) trata desses temas.
- A ofox publicou este artigo e executou os testes na própria plataforma.
Downloads
Todos os arquivos estão em /blog/_assets/evidence/cost-per-correct-result-20261022/:
results-billed.csv: as 86 chamadas com tokens, pontuação e valor cobradorunner.py: o executor de testes e os avaliadoresescalate.py,cron-task.txt,cron-tests.json: a demonstração de escalonamentocoding-tasks/results.csv: as verificações das cinco tarefas de código- Entradas e gabaritos:
meeting_notes.md,meeting_notes_hard.md,ground_truth.json,ground_truth_hard.json,buggy_code.py,hidden_tests.py
Para executá-los, defina OFOX_API_KEY no seu ambiente. Antes de rodar escalate.py, salve cron-task.txt como task.txt e cron-tests.json como tests.json na mesma pasta. Os resultados das tarefas de código também incluem execuções do GLM 5.3 Flash e do Qwen 3.8 Flash com limite de 6.000 tokens; a maioria delas retornou respostas vazias e não é discutida acima. Se você quiser medir o custo em relação aos limites de uso, e não por chamada, nossos guias sobre os limites semanais do Codex (em inglês) e os limites de uso do Claude Code (em inglês) tratam do lado da assinatura.
Perguntas frequentes
- O modelo mais barato por token é o mais barato por tarefa?
- Nem sempre. No nosso teste mais difícil, o DeepSeek V4.1 Flash custava cerca de um oitavo do GPT-6 Sol por token de saída, mas uma execução correta custou $0.0059, contra $0.0040 do Sol, porque usou cerca de 4.900 tokens de saída, 97% deles de raciocínio.
- As respostas vazias de modelos de raciocínio são cobradas?
- Sim. O campo
usageretornado pela API contou todos os 4.000 tokens de saída, e a fatura da ofox os cobrou; por exemplo, $0.00480307 por uma resposta vazia do DeepSeek V4.1 Flash. - Isso mostra quanto da cota da assinatura do Codex ou do ChatGPT vou economizar?
- Não. Medimos o custo de tokens da API. Os planos de assinatura não publicam como o uso é convertido em cota.