Gemini 4 Hydrogen 算便宜模型吗?和 Claude Haiku 5.5、GPT-6 Luna 比一比
Hydrogen 的每 token 标价是 Haiku 5.5 和 Luna 的 15 倍。本文对照官方价格、Artificial Analysis 单任务成本和 24 次调用的分类实测,说明这笔额外开销什么时候值得。
 Ofox
不算。Gemini 4 Hydrogen 是 Google 中等价位的通用模型,不属于它的低价档。按 Google 付费 Standard 价格,Hydrogen 每百万输入 token 收 1.50 美元,每百万输出 token 收 7.50 美元,是 Claude Haiku 5.5 和 GPT-6 Luna 短提示价格(两者都是 0.10 美元和 0.50 美元)的 15 倍。 按完成一个任务来算,差距可能更大:Hydrogen 默认以 high 级别思考,同样的活会花掉更多输出 token。Google 自己的指南也把高吞吐量的分类和路由任务指向 Gemini 3.5 Flash-Lite,而不是 Hydrogen。
但这不等于 Hydrogen 不值得买。在 Artificial Analysis 的 Intelligence Index 上,它在默认设置下的得分大约是 Haiku 5.5 和 Luna 的两倍。只是在简单、规则写得很清楚的分类任务上,这份额外能力没有带来任何差别:我们的测试里,Haiku 和 Luna 一样准确,花费却少得多。
本文由 Ofox 发布。2026 年 11 月 19 日核实时,文中四个模型都可以通过 Ofox 调用。下文每条信息都标明属于三类之一:官方文档(2026 年 11 月 19 日核实)、Artificial Analysis 数据(2026 年 11 月 19 日获取),或同一天通过 Ofox 跑的小规模自测。测试中的美元金额是我们按各厂商官方标价算出来的,不是 Ofox 账单。Ofox 自己的价格见文末链接的各模型页面。
同一口径下的官方标价
以下价格单位均为美元/百万 token,付费 Standard 档,厂商自家 API。四个模型的输出价格都包含思考或推理 token。
| 模型(API ID) | 输入 | 输出 | 缓存输入 | 计价条件 | Batch 输入/输出 |
|---|---|---|---|---|---|
Gemini 4 Hydrogen(gemini-4-hydrogen) | $1.50 | $7.50 | $0.075(仅隐式缓存) | 任何提示长度同一价格 | $0.75 / $3.75 |
Claude Haiku 5.5(claude-haiku-5-5) | $0.10 | $0.50 | 读取 $0.01;5 分钟写入 $0.125 | 提示 ≤100,000 token | $0.05 / $0.25 |
| Claude Haiku 5.5,提示 >100K | $0.50 | $2.50 | 读取 $0.05;5 分钟写入 $0.625 | 适用于整个请求 | $0.25 / $1.25 |
GPT-6 Luna(gpt-6-luna) | $0.10 | $0.50 | $0.01 | 输入 ≤272K token | $0.05 / $0.25 |
| GPT-6 Luna,输入 >272K | $0.20 | $0.75 | $0.02 | 适用于整个请求 | $0.10 / $0.375 |
Gemini 3.5 Flash-Lite(gemini-3.5-flash-lite) | $0.30 | $2.50 | $0.03 + 每小时每百万 token 存储费 $1.00 | 统一价格 | $0.15 / $1.25 |
来源:Google Gemini API 价格(英文)、Anthropic 价格(英文)、OpenAI 价格(英文)以及 GPT-6 Luna 模型页(英文)。
比起 15 倍这个表面比例,下面三个细节对比较结果的影响更大。
Haiku 5.5 的低价有上限。 Anthropic 按提示长度给 Haiku 5.5 定价。提示超过 100,000 token 的请求按基础价格的五倍收费,而且整个请求都按这个价格算,输出也包括在内。缓存读取和缓存写入都计入这 100K。过了这条线,Hydrogen 只是 Haiku 价格的三倍,而不是十五倍。我们的 Haiku 5.5 100K 计价指南用具体数字讲解了这条分界线。Luna 在 272K 输入 token 处也有类似的台阶。Hydrogen 的价格表没有列出长上下文档。
Hydrogen 有免费层。 Anthropic 和 OpenAI 的价格页只列出 Haiku 5.5 和 Luna 的付费价格。Google 则在免费层中把 Hydrogen 和 3.5 Flash-Lite 都标为免费,做原型时很方便。Google 的表格同时注明,Google 会用免费层的内容改进自家产品,而且能否使用取决于项目资格和限额。我们的 Hydrogen 接入指南介绍了验证和配额。
Flash-Lite 比 Hydrogen 便宜,但不比 Haiku 或 Luna 便宜。 它的输入价格是这两者的三倍,输出价格是五倍。在 Google 自家的产品线里,它是低成本选项;和其他厂商相比,它并不是最便宜的。
一个任务实际要花多少:Artificial Analysis 数据
每 token 价格没有反映每个模型会用掉多少 token。Artificial Analysis(AA,英文)会在每个模型上运行它的 Intelligence Index 评测,并公布加权平均的单任务成本。这个成本根据每个模型实际消耗的 token 和该模型的价格算出。我们在 2026 年 11 月 19 日获取了这四个模型的页面。第一张表采用各厂商文档写明的默认设置:Hydrogen 用 high 思考(Google 的 Hydrogen 指南,英文),Haiku 5.5 用 medium 强度(Anthropic 模型概览,英文),Luna 用 medium(OpenAI 模型页)。
AA 渲染出来的页面只显示每个模型最高设置下的单任务成本。其他设置的单任务成本来自同一页面背后的数据,每个成本都带有对应变体的标签(例如 claude-haiku-5-5-medium 或 gemini-4-hydrogen-high),所以下面的强度标签是 AA 自己标的,不是我们匹配出来的。各标签对应的指数得分与渲染页面一致。
| 默认设置下的模型 | AA Intelligence Index | AA 每个 Index 任务成本 | AA 输出速度 |
|---|---|---|---|
| Gemini 4 Hydrogen(high) | 51 | $1.87 | 165 token/秒 |
| Claude Haiku 5.5(medium) | 25 | $0.092 | 222 token/秒 |
| GPT-6 Luna(medium) | 18 | $0.042 | 96 token/秒 |
| Gemini 3.5 Flash-Lite(只列出一个变体) | 12 | $0.69 | 318 token/秒 |
在默认设置下,按 AA 的单任务成本算,Hydrogen 约为 Haiku 的 20 倍、Luna 的 44 倍。这两个差距都比 15 倍的 token 价格比更大,因为 Hydrogen 在 high 级别下每个任务产出的 token 更多。能力差距的方向也一样:Hydrogen 的指数得分大约是 Haiku 的两倍,接近 Luna 的三倍。
如果把便宜模型的强度调高,情况就不一样了:
| 列出的最高设置 | AA Intelligence Index | AA 每个 Index 任务成本 |
|---|---|---|
| Gemini 4 Hydrogen(xhigh) | 54 | $3.16 |
| Claude Haiku 5.5(max) | 36 | $0.41 |
| GPT-6 Luna(max) | 28 | $0.15 |
在最高设置下,Hydrogen 与 Haiku 的差距缩小到约 7.7 倍,因为 Haiku 在 max 下会用掉多得多的 token。Hydrogen 仍约为 Luna 的 21 倍。不过,即使开到 max,两者都达不到 Hydrogen 在 medium 下的得分(AA 页面上为 41)。根据 AA 的页面数据,Hydrogen 在 medium 下每个任务花 0.80 美元,约为 Haiku max(0.41 美元)的两倍,得分高 5 分。如果你的工作负载接近 AA 那类高难度推理和智能体任务,用较低设置的 Hydrogen,可能比把小模型推到极限更划算。
看这些数字时要记住它们的局限:
- AA 的指数由一组高难度评测组成。25 分并不意味着 Haiku 在你的提取任务里会失败四分之三。下文的测试显示,在按规则执行的简单任务上,Haiku 和 Luna 完全准确。
- AA 的速度数据是它自己测的。AA 列出的 Hydrogen 在
high下的首个答案 token 时间为 19.4 秒,Haiku 在medium下为 9.1 秒,Luna 在medium下为 5.3 秒。这个时间包含思考时间。 - AA 给出的 Flash-Lite 单任务成本(0.69 美元)不适合当作“每个请求”的成本。按 AA 自己的拆分,这个数字大部分是与缓存相关的输入成本,而不是输出。对于一次性的短请求,Flash-Lite 在我们这里的花费比 Hydrogen 低,下面的测试可以看到。
我们的测试:20 条分类条目加 3 道短推理题
我们想看看,这些数字放到人们买低价模型真正要做的活里意味着什么:条目多而短,规则表固定,用 JSON 作答。2026 年 11 月 19 日,我们通过 Ofox 的 OpenAI 兼容端点(https://api.ofox.io/v1/chat/completions)用相同的提示调用了这四个模型 ID:google/gemini-4-hydrogen、anthropic/claude-haiku-5.5、openai/gpt-6-luna 和 google/gemini-3.5-flash-lite。
设置。 使用模型默认设置:不设 temperature,不设思考或推理参数。唯一设置的参数是 max_tokens: 32000,用来封顶花费;没有任何响应触到这个上限(所有 finish_reason 都是 stop)。
工作负载 A:分类。 一个请求里包含 20 条客服消息。模型要为每条消息返回 category(五个类别)、order_id(第一个有效的 ORD- 加六位数字,转成大写,没有则为 null)和 refund(只有明确要求退钱时才为 true)。答案表在调用任何模型之前就已写好。有几条故意设了坑:一个必须拒绝的五位数订单号、作为干扰项的电话号码和工单号、一句明确的“不要求退款”、一条西班牙语消息、反讽、一个错误页面(出现在账单页面上,实际是 bug),以及包含两个问题、要以第一个问题为准的消息。每个模型把这个请求跑了两次。
工作负载 B:推理。 三个独立提示,每个都有唯一可核对的答案:一道重试成本计算(答案:$3.8064)、两个按工作时间计算的 SLA 截止时间(周一 13:00;周二 17:00),以及三个需要计算天数的退款政策判断(是、否、是)。每道题跑一次。
完整的提示、规则表、答案表、运行脚本和评分脚本,见下文复现部分的链接。
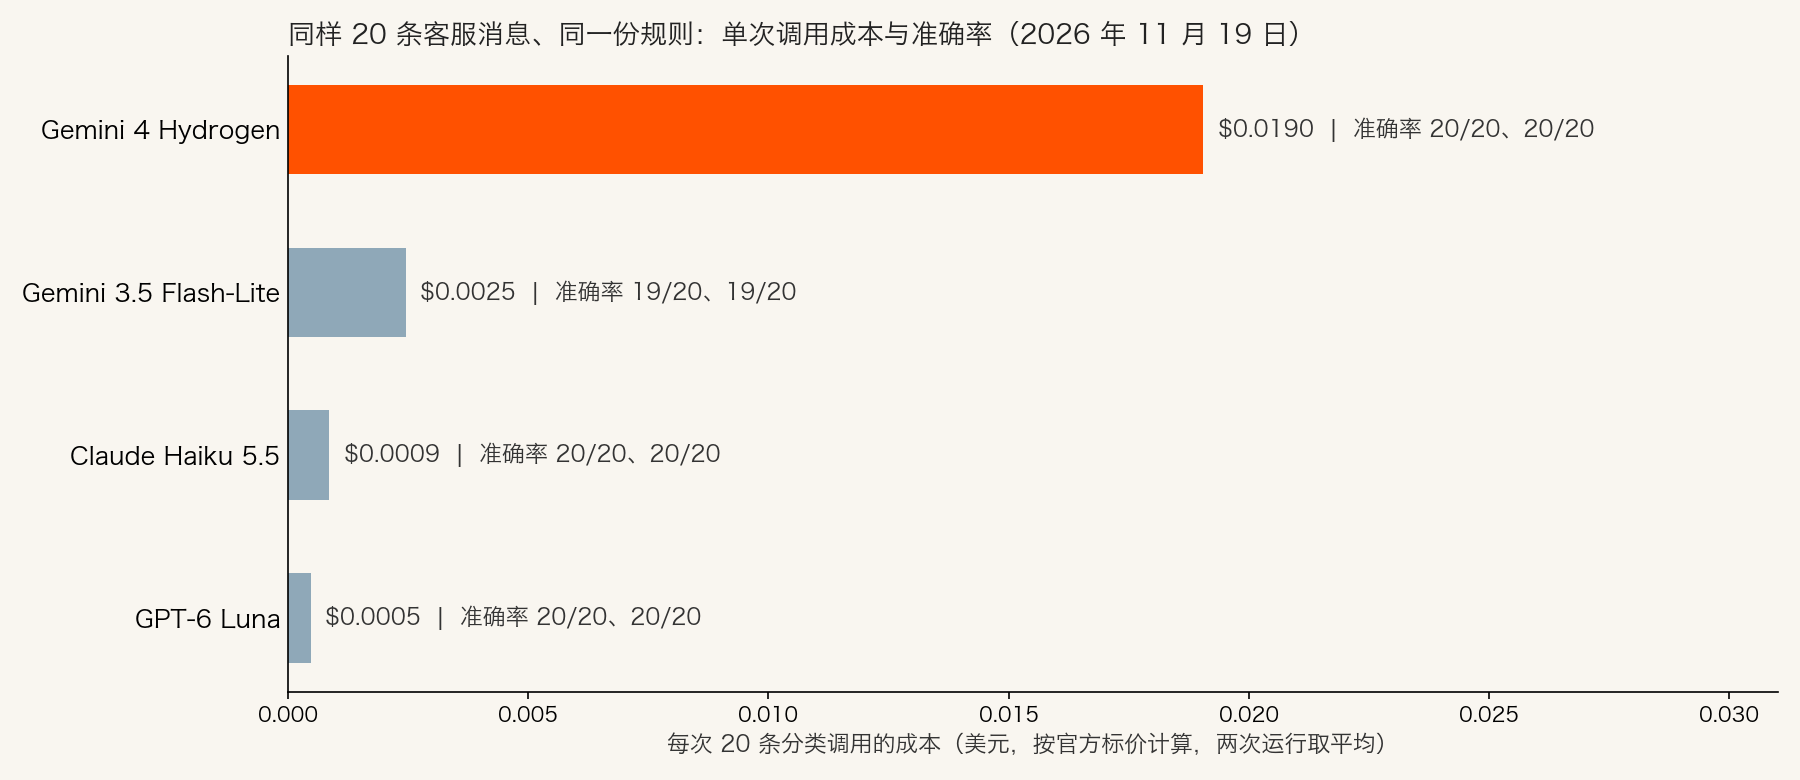
图表数据来自我们 2026 年 11 月 19 日的运行:每个模型两次分类调用的平均值,按厂商官方标价计算。不是 Ofox 账单。
准确率和成本结果
| 模型 | 分类准确率(2 次) | 推理题 | 分类平均延迟 | 每次分类调用的平均输出 token(其中思考) | 每次分类调用成本 | 同一价格折算到每 1,000 条消息 |
|---|---|---|---|---|---|---|
| Gemini 4 Hydrogen | 20/20,20/20 | 3/3 | 16.1 秒 | 2,336(≈1,698) | $0.0190 | ≈$0.95 |
| Claude Haiku 5.5 | 20/20,20/20 | 3/3 | 7.8 秒 | 1,476(≈831) | $0.00086 | ≈$0.043 |
| GPT-6 Luna | 20/20,20/20 | 3/3 | 8.3 秒 | 780(≈239) | $0.00048 | ≈$0.024 |
| Gemini 3.5 Flash-Lite | 19/20,19/20(每次 59/60 个字段) | 2/3 | 3.6 秒 | 861(未报告思考) | $0.00245 | ≈$0.12 |
成本按官方标价计算:用每个响应报告的输入和输出 token,乘以第一张表里厂商自家的 Standard 价格。所有提示都远低于 100K token,所以 Haiku 和 Luna 在这里按低档价格计。延迟是从我们的客户端经 Ofox 到收到完整的非流式响应所用的实际时间,包含网络时间,不是首 token 时间。“每 1,000 条消息”一列只是把测得的单批成本乘以 50,前提是提示结构相同、没有重试。
把每个模型的五次调用加起来,总额是:Hydrogen $0.0578,Haiku $0.0024,Luna $0.0012,Flash-Lite $0.0071。在这个工作负载上,Hydrogen 的花费约为 Haiku 的 24 倍、Luna 的 46 倍。它 15 倍的 token 价格溢价之所以被放大,是因为它为同样的答案生成了更多输出 token,其中大部分是思考。
测试结果说明了这几点:
- Hydrogen 的额外能力没有改变结果。 Hydrogen、Haiku 和 Luna 三者在两次分类中每个字段都答对,三道推理题也全对。在规则表清楚、任务定义明确的工作上,便宜的模型已经够用。
- Luna 的 token 效率最高。 它每次分类调用报告的推理 token 约 240 个,Hydrogen 约 1,700 个,Haiku 约 830 个。各厂商的分词器不同,token 数不能跨厂商完全对等比较,但成本差异正是由这些数量造成的。
- Flash-Lite 最快,但错了两处。 两次分类都把第 7 条返回成
ORD-77812,这个五位数编号按规则应当拒绝。在退款政策题上,它把 10 月 10 日到 11 月 15 日算成 21 天,而不是 36 天,并批准了一笔按 30 天规则本应拒绝的退款。Flash-Lite 没有报告推理 token。Ofox 的 Gemini 思考指南提到,Flash-Lite 系列默认不思考。 - Haiku 有一次调用很慢。 重试成本那道题用了 18.8 秒;另外两次推理调用各约 4 秒。只跑一次,无法判断这是不是常态。
调低思考级别能让 Hydrogen 便宜下来吗?
Google 表示 low 的 token 用量和延迟最低,所以我们在 Hydrogen 上重跑了分类请求:在 OpenAI 兼容路由上请求 reasoning_effort: "low" 跑了两次,在 Ofox 的 Gemini 原生路由上请求 thinkingConfig.thinkingLevel: "low" 跑了两次。这两种都是在 Ofox 上设置该级别的文档写法。两条路由都接受了请求(HTTP 200),但响应都没有说明实际采用了哪个级别,所以这项设置的效果没有得到确认。
| Hydrogen 分类,每种各 2 次 | 准确率 | 思考 token | 每次调用标价成本 | 延迟 |
|---|---|---|---|---|
| 默认(不设参数) | 20/20,20/20 | 1,585 / 1,811 | $0.0182 / $0.0199 | 16.2 / 16.1 秒 |
请求了 reasoning_effort: "low" | 20/20,20/20 | 1,564 / 1,650 | $0.0180 / $0.0187 | 15.8 / 17.1 秒 |
请求了原生 thinkingLevel: "low" | 20/20,20/20 | 1,478 / 1,630 | $0.0174 / $0.0185 | 19.1 / 18.8 秒 |
在这个提示上,请求 low 几乎没有改变思考 token、成本或延迟。low 是我们请求的设置,效果未经确认。从响应里我们无法判断:是级别已经生效,只是模型认为这批 20 条值得这么多思考;还是这些路由上没有应用该设置。无论是哪种情况,都不要以为调低级别就能把 Hydrogen 的成本降到 Haiku 或 Luna 的水平。请用你自己的提示去测。关于各个级别的详细说明,见同系列文章 Gemini 4 思考级别。
这次测试的局限
这是示例,不是基准测试。总共 24 次调用,一种批次结构,一张规则表和三个推理提示,全部在同一天跑完。20 条全对说明这个任务在这些模型的能力范围内,并不能据此得出错误率。我们没有测试长文档、图片、音频、工具调用或多步骤智能体,而这些恰恰是 Hydrogen 较高的 AA 得分最可能发挥作用的地方。经 Ofox 路由的延迟可能与各厂商直连 API 不同。整个测试(含后续补跑)按官方标价计算约花费 $0.14。
Hydrogen 多出来的钱什么时候花得值
按任务来选,不要只看每 token 价格低不低。根据文档、AA 数据和我们的测试:
任务短、定义明确、结果可核对时,用 Haiku 5.5 或 Luna。 例如分类、路由、按 schema 提取字段、按给定规则做简单计算。两者在我们的测试集上都准确,每次调用的成本大约是 Hydrogen 的 1/20 到 1/40。Anthropic 说 Haiku 5.5 的设计用途是 “for high-volume, latency-sensitive tasks such as classification, extraction, and routing”(意思是:面向分类、提取和路由这类高吞吐、对延迟敏感的任务)。两者之间怎么选,请用你自己的样本来判断:在我们的测试里 Luna 用的 token 最少;Haiku 在默认设置(25 比 18)和最高强度(36 比 28)下的 AA 得分都更高。Luna 的提取用法见 用 Luna 结构化输出做数据提取;Haiku 的批量吞吐任务见 Haiku 5.5 与 4.5 批量任务对比。
任务需要小模型缺少的推理能力、工具或模态时,再为 Hydrogen 付钱:
- 较难的多步骤工作。 Hydrogen 在
medium下的 AA 得分(41)高于 Haiku 在max下的得分(36)。如果你已经把小模型开到最高强度,仍然过不了自己的检查,下一步可以试试较低设置的 Hydrogen。Google 对它的定位是 “everyday coding and agentic workflows”(意思是:日常编码和智能体工作流)。 - 音频和视频输入。 Google 的模型卡列出 Hydrogen 支持文本、图像、音频和视频输入。Anthropic 为其当前模型列出的是文本和图像输入;Luna 的模型页列出的是文本和图像模态。
- 长提示。 Hydrogen 的价格不随提示长度变化。请求一旦超过 100K 提示 token,Haiku 的价格就涨到五倍,与 Hydrogen 的差距缩小到 3 倍。超过 272K 后,Luna 的输入价格翻倍。如果你的大部分请求都很长,请按高档价格重新计算。
- 在 Google 上免费做原型。 Hydrogen 的免费层让你可以先搭起来再付费,但要遵守 Google 的数据使用条款和项目限额。见我们的 Gemini 4 免费 API 层指南。
需要 Google 最低的延迟,或者想用低价处理音频和视频输入,并且能校验输出时,用 Gemini 3.5 Flash-Lite。 Google 的 Hydrogen 指南本身就建议继续用 3.5 Flash-Lite 处理这类需求:“for high-volume classification, routing, and sub-second latency targets”(意思是:高吞吐的分类、路由和亚秒级延迟目标)。它是我们测试中最快的模型,但漏掉了一条严格的编号规则和一次日期计算,而且它的输出价格是 Haiku 或 Luna 的五倍。我们之前的 Luna 与 Gemini 3.5 Flash-Lite 提取对比深入讨论了输入格式上的差别。
一个实用的做法是按难度分流。先把每个条目都交给 Haiku 或 Luna,再对照 schema 和原文校验输出,只把失败的、置信度低的或长篇多模态的输入升级给 Hydrogen。我们的 按“正确结果成本”选模型指南讲了怎么给这种做法算账,Luna 到 Sol 的路由阈值给出了一条可直接参考的升级规则。如果你是在 Hydrogen 和更高一档之间做选择,请看同系列对比 Hydrogen、Claude Sonnet 5.5 与 GPT-6.1 Terra;想看完整阵容,请看 Gemini 4、Claude 与 GPT 各档模型对比。
用你自己的数据复现测试
我们的测试对四个模型都使用同一个 Ofox key 和 OpenAI 兼容的 Chat Completions 路由,所以模型之间唯一的区别就是 model 字符串。最小请求如下:
curl https://api.ofox.io/v1/chat/completions \
  -H "Authorization: Bearer $OFOX_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "anthropic/claude-haiku-5.5",
    "max_tokens": 32000,
    "messages": [
      {"role": "system", "content": "<your rule sheet>"},
      {"role": "user", "content": "<your batch of items>"}
    ]
  }'
把模型换成 google/gemini-4-hydrogen、openai/gpt-6-luna 或 google/gemini-3.5-flash-lite 即可。从每个响应中读取 usage.prompt_tokens、usage.completion_tokens 和 usage.completion_tokens_details.reasoning_tokens。在 Gemini 模型上,completion token 已经包含推理 token,不要重复相加。
我们的材料都可以下载,方便你重跑或改造:完整的测试集(含规则表、条目和答案表)、运行脚本、评分脚本,以及含每次调用用量的评分结果。Hydrogen 低思考级别的补跑使用了这个原生路由脚本,评分结果在 results_extra.json。这些脚本只用 Python 标准库,从 OFOX_API_KEY 读取 key。测试集和提示保持发送时的英文原文。概要如下:
- 规则表(系统提示,原文为英文):五个类别;订单号取第一个
ORD-后紧跟恰好六位数字的编号,转成大写,否则为 null;只有明确要求退钱时 refund 才为 true;配送问题即使要求退款也归为shipping;错误页面即使出现在账单页上也归为bug;有两个问题时以第一个为准。 - 分类条目和答案,例如:“Order ORD-77812 never arrived. I want my money back.” →
shipping、null、true;“The page shows ‘Error 502’ whenever I open billing settings.” →bug、null、false;“Tracking for ORD-55120 and ORD-551209 both show delivered, but only one box came.” →shipping、ORD-551209、false。 - 推理提示:12,000 个请求,每个 1,800 输入 token 和 250 输出 token,价格为每百万 0.10 美元和 0.50 美元,4% 的请求重试一次(答案 $3.8064);一张周五 15:00 提交、SLA 为 6 个工作小时的工单,和一张周一 22:30 提交、SLA 为 8 小时的工单,工作时间为周一至周五 09:00–17:00(周一 13:00;周二 17:00);2026 年 11 月 15 日提交的三笔退款申请,适用“未使用 30 天、损坏 90 天、数字商品从未下载”的政策(是、否、是)。
改造方法:
- 写 20 到 50 条和你真实流量相似的条目,把生产中会出问题的边界情况也放进去。先写好答案表,再运行任何东西。
- 每个候选模型先用默认设置跑,再调高或调低一档跑。按字段记录准确率,而不只是看“JSON 是否有效”。
- 根据每次调用报告的用量和官方价格计算成本,重试也要算进去。任务量大时,看看 Batch 处理是否适用;四个模型的 Batch 价格都是 Standard 的一半。
- 选出达到准确率要求的最便宜模型,把它做错的条目交给更强的模型。
Ofox 的结构化输出指南说明了如何请求受 schema 约束的 JSON。大批量运行前,请查看限流文档,并参照错误处理指南设计重试。如果测试中模型返回错误,我们的 Gemini 4 API 报错指南、Claude API 529/429 报错排查和 OpenAI model-not-found 排查(英文)按厂商整理了常见原因。
简短结论
Hydrogen 是一个能力不错、价格中等的通用模型。对于量大而简单的任务,它不是省钱的选择:在我们的分类测试集上,它的准确率与 Haiku 5.5 和 Luna 持平,花费却高出 24 到 46 倍。当任务难到小模型过不了你的检查、需要音频或视频输入,或者经常超过 Haiku 的 100K 或 Luna 的 272K 价格线时,它的溢价才说得通。Google 自家的低成本 Gemini 选项是 3.5 Flash-Lite。它是我们测试中最快的模型,但按每 token 价格算,它仍然比 Haiku 和 Luna 贵。
相关文档
常见问题
- 大批量任务会让 Claude Haiku 5.5 进入更高的价格档吗?
- 不会。Anthropic 按每个请求自己的提示长度计价。只有单个请求的提示(含缓存读取和缓存写入)超过 100,000 token 时才按高档价格收费,而且高档价格适用于这个请求的全部内容,输出也包括在内。
- Gemini 4 Hydrogen 可以关闭思考吗?
- Google 为 Hydrogen 公布了四个思考级别(low、medium、high 和 xhigh,默认是 high),但没有把其中任何一个说成关闭思考。我们的分类测试在两条路由上请求了 low;这个级别是否生效没有得到确认,而且在这个提示上,返回的思考 token 几乎没有变化。