Images API
Dos endpoints: generación (texto → imagen) y edición (imagen + texto → imagen). Ambas respuestas siguen la estructura estándar de OpenAI data[0].b64_json.
Seedream y Qwen-Image no admiten /v1/images/edits: la generación de imagen a imagen se hace en el endpoint generations, pero el campo de la imagen de referencia es distinto: Seedream usa image y Qwen usa input_images; no los confunda. Si necesita controlar la resolución de Gemini (de 512 a 4K), utilice el protocolo nativo de Gemini. Las diferencias de parámetros de cada familia se detallan en su página.
Inicio rápido
Una petición mínima ejecutable: genera una imagen de 1024×1024, la decodifica y la guarda como output.png.
https://api.ofox.io/v1https://api.ofox.io/v1/images/generationshttps://api.ofox.io/v1/images/editsopenai/gpt-image-2.5-flarePython
import base64
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_OFOX_API_KEY",
    base_url="https://api.ofox.io/v1",
    timeout=600,  # la API de imágenes es síncrona y puede tardar
)

resp = client.images.generate(
    model="openai/gpt-image-2.5-flare",
    prompt="Una manzana roja sobre una mesa blanca",
    size="1024x1024",
    quality="low",
)

with open("output.png", "wb") as f:
f.write(base64.b64decode(resp.data[0].b64_json))La API es síncrona: configure el tiempo de espera del cliente en 600 segundos. Las peticiones de alta calidad, de gran tamaño y de edición pueden tardar varios minutos; consulte la latencia medida.
Todas las familias se llaman de la misma forma; para cambiar de modelo solo cambia model. Los valores admitidos y los parámetros propios de cada familia varían; consulte cada parámetro a continuación.
Generar imágenes
POST https://api.ofox.io/v1/images/generationsParámetros de la petición
Los valores admitidos y los valores predeterminados siguientes corresponden a la familia GPT Image (gpt-image-2.5-flare, gpt-image-2.5-sunburst, gpt-image-2). Cuando otras familias difieren, se indica aparte. Detalles medidos: familia GPT Image.
ID del modelo; distingue mayúsculas y minúsculas: un ID incorrecto devuelve 404 model_not_found.
▸ Detalles
Los modelos compatibles figuran en la tabla al inicio de esta página. Se recomienda usar el ID completo con el prefijo del proveedor, por ejemplo openai/gpt-image-2.5-flare.
Describe la imagen que se va a generar.
Tamaño de salida. Se admiten anchos y altos personalizados, pero deben cumplir cuatro reglas; de lo contrario, se devuelve 400 Invalid size.
▸ Detalles
Las cuatro reglas:
- Ancho y alto divisibles por 16
- Lado mayor ≤ 3840
- Relación de aspecto entre 1:3 y 3:1
- Total de píxeles ≥ 655.360 (
768x768no es válido,1024x768sí)
Si se omite o es auto, el modelo decide; en nuestras mediciones devolvió 1254×1254. Indique el tamaño explícitamente si necesita uno fijo. Las demás familias tienen reglas de tamaño distintas; consulte la página de cada familia. Detalles: GPT Image · tamaño.
Nivel de calidad; determina directamente el precio. gpt-image-2 no admite xhigh / max.
▸ Detalles
gpt-image-2no admitexhigh/max: si se envían, devuelve 400.- No se aceptan los valores de la época de DALL·E
standard/hd: si se envían, devuelve 400. - Omitirlo no equivale a
medium: el modelo elige el nivel (en nuestras mediciones eligiólow). Para obtener una calidad y un coste estables, indíquelo explícitamente.
La mayoría de las demás familias no tienen niveles; consulte la página de cada familia. Detalles: GPT Image · calidad.
Número de imágenes; cada una se factura por separado. No es compatible con los modelos Gemini: no lo envíe.
Formato del archivo de salida.
▶Avanzados · 7output_compression · background · moderation · stream · partial_images · input_images · extra_body.provider.typeExpand
Nivel de compresión; solo se aplica a jpeg / webp.
Fondo. transparent requiere un formato con canal alfa (png / webp).
Nivel de rigor de la moderación de contenido.
Devuelve la respuesta en streaming. Junto con partial_images, permite recibir imágenes intermedias durante la generación.
Número de imágenes intermedias devueltas en streaming; requiere enviar también stream: true. Según la documentación oficial de OpenAI, cada imagen intermedia añade 100 tokens de salida.
Array de imágenes de referencia (URL o base64), solo para la familia Qwen, de 1 a 3 imágenes.
▸ Detalles
En las demás familias no da error, pero tampoco surte efecto; en Seedream, el campo de la imagen de referencia es image.
Selecciona un proveedor. Es opcional y normalmente innecesario: el gateway enruta automáticamente. Considérelo si tiene requisitos de moderación de contenido; una vez seleccionado un proveedor, si este no está disponible, la petición no se redirige automáticamente a otro.
▸ Detalles
La cabecera X-OfoxAI-Provider-Type es equivalente. Consulte Avanzado: fijar un proveedor.
Respuesta
{
  "created": 1777385517,
  "data": [
    { "b64_json": "iVBORw0KGgoAAAANSUhEUgAA…", "index": 0 }
  ],
  "model": "openai/gpt-image-2.5-flare",
  "size": "1024x1024",
  "quality": "low",
  "usage": {
    "input_tokens": 13,
    "input_tokens_details": { "text_tokens": 13 },
    "output_tokens": 196,
    "output_tokens_details": { "image_tokens": 196 },
    "total_tokens": 209
  }
}La imagen codificada en base64, sin el prefijo data:image/png;base64,.
▸ Detalles
Decodifíquela y escriba el archivo; para mostrarla en un navegador, añada usted el prefijo. La respuesta no incluye el campo url.
Índice de la imagen; distingue las imágenes cuando n > 1.
Tamaño real de salida. Si size se omitió o era auto, consulte aquí el tamaño real.
Nivel de calidad realmente utilizado. Si se omitió quality, aquí puede confirmar qué nivel se usó.
Fondo y formato realmente utilizados. No siempre se devuelven: no dependa de estos dos campos.
Consumo facturable. output_tokens son los tokens de la imagen de salida; input_tokens_details.text_tokens, los tokens del prompt.
▸ Detalles
Calcule el coste de cada llamada a partir de estas cifras.
Editar imágenes
POST https://api.ofox.io/v1/images/editsEste endpoint admite GPT Image, Nano Banana (Gemini) y MAI Image. Con Seedream y Qwen-Image devuelve 400 endpoint_not_supported; utilice en su lugar el campo de imagen de referencia del endpoint de generación; consulte Seedream y Qwen-Image.
Parámetros de la petición
multipart/form-data: se envían como campos de formulario y requieren subir un archivo de imagen. Los valores admitidos y los valores predeterminados también corresponden a la familia GPT Image.
ID del modelo; mismas reglas que en el endpoint de generación. Los modelos compatibles figuran en la tabla al inicio de esta página.
Imagen de referencia como archivo local (prefijo @ en cURL), no como URL.
▸ Detalles
Para enviar varias, repita el campo con el nombre image[]. ≤ 15 MB por imagen y ≤ 50 MB para el cuerpo de la petición; el gateway no limita la cantidad, pero se recomiendan 16 o menos.
Instrucción de edición.
Máscara de repintado parcial: un PNG con canal alfa, del mismo tamaño que image; zona transparente = la parte que se repinta.
▸ Detalles
Solo surte efecto en este endpoint: si se envía al endpoint de generación, se ignora en silencio. Cómo prepararla y el efecto medido: GPT Image · repintado parcial con máscara.
Tamaño de salida; mismas reglas que en el endpoint de generación.
▸ Detalles
Si se omite o es auto, el modelo decide: no se garantiza que coincida con la imagen original. Para conservar el tamaño original, indíquelo explícitamente.
Nivel de calidad; mismas reglas que en el endpoint de generación: gpt-image-2 no admite xhigh / max.
Número de imágenes; cada una se factura por separado.
▶Avanzados · 1X-OfoxAI-Provider-TypeExpand
Selecciona un proveedor. Es opcional y normalmente innecesario: el gateway enruta automáticamente. Considérelo si tiene requisitos de moderación de contenido; una vez seleccionado un proveedor, si este no está disponible, la petición no se redirige automáticamente a otro.
▸ Detalles
Este endpoint es una subida multipart, por lo que para fijar un proveedor solo funciona la cabecera: el campo de formulario extra_body se ignora en silencio. Consulte Avanzado: fijar un proveedor.
Respuesta
Misma estructura que en el endpoint de generación; usage añade los tokens de entrada de las imágenes de referencia:
{
  "created": 1777385669,
  "data": [
    { "b64_json": "iVBORw0KGgoAAAANSUhEUgAA…", "index": 0 }
  ],
  "model": "openai/gpt-image-2",
  "size": "auto",
  "quality": "low",
  "usage": {
    "input_tokens": 1041,
    "input_tokens_details": { "image_tokens": 1024, "text_tokens": 17 },
    "num_input_images": 1,
    "output_tokens": 358,
    "total_tokens": 1399
  }
}Tokens de entrada equivalentes a las imágenes de referencia. En nuestras mediciones, una imagen de referencia de 1024×1024 cuenta como 1.024. Es el principal motivo por el que una edición cuesta más que una generación de texto a imagen del mismo tamaño.
Número de imágenes de referencia. Permite confirmar que el modelo realmente las leyó.
Los demás campos son iguales que en la respuesta del endpoint de generación.
Consulte los modelos compatibles y los precios en el catálogo de modelos .
Llamada
Python
import base64
from openai import OpenAI

client = OpenAI(api_key="YOUR_OFOX_API_KEY", base_url="https://api.ofox.io/v1", timeout=600)

with open("apple.png", "rb") as f:
    resp = client.images.edit(
        model="openai/gpt-image-2",
        image=f,
        prompt="Cambia la manzana a color verde y deja todo lo demás igual",
        size="auto",
        quality="low",
    )

with open("apple_edited.png", "wb") as out:
out.write(base64.b64decode(resp.data[0].b64_json))El campo image recibe una ruta de archivo local (con el prefijo @ en cURL), no una URL.
Comparación medida:
| Original | Editada |
|---|---|
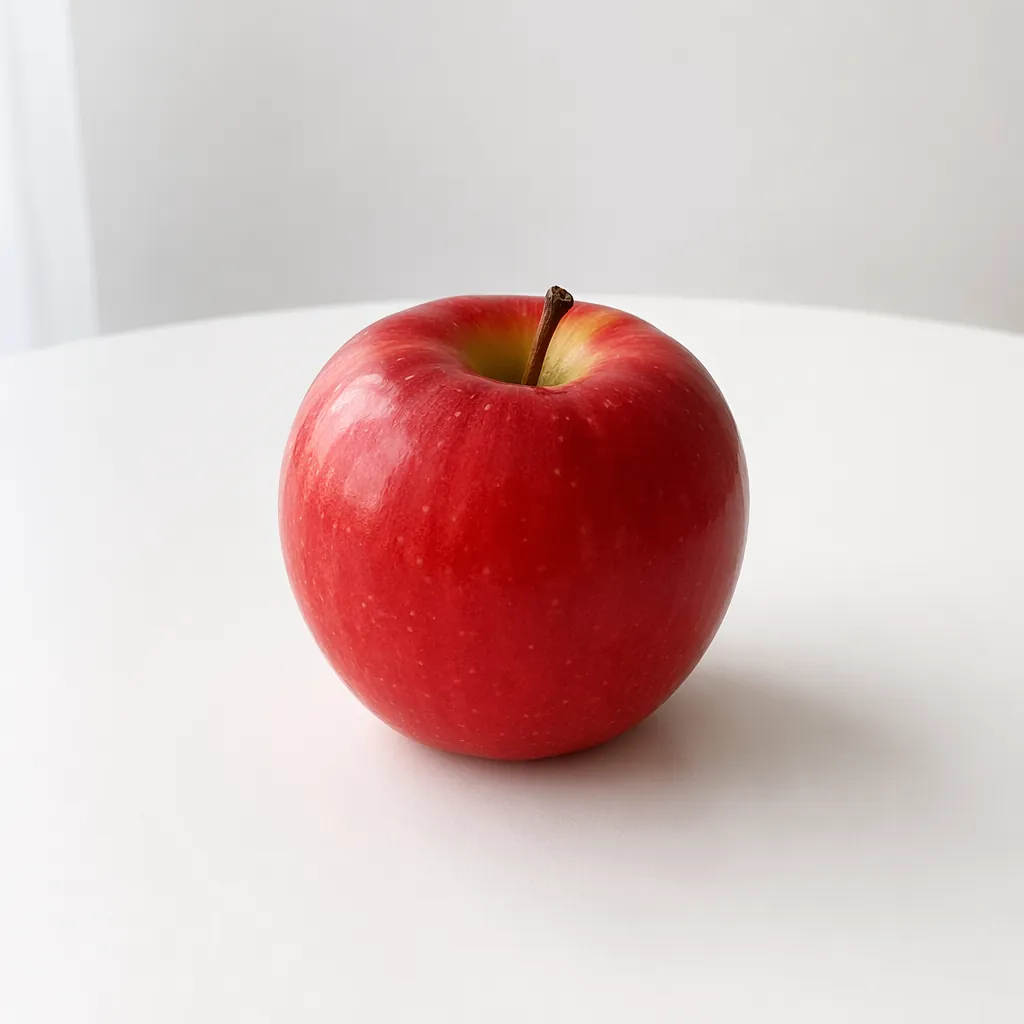 | 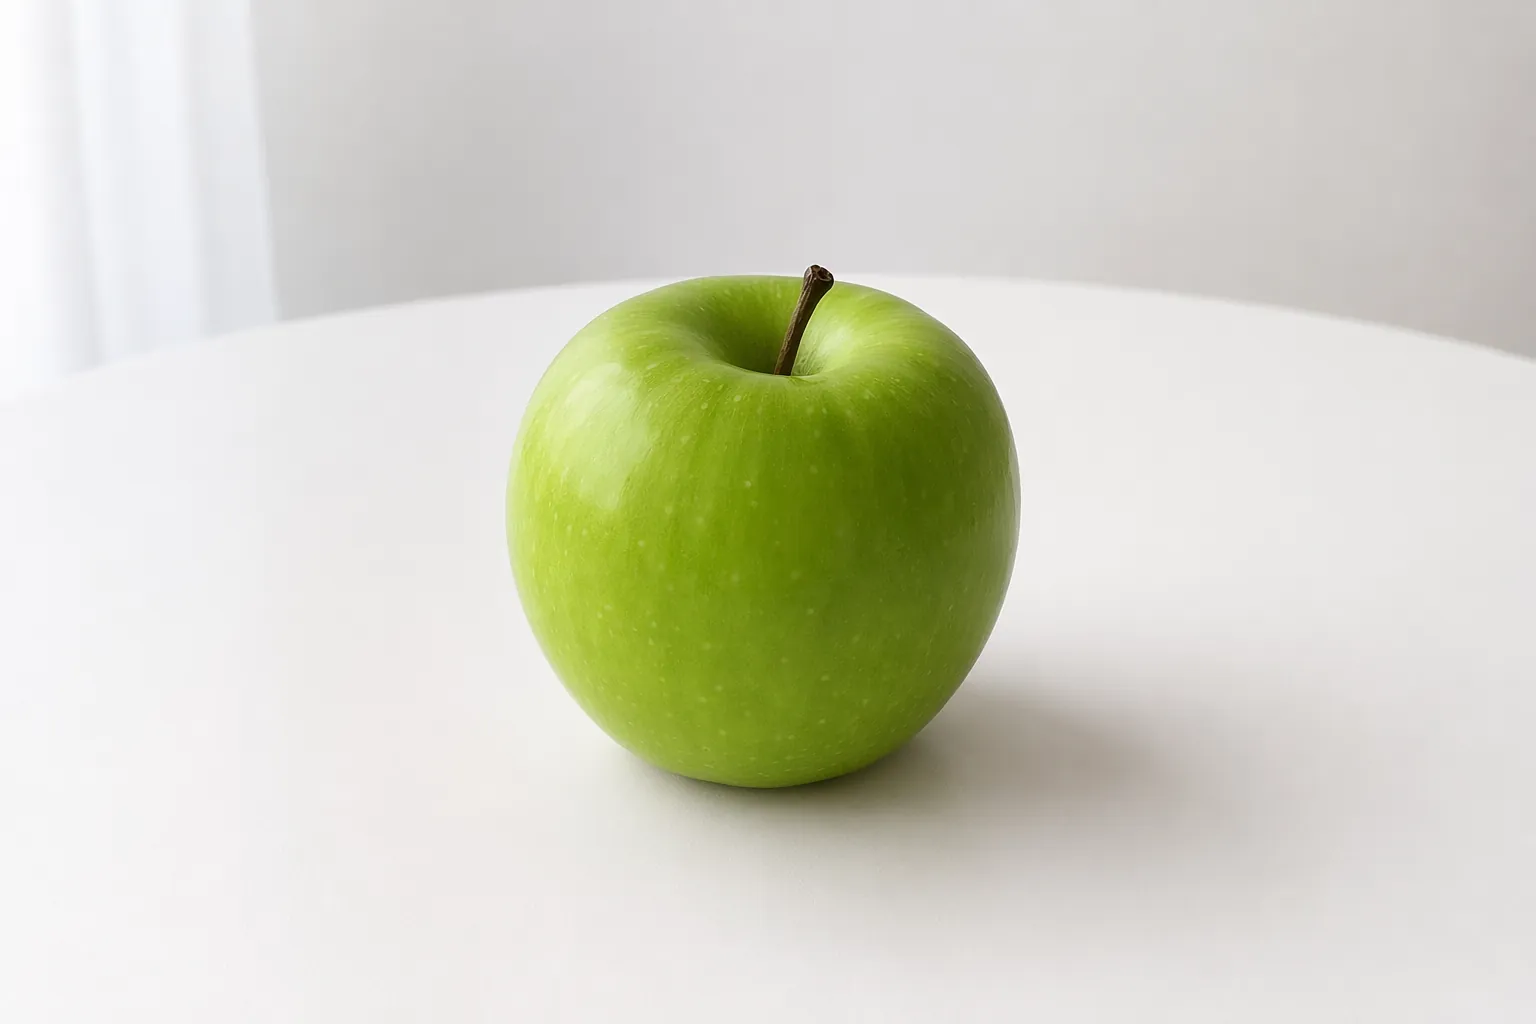 |
Errores
En caso de error se devuelve un código de estado HTTP de error y la siguiente estructura (medido):
{
  "error": {
    "code": null,
    "message": "The model 'gpt-image-2' does not support quality 'xhigh'.",
    "param": null,
    "request_id": "fbe4f24c-779d-41a0-8b3a-c62886cdd1ae",
    "type": "image_generation_user_error"
  }
}
code puede ser null. Base la lógica en el código de estado HTTP y en message.
Al contactar con soporte, incluya el request_id de la respuesta y los detalles del error (código de estado HTTP y error.message). Se recomienda registrarlos en sus logs.
Avanzado: fijar un proveedor
Es opcional y normalmente innecesario. Los tres modelos GPT Image (gpt-image-2.5-flare, gpt-image-2.5-sunburst, gpt-image-2) los sirven tanto azure_foundry como openai, y ambos admiten generación y edición. Si no se indica, el gateway enruta automáticamente.
Puede fijar un proveedor si tiene requisitos de moderación de contenido. Las peticiones irán entonces solo a ese proveedor; si no está disponible, no se redirigirán automáticamente a otro.
Indicar un proveedor que no sirve el modelo devuelve 400 provider_type_unavailable.
Los dos proveedores de openai/gpt-image-2 aplican criterios de moderación distintos. Si un prompt se rechaza repetidamente, puede indicar openai de forma explícita. Si no se indica, las peticiones se reparten de forma ponderada y pueden llegar a azure_foundry.
Texto a imagen /v1/images/generations
Cuerpo JSON: funcionan tanto el campo del cuerpo extra_body.provider.type como la cabecera X-OfoxAI-Provider-Type.
Python
resp = client.images.generate(
    model="openai/gpt-image-2",
    prompt="A simple red apple on a white table",
    size="1024x1024",
    extra_body={"extra_body": {"provider": {"type": "openai"}}},
)Con los SDK oficiales de OpenAI, extra_body debe estar presente como clave literal en el cuerpo de la petición. En el SDK de TypeScript basta con escribir extra_body directamente en el objeto de parámetros. El argumento extra_body= del SDK de Python fusiona su contenido en el nivel superior del cuerpo, por lo que hay que anidarlo un nivel más o usar la cabecera.
Imagen a imagen /v1/images/edits
Es una subida multipart y no hay cuerpo JSON donde anidar extra_body, por lo que solo se puede usar la cabecera.
curl https://api.ofox.io/v1/images/edits \
  -H "Authorization: Bearer $OFOX_API_KEY" \
  -H "X-OfoxAI-Provider-Type: openai" \
  -F "model=openai/gpt-image-2" \
  -F "prompt=..." \
  -F "image=@input.png"
Con los SDK: en Python, pase extra_headers={"X-OfoxAI-Provider-Type": "openai"}; en TypeScript, pase { headers: { 'X-OfoxAI-Provider-Type': 'openai' } } como segundo argumento.
En /v1/images/edits, un extra_body enviado como campo de formulario se ignora en silencio: la imagen se genera con normalidad, pero la restricción no se aplica. Utilice X-OfoxAI-Provider-Type en su lugar.
Referencia completa: API · Enrutamiento de proveedores.
Documentación oficial y más recursos
La documentación oficial describe el comportamiento al llamar directamente a OpenAI. Cuando difiere de lo medido en OfoxAI, prevalecen las mediciones de este sitio.
Documentación oficial de OpenAI
- Guía de generación de imágenes · Generar imágenes
- Guía de generación de imágenes · Editar imágenes
- Guía de generación de imágenes · Edición parcial con máscara
- Guía de generación de imágenes · Tamaño y calidad
- Guía de generación de imágenes · Cálculo de costes
- Referencia de la Images API
Páginas de familias de OfoxAI
- Descripción general de la familia GPT Image: elección de modelo, tamaño, calidad, tiempos y errores
- Texto a imagen
- Edición y múltiples imágenes
- Repintado parcial
- Familia Nano Banana (Gemini Image) y solución de errores
- Familia Seedream
- Familia Qwen-Image
- Familia MAI Image