Images API
Deux endpoints : génération (texte → image) et édition (image + texte → image). Les deux réponses suivent la structure standard OpenAI data[0].b64_json.
Seedream et Qwen-Image ne prennent pas en charge /v1/images/edits : l’image vers image passe par l’endpoint generations, mais le champ des images de référence diffère — Seedream utilise image, Qwen utilise input_images ; ne les inversez pas. Pour contrôler la résolution de Gemini (de 512 à 4K), passez par le protocole natif Gemini. Les différences de paramètres propres à chaque famille sont décrites sur sa page.
Démarrage rapide
Une requête minimale et exécutable : générer une image de 1024×1024, la décoder et l’enregistrer sous output.png.
https://api.ofox.io/v1https://api.ofox.io/v1/images/generationshttps://api.ofox.io/v1/images/editsopenai/gpt-image-2.5-flarePython
import base64
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_OFOX_API_KEY",
    base_url="https://api.ofox.io/v1",
    timeout=600,  # l'API d'images est synchrone et peut être lente
)

resp = client.images.generate(
    model="openai/gpt-image-2.5-flare",
    prompt="Une pomme rouge sur une table blanche",
    size="1024x1024",
    quality="low",
)

with open("output.png", "wb") as f:
f.write(base64.b64decode(resp.data[0].b64_json))L’API est synchrone : réglez le délai d’attente de votre client sur 600 secondes. Les requêtes en haute qualité, en grande taille et d’édition peuvent prendre plusieurs minutes ; voir la latence mesurée.
Toutes les familles s’appellent de la même façon : pour changer de modèle, seul model change. Les plages de valeurs et les paramètres propres diffèrent ; voir la description de chaque paramètre ci-dessous.
Générer des images
POST https://api.ofox.io/v1/images/generationsParamètres de la requête
Les valeurs possibles et par défaut ci-dessous s’appliquent à la famille GPT Image (gpt-image-2.5-flare, gpt-image-2.5-sunburst, gpt-image-2). Les différences des autres familles sont signalées au cas par cas. Détails mesurés : famille GPT Image.
ID du modèle, sensible à la casse ; une erreur renvoie 404 model_not_found.
▸ Détails
Les modèles pris en charge figurent dans le tableau en haut de cette page. Utilisez de préférence l’ID complet avec le préfixe du fournisseur, par exemple openai/gpt-image-2.5-flare.
Décrit l’image à générer.
Taille de sortie. Largeur et hauteur sont personnalisables, mais doivent respecter quatre règles, faute de quoi la requête renvoie 400 Invalid size.
▸ Détails
Les quatre règles :
- Largeur et hauteur divisibles par 16
- Côté le plus long ≤ 3840
- Rapport d’aspect compris entre 1:3 et 3:1
- Nombre total de pixels ≥ 655 360 (
768x768est refusé,1024x768est accepté)
Omis ou auto, c’est le modèle qui décide ; nous avons mesuré 1254×1254. Indiquez une taille explicitement si vous avez besoin d’une taille fixe. Les règles de taille des autres familles diffèrent ; voir la page de chaque famille. Détails : GPT Image · Taille.
Niveau de qualité, qui détermine directement le prix. gpt-image-2 n’a pas xhigh / max.
▸ Détails
gpt-image-2n’a pasxhigh/max; ces valeurs renvoient 400.- Les valeurs de l’ère DALL·E
standard/hdne sont pas acceptées ; elles renvoient 400. - L’omettre n’équivaut pas à
medium: le modèle choisit lui-même un niveau (nous avons mesurélow). Indiquez-le explicitement pour une qualité et un coût stables.
La plupart des autres familles n’ont pas de niveaux ; voir la page de chaque famille. Détails : GPT Image · Qualité.
Nombre d’images ; chacune est facturée séparément. Non pris en charge par les modèles Gemini : ne l’envoyez pas.
Format du fichier de sortie.
▶Avancés · 7output_compression · background · moderation · stream · partial_images · input_images · extra_body.provider.typeExpand
Taux de compression ; jpeg / webp uniquement.
Arrière-plan. transparent nécessite un format doté d’un canal alpha (png / webp).
Sévérité de la modération du contenu.
Active le streaming. Avec partial_images, vous recevez des images intermédiaires pendant la génération.
Nombre d’images intermédiaires diffusées ; nécessite aussi stream: true. Selon la documentation d’OpenAI, chaque image intermédiaire ajoute 100 tokens de sortie.
Tableau d’images de référence (URL ou base64), famille Qwen uniquement, de 1 à 3 images.
▸ Détails
Les autres familles l’acceptent sans erreur mais sans effet ; pour Seedream, le champ des images de référence est image.
Sélectionne un fournisseur. Facultatif et généralement inutile : la passerelle route automatiquement. À envisager si vous avez des exigences en matière de modération du contenu ; une fois un fournisseur sélectionné, les requêtes ne basculent pas vers un autre s’il est indisponible.
▸ Détails
L’en-tête X-OfoxAI-Provider-Type est équivalent. Voir Avancé : sélectionner un fournisseur.
Réponse
{
  "created": 1777385517,
  "data": [
    { "b64_json": "iVBORw0KGgoAAAANSUhEUgAA…", "index": 0 }
  ],
  "model": "openai/gpt-image-2.5-flare",
  "size": "1024x1024",
  "quality": "low",
  "usage": {
    "input_tokens": 13,
    "input_tokens_details": { "text_tokens": 13 },
    "output_tokens": 196,
    "output_tokens_details": { "image_tokens": 196 },
    "total_tokens": 209
  }
}L’image encodée en base64, sans le préfixe data:image/png;base64,.
▸ Détails
Décodez-la puis écrivez le fichier ; pour l’afficher dans un navigateur, ajoutez vous-même le préfixe. La réponse ne contient pas de champ url.
Index de l’image ; distingue les images lorsque n > 1.
Taille de sortie réelle. Si size a été omis ou vaut auto, lisez ici la taille effective.
Niveau de qualité réellement utilisé. Si quality a été omis, ce champ indique le niveau appliqué.
Arrière-plan et format réellement utilisés. Pas toujours renvoyés : ne vous fiez pas à ces deux champs.
Consommation facturée. output_tokens correspond aux tokens de l’image produite, input_tokens_details.text_tokens aux tokens de la consigne.
▸ Détails
Calculez le coût d’un appel à partir de ces valeurs.
Éditer des images
POST https://api.ofox.io/v1/images/editsCet endpoint prend en charge GPT Image, Nano Banana (Gemini) et MAI Image. Seedream et Qwen-Image y renvoient 400 endpoint_not_supported : utilisez plutôt le champ d’images de référence de l’endpoint de génération ; voir Seedream et Qwen-Image.
Paramètres de la requête
Envoyés en multipart/form-data, sous forme de champs de formulaire, avec un fichier image téléversé. Les valeurs possibles et par défaut s’appliquent là encore à la famille GPT Image.
ID du modèle ; mêmes règles qu’en génération. Les modèles pris en charge figurent dans le tableau en haut de cette page.
Image de référence, sous forme de fichier local (préfixe @ en cURL) et non d’URL.
▸ Détails
Pour plusieurs images, répétez le champ sous le nom image[]. 15 Mo maximum par image, 50 Mo maximum pour le corps de la requête ; la passerelle n’impose pas de limite de nombre, mais 16 images au plus sont recommandées.
Consigne de modification.
Masque de retouche localisée : un PNG avec canal alpha, aux mêmes dimensions que image ; la zone transparente correspond à la partie à redessiner.
▸ Détails
Effectif uniquement sur cet endpoint : envoyé à l’endpoint de génération, il est ignoré silencieusement. Préparation et résultat mesuré : GPT Image · Retouche localisée par masque.
Taille de sortie ; mêmes règles qu’en génération.
▸ Détails
Omis ou auto, c’est le modèle qui décide, sans garantie de correspondre à l’image d’origine. Indiquez-la explicitement pour conserver la taille d’origine.
Niveau de qualité ; mêmes règles qu’en génération : gpt-image-2 n’a pas xhigh / max.
Nombre d’images ; chacune est facturée séparément.
▶Avancés · 1X-OfoxAI-Provider-TypeExpand
Sélectionne un fournisseur. Facultatif et généralement inutile : la passerelle route automatiquement. À envisager si vous avez des exigences en matière de modération du contenu ; une fois un fournisseur sélectionné, les requêtes ne basculent pas vers un autre s’il est indisponible.
▸ Détails
Cet endpoint est un envoi multipart : pour fixer le fournisseur, seul l’en-tête fonctionne ; un champ de formulaire extra_body est ignoré silencieusement. Voir Avancé : sélectionner un fournisseur.
Réponse
Même structure qu’en génération ; usage contient en plus les tokens d’entrée des images de référence :
{
  "created": 1777385669,
  "data": [
    { "b64_json": "iVBORw0KGgoAAAANSUhEUgAA…", "index": 0 }
  ],
  "model": "openai/gpt-image-2",
  "size": "auto",
  "quality": "low",
  "usage": {
    "input_tokens": 1041,
    "input_tokens_details": { "image_tokens": 1024, "text_tokens": 17 },
    "num_input_images": 1,
    "output_tokens": 358,
    "total_tokens": 1399
  }
}Tokens d’entrée correspondant aux images de référence. Nous avons mesuré 1 024 tokens pour une image de référence de 1024×1024. C’est surtout ce poste qui rend une édition plus chère qu’une génération texte vers image de même taille.
Nombre d’images de référence ; permet de vérifier que le modèle les a bien lues.
Les autres champs sont identiques à ceux de la réponse de génération.
Pour les modèles pris en charge et leurs prix, consultez le catalogue des modèles .
Appel
Python
import base64
from openai import OpenAI

client = OpenAI(api_key="YOUR_OFOX_API_KEY", base_url="https://api.ofox.io/v1", timeout=600)

with open("apple.png", "rb") as f:
    resp = client.images.edit(
        model="openai/gpt-image-2",
        image=f,
        prompt="Rends la pomme verte, ne change rien d'autre",
        size="auto",
        quality="low",
    )

with open("apple_edited.png", "wb") as out:
out.write(base64.b64decode(resp.data[0].b64_json))Le champ image attend un chemin de fichier local (préfixe @ en cURL), et non une URL.
Comparaison mesurée :
| Image d’origine | Après édition |
|---|---|
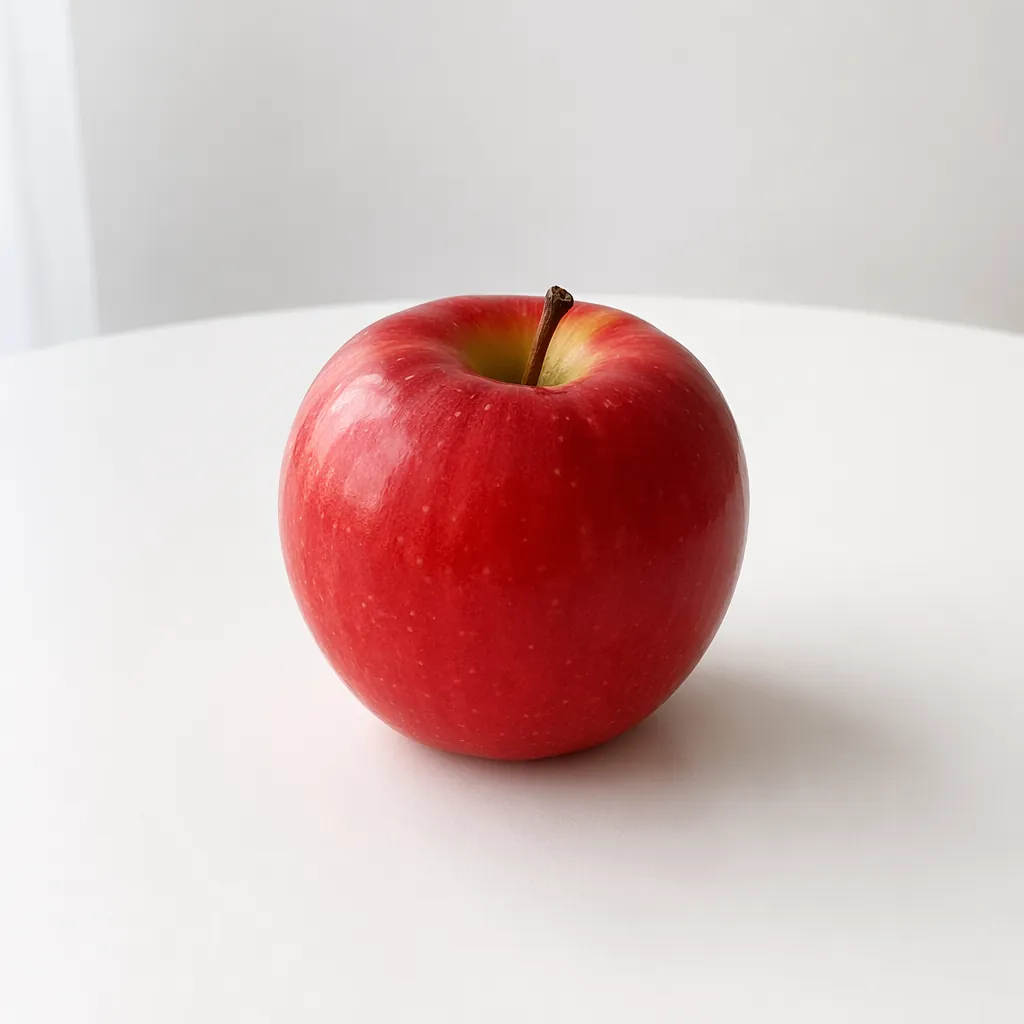 | 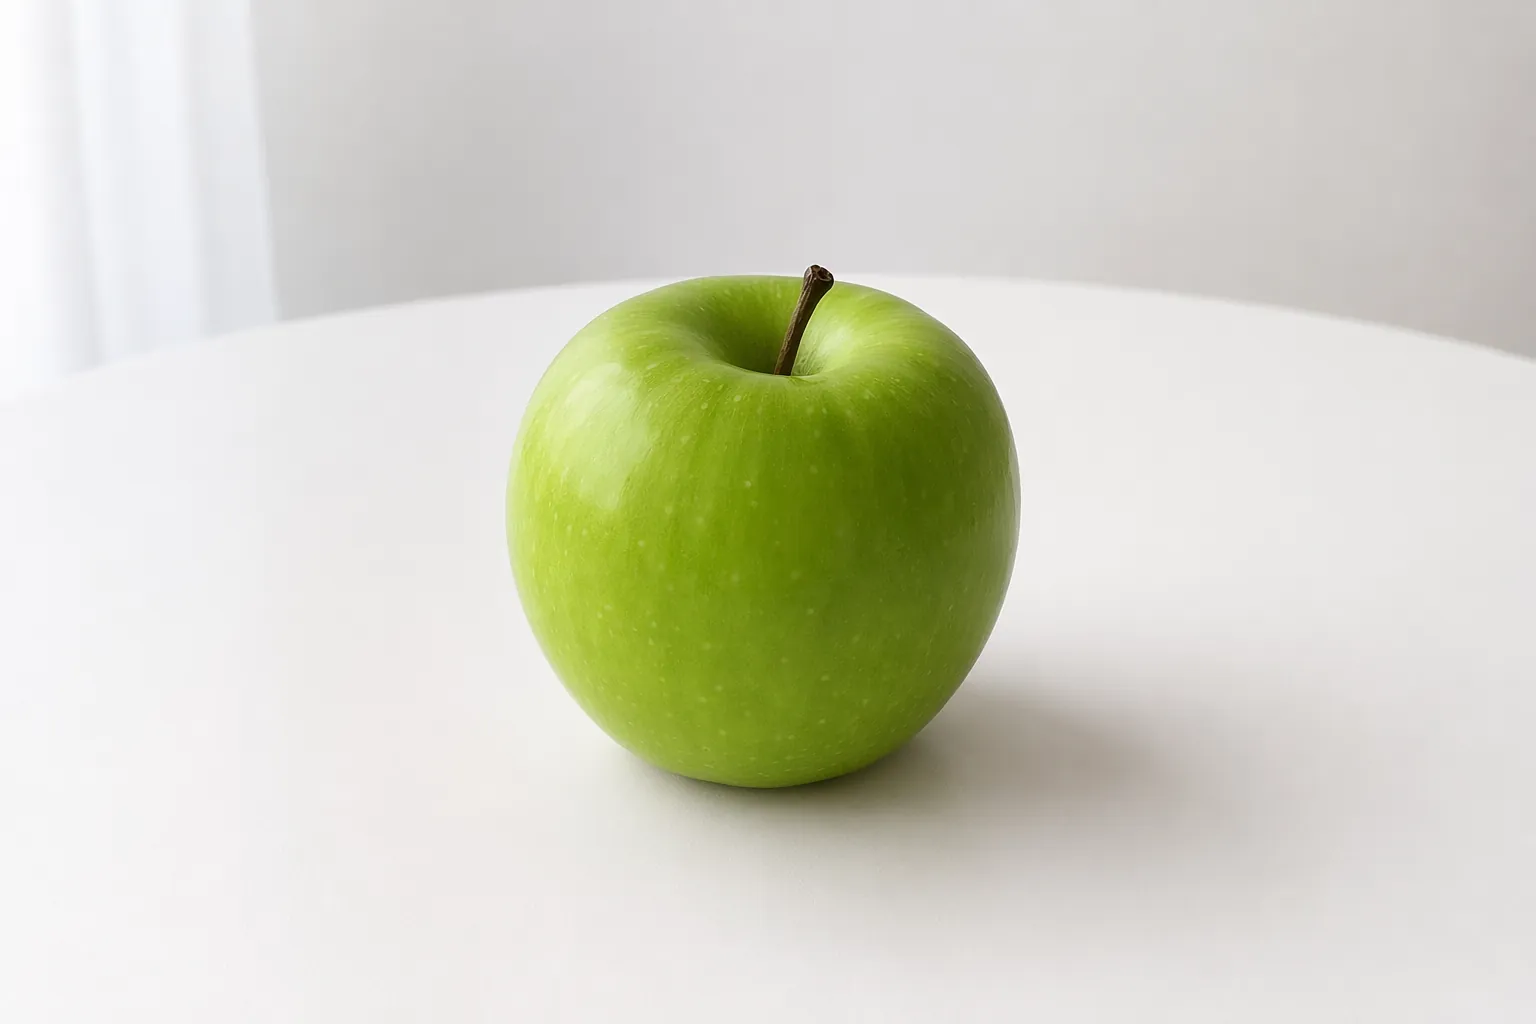 |
Erreurs
En cas d’erreur, la réponse comporte un code HTTP d’erreur et la structure suivante (mesurée) :
{
  "error": {
    "code": null,
    "message": "The model 'gpt-image-2' does not support quality 'xhigh'.",
    "param": null,
    "request_id": "fbe4f24c-779d-41a0-8b3a-c62886cdd1ae",
    "type": "image_generation_user_error"
  }
}
code peut valoir null. Fondez-vous sur le code HTTP et sur message.
Lorsque vous contactez le support, joignez le request_id de la réponse et le détail de l’erreur (code HTTP et error.message). Il est conseillé de les journaliser.
Avancé : sélectionner un fournisseur
Facultatif et généralement inutile. Les trois modèles GPT Image (gpt-image-2.5-flare, gpt-image-2.5-sunburst, gpt-image-2) sont servis à la fois par azure_foundry et par openai, en génération comme en édition. Sans sélection, la passerelle route automatiquement.
Vous pouvez sélectionner un fournisseur si vous avez des exigences en matière de modération du contenu. Les requêtes vont alors uniquement vers ce fournisseur ; s’il est indisponible, elles ne basculent pas automatiquement vers un autre.
Sélectionner un fournisseur qui ne sert pas le modèle renvoie 400 provider_type_unavailable.
Les deux fournisseurs d’openai/gpt-image-2 n’appliquent pas la même sévérité de modération. Si une consigne est refusée à répétition, vous pouvez sélectionner explicitement openai. Sans sélection, les requêtes sont réparties de façon pondérée et peuvent aboutir sur azure_foundry.
Texte vers image /v1/images/generations
Corps JSON : le champ du corps extra_body.provider.type et l’en-tête X-OfoxAI-Provider-Type fonctionnent tous les deux.
Python
resp = client.images.generate(
    model="openai/gpt-image-2",
    prompt="A simple red apple on a white table",
    size="1024x1024",
    extra_body={"extra_body": {"provider": {"type": "openai"}}},
)Avec les SDK OpenAI officiels, extra_body doit figurer comme clé littérale dans le corps de la requête. Avec le SDK TypeScript, il suffit d’écrire extra_body directement dans l’objet de paramètres. L’argument extra_body= du SDK Python fusionne son contenu à la racine du corps : ajoutez donc un niveau d’imbrication, ou utilisez plutôt l’en-tête.
Image vers image /v1/images/edits
Un envoi multipart n’a pas de corps JSON où imbriquer extra_body : seul l’en-tête est utilisable.
curl https://api.ofox.io/v1/images/edits \
  -H "Authorization: Bearer $OFOX_API_KEY" \
  -H "X-OfoxAI-Provider-Type: openai" \
  -F "model=openai/gpt-image-2" \
  -F "prompt=..." \
  -F "image=@input.png"
Avec les SDK : en Python, passez extra_headers={"X-OfoxAI-Provider-Type": "openai"} ; en TypeScript, passez { headers: { 'X-OfoxAI-Provider-Type': 'openai' } } en second argument.
Sur /v1/images/edits, un extra_body envoyé en champ de formulaire est ignoré silencieusement : l’image est générée normalement, mais la contrainte ne s’applique pas. Utilisez plutôt X-OfoxAI-Provider-Type.
Référence complète : API · Routage des fournisseurs.
Documentation officielle et ressources
La documentation officielle décrit le comportement en appel direct à OpenAI. En cas d’écart avec les mesures effectuées sur OfoxAI, les mesures de ce site font foi.
Documentation officielle d’OpenAI
- Guide de génération d’images · Générer des images
- Guide de génération d’images · Éditer des images
- Guide de génération d’images · Édition localisée avec un masque
- Guide de génération d’images · Taille et qualité
- Guide de génération d’images · Calcul des coûts
- Référence de l’Images API
Pages des familles OfoxAI
- Présentation de la famille GPT Image : choix du modèle, taille, qualité, latence, erreurs
- Texte vers image
- Édition et multi-image
- Retouche localisée
- Famille Nano Banana (Gemini Image) et diagnostic des erreurs
- Famille Seedream
- Famille Qwen-Image
- Famille MAI Image