给 Opus 视频加 AI 配音:用 Ofox 调用 Gemini TTS,再合成 MP4
从台词生成真实 WAV,测量每句时长,修正旁白超窗,再用 FFmpeg 合成 MP4。附 Ofox Gemini TTS 调用代码、五段音频和可复现视频。
 Ofox
给 Opus 辅助制作的视频加配音,需要把语音生成和视频渲染分开:先生成声音,再测时长、安排入点,最后导出包含音轨的 MP4。本文用 Ofox API 调用 Gemini 3.8 Flash TTS,将五段真实语音放入演示视频,得到一份 32 秒成片。音频来自 2026 年 10 月 9 日的实际 API 响应。
这是 Opus 视频制作主指南的后期延伸。画面复用该系列已有的 30 秒截图演示,界面截图是 9 月 30 日的历史素材,不代表当前页面全部细节;本次没有重新调用 Opus 生成画面。Gemini 负责声音,本地代码负责时间线和封装,排查问题时也按这三层分别检查。
下载完整复现包、观看配音 MP4,或下载完整 WAV。用包内保存的音频重新合成不消耗 API 额度。示例口播为英文,中文说明不代表另有中文配音实测。
1. 先按画面拆台词
连续旁白适合播客,界面演示则要保证讲到文档时能看到文档。我们把介绍拆成五句:明确制作需求、展示目录、找到文档、展示 API 参考、提醒检查。每句单独生成,某句不合适时只重做这一段,不必重新生成整条音轨。
台词没有描述模型数量、优惠或性能排名,避免旧界面中的数字被讲成今天的产品承诺。生成前先写下每句开始时间、最晚结束时间和完整文字,再决定原音轨是替换还是混音。本例直接替换原音轨,不含背景音乐、声音克隆、口型同步或逐词字幕对齐。这些需求不能靠改一个导出参数顺便完成。
画面工程见截图制作产品演示教程。已有的配音与字幕同步教程讨论本地参考音频和字幕时间表;这篇新增的是 Ofox 真实语音请求及其时长测量,两者可以配合使用。
2. 核对模型、声音和格式
本次参数为 google/gemini-3.8-flash-tts、音色 Kore、语言 en-US、speed: 1.0 和 response_format: wav。请从 Gemini TTS 模型页复制精确 ID,不要换成普通 Gemini 文本型号。实际文件为单声道、16 位 PCM、24,000 Hz WAV;扩展名不能证明格式,后面还要检查流信息并完整解码。
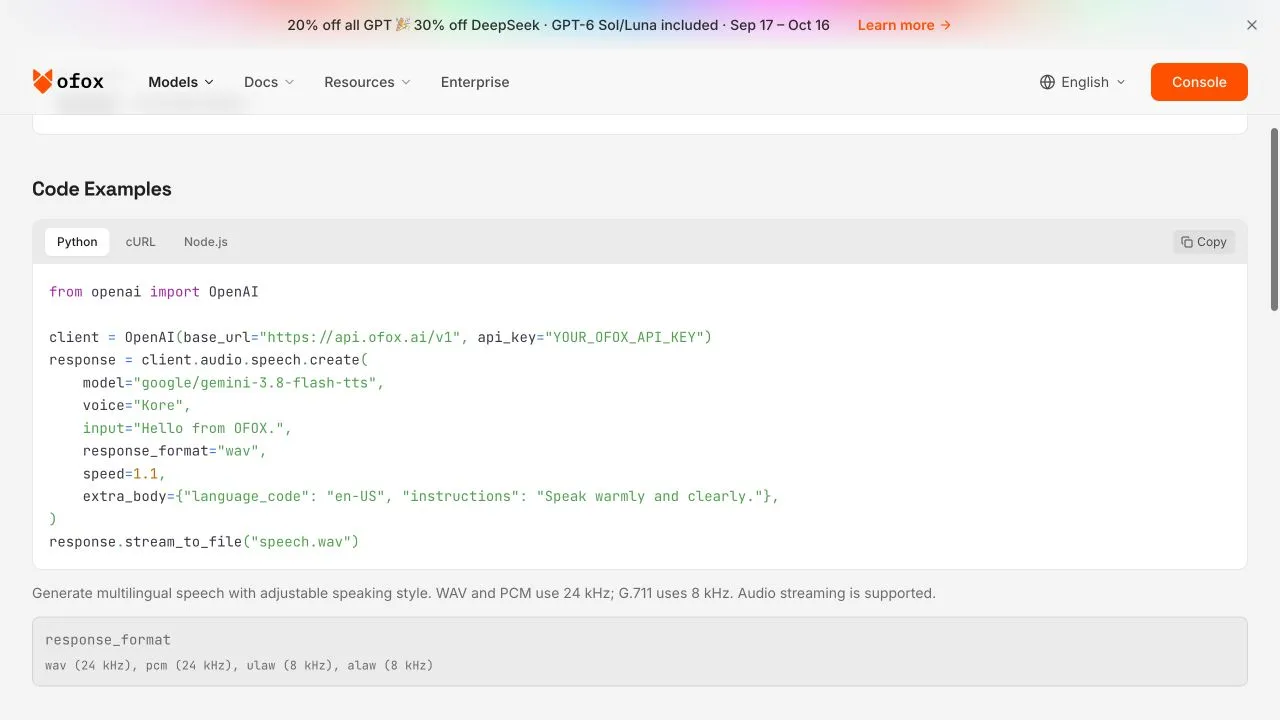
2026 年 10 月 9 日真实页面截图,保留英文原界面。页面示例语速是 1.1,本次请求记录使用 1.0。截图证明页面显示的接入方式;实际生成结果由下载包的 WAV 和请求记录证明。
准备 Python 3、requests、FFmpeg 和 ffprobe。Key 通过 OFOX_API_KEY 环境变量提供,不要写入共享代码、前端页面或提交到仓库。下面是类 Unix shell 命令;Windows 的虚拟环境激活和环境变量设置不同,但 Python 请求逻辑相同。
python3 -m venv .venv
. .venv/bin/activate
python3 -m pip install requests
ffmpeg -version
ffprobe -version
WAV 比压缩音频大,却方便检查和拼接。最终 MP4 再编码成 AAC,避免把编辑中间文件反复压缩。Google 的语音生成与格式文档说明上游能力;本文请求以 Ofox 模型页和真实结果为准,不能默认上游所有参数都已被网关开放。
3. 先生成一段,别把错误保存成音频
下载包中的 audio_api.py 使用固定的 Ofox 接口地址,在请求前检查媒体工具,记录响应类型、状态、request ID 和文件哈希,不保存 Authorization 头。它先验证成功响应,再保存、测量和解码,也不会自动重试可能产生费用的 POST。
python3 audio_api.py speech --engine gemini \
  --text narration.en.txt --output first-take.wav --language en-US
这个命令读取包内完整短台词,生成连续试音。五段成片旁白则使用独立台词分别请求。下面展示最小调用结构;需要完整验证和证据保存时,使用下载包客户端。
import os
from pathlib import Path
import requests

response = requests.post(
    "https://api.ofox.io/v1/audio/speech",
    headers={"Authorization": "Bearer " + os.environ["OFOX_API_KEY"]},
    json={
        "model": "google/gemini-3.8-flash-tts",
        "voice": "Kore",
        "input": "A clear product video starts with a clear brief.",
        "language_code": "en-US",
        "speed": 1.0,
        "response_format": "wav",
    },
    timeout=(15, 120),
)
response.raise_for_status()
if not response.headers.get("content-type", "").startswith("audio/"):
    raise RuntimeError("Expected audio; inspect the response before saving")
Path("line.wav").write_bytes(response.content)
首次连续试音返回 HTTP 200,时长 10.4 秒;随后五句也分别生成成功。这个结果只证明本次请求成功,不保证重跑输出完全相同。请求参数与音频哈希必须一起保留,改了台词后不能继续复用旧 WAV,却把它标成新台词的生成结果。
遇到超时,先查请求记录和用量,再决定是否重发;没收到响应不等于服务端没做过工作。若返回 JSON 错误,应单独保存错误与 request ID,不能直接写成 speech.wav 后再把它当成坏音频排查。
4. 用真实时长修正时间窗
下面测量完整 WAV,包括可能存在的尾部静音,不是音素边界。不要根据字数或期望语速估算之后就直接拼接。
ffprobe -v error -show_entries stream=codec_name,sample_rate,channels \
-show_entries format=duration -of json scenes/line-1.wav| 场景 | 实际英文台词 | 开始 | WAV 时长 | 音频结束 |
|---|---|---|---|---|
| 制作需求 | A clear product video starts with a clear brief. | 0.35 秒 | 3.56 秒 | 3.91 秒 |
| 目录 | Show the real interface. Here, we begin with the model catalog. | 4.35 秒 | 4.64 秒 | 8.99 秒 |
| 文档 | Then show where a viewer can find the documentation. | 11.35 秒 | 3.44 秒 | 14.79 秒 |
| API 参考 | Connect each scene to an actual page, such as this API reference. | 18.35 秒 | 4.96 秒 | 23.31 秒 |
| 结尾 | Keep the message simple. Plan, build, and verify. | 25.35 秒 | 5.44 秒 | 30.79 秒 |
第一次检查有两句超窗。首句比原定 3.60 秒结束点多出 0.31 秒,因此把允许结束点延到 4.00 秒,仍位于下一场景之前。末句比原定 29.50 秒结束点多出 1.29 秒,实际已经跨过原视频结尾。我们把最后一帧延长两秒,成片改为 32 秒,末句窗口改到 31.50 秒。
没有截掉词尾,也没有悄悄加速。若投放要求严格 30 秒,就不能直接提交这份延长版,应改短最后一句、只重生成该段并再次测量。即使设置语速倍率,也不能保证输出时长精确按比例缩短。
5. 从已保存的音频组装 MP4
解压后,scenes/ 包含五段 WAV 与时间表,source.mp4 是历史无配音参考。进入目录后运行:
python3 assemble_scenes.py scenes source.mp4 rebuilt此步骤不调用 API,不需要 Key。程序核对音频哈希、PCM 格式和修订后的时间窗,按开始时间写入采样,其余位置补静音;再把原视频流与新音轨组成 H.264/AAC MP4。任何一句超窗都会报错,不能依靠 -shortest 静默丢掉结尾。
音频按采样时钟定位,视频按帧显示,两者并不相同。这份句子时间表不能拿来冒充逐词字幕。通用的 mux.py 则适合已有完整旁白的场景:它替换原音轨、补足尾部静音,但拒绝比视频更长的旁白。本例有延长结尾的明确编辑决定,所以应使用专用组装脚本。
如果要让 Opus 修改自己的工程,可以使用下面的任务模板。它是可复用提示词,不代表本次又做了一次模型测试。
只修改现有视频合成与时间数据,保留已确认的截图和场景顺序。
使用附件 WAV,不重新生成声音,不删减口播词句。
按 timing.json 的实测开始时间插入每句旁白。
渲染前报告超窗;需要延长场景时,说明受影响的切点与总时长。
保留全部可见文字,返回修改文件、渲染命令和需要检查的帧。
不要根据句子时间宣称已完成口型或逐词对齐。
6. 检查导出文件和需要人工判断的部分
ffprobe -v error -show_streams -show_format -of json rebuilt/narrated.mp4
ffmpeg -v error -i rebuilt/narrated.mp4 -f null -
本例视频时间线为 32 秒,包含 H.264 视频和 AAC 音频,原始拼接 WAV 正好 32 秒。AAC 编码填充可能让流或容器报告略有差别,不能仅凭小数差异判断内容被截断。完整解码必须通过,但解码器不能评价发音自然度或旁白是否讲对画面。
发布自己的版本前,应完整播放,重点听产品名、缩写、每句开头与最后一个词,再看最长句和切镜处。本文验证的是请求成功、格式、时长、放置位置与解码,没有组织人工比较听评,也不据此声称 Gemini 比其他服务更好听。下载音频后可以直接判断它是否符合自己的用途。
日、韩、俄等配音要重新本地化台词并生成,不能照搬英文时长。译文长度和停顿都会变;换字幕也不等于完成语音本地化。
7. 按故障所在层排查
| 现象 | 先检查 | 处理 |
|---|---|---|
| 401 配额错误 | 错误原文、request ID、是否来自供应商 | 核对对应账号或上游通道,不能直接断言 Ofox 钱包没余额 |
| 400 格式错误 | 精确型号与格式组合 | 本例先使用已验证的 WAV 参数 |
| WAV 无法打开 | 是否把 JSON 错误当音频保存 | 先判断状态和内容类型,错误单独保留 |
| 旁白跨切镜 | 实际时长与下一个切点 | 改短该句或延长画面,再验一次 |
| MP4 没声音 | 音轨映射和最终流信息 | 显式选择新音轨,检查导出文件 |
| 重试后重复扣费 | 首次请求状态与用量 | 不盲目重发付费 POST |
本次准备中,同一把 Ofox Key 成功调用 Gemini,而 ElevenLabs 语音与 Scribe 通道返回配额错误;只读查询确认 Ofox 余额为正。因此不能要求用户为 Ofox 充值,问题更指向受影响的上游通道,具体账号状态仍待核查。ElevenLabs 官方记录了这类 401 配额错误。这是本次带日期的排障观察,不是对其长期可用性的结论。
费用也要分清目录报价、实际用量和最终扣费。按音频 token 计费,不能只根据成片秒数推出准确账单;本文没有独立核对结算,所以不报总费用或节省比例。扩大生成量前先核对当前模型页与自己的请求明细。
保存台词、五段原始音频、时间表、拼接 WAV 和 MP4 为同一版本。下一次改稿只换受影响的句子,测完再导出,不因字数相近就继续套旧时长。
常见问题
- 这段配音是 Opus 5.5 生成的吗?
- 不是。WAV 由 Gemini 3.8 Flash TTS 经 Ofox API 生成,音画在本地通过 FFmpeg 合成。Opus 可以辅助修改视频工程,本文没有新增一次 Opus 调用实测。
- 不消耗 API 额度,能复现成片吗?
- 可以。下载包提供五段已生成的 WAV 和源视频,本地组装不调用 API。重新生成旁白才需要有模型访问权限和可用额度的 Key。
- 把 speed 调高,能让旁白准确塞进场景吗?
- 不能保证。语速参数不等于精确时长控制。应测量实际输出,必要时改短台词或延长画面,然后重新检查,不能静默截断声音。