Как озвучить видео, созданное с помощью Opus: Gemini TTS через Ofox
Генерируем речь через Ofox, измеряем пять WAV-файлов, исправляем выход за границы сцен и собираем MP4. Прилагаются Python-код, аудио и готовый пример.
 Ofox
Чтобы добавить AI-озвучку к видео, сделанному с помощью Opus, сначала сгенерируйте речь отдельно, измерьте её длительность и разместите реплики на таймлайне. Затем экспортируйте файл с видеопотоком и новой звуковой дорожкой. Здесь мы используем Gemini 3.8 Flash TTS через API Ofox, Python и FFmpeg. Результат — 32-секундный MP4; предоставленные аудиофайлы получены из реальных ответов API 9 октября 2026 года.
Это продолжение руководства по видео с Opus, посвящённое звуку. Изображение взято из уже существующего 30-секундного демонстрационного ролика. Скриншоты интерфейса сделаны 30 сентября и служат историческим примером, а не отражением всех деталей текущего сайта. В этой работе мы не проводили новый тест Opus для создания видеоряда: Gemini создаёт голос, локальный код отвечает за размещение и экспорт.
Скачать комплект для воспроизведения, посмотреть MP4 с озвучкой или скачать собранный WAV. Повторная сборка из сохранённых файлов не вызывает платный API. Речь в примере английская: перевод статьи на русский не является тестом русскоязычного синтеза.
1. Разделите текст по сценам
Непрерывная дорожка удобна для подкаста, но в демонстрации интерфейса слова должны соответствовать экрану. Когда звучит пояснение о документации, зритель должен видеть документацию. Поэтому мы оставили пять коротких реплик и сгенерировали каждую отдельно. Это позволяет заменить одну неудачную фразу без повторной генерации всего текста.
Реплики описывают задачу, каталог, документацию, API-справочник и финальную проверку. Они не обещают определённого количества моделей, скидки или превосходства в качестве. При повторном использовании старых скриншотов это особенно важно: нельзя превращать показанные на них исторические цифры в актуальные обещания продукта.
До генерации запишите точный текст, время начала и максимально допустимое время окончания каждой реплики. Решите также, заменять исходный звук или смешивать его с новым. В нашем примере исходная дорожка заменяется. Здесь нет фоновой музыки, клонирования голоса, синхронизации губ или субтитров по отдельным словам — для них нужны дополнительные материалы и отдельная проверка.
Исходная визуальная часть описана в уроке по демонстрационному видео из скриншотов. Работа с титрами рассматривается в руководстве по синхронизации озвучки и субтитров. Здесь мы добавляем реальный запрос TTS через Ofox и измерения его результата.
2. Проверьте модель, голос и формат
В проверенных запросах использованы google/gemini-3.8-flash-tts, голос Kore, язык en-US, speed: 1.0 и response_format: wav. Точный ID берите со страницы Gemini TTS, а не подставляйте название текстовой модели Gemini. Полученные файлы — монофонический WAV с 16-битным PCM и частотой 24 000 Гц. Расширение файла само по себе этого не доказывает: ниже мы проверяем параметры потока и декодируем файл целиком.
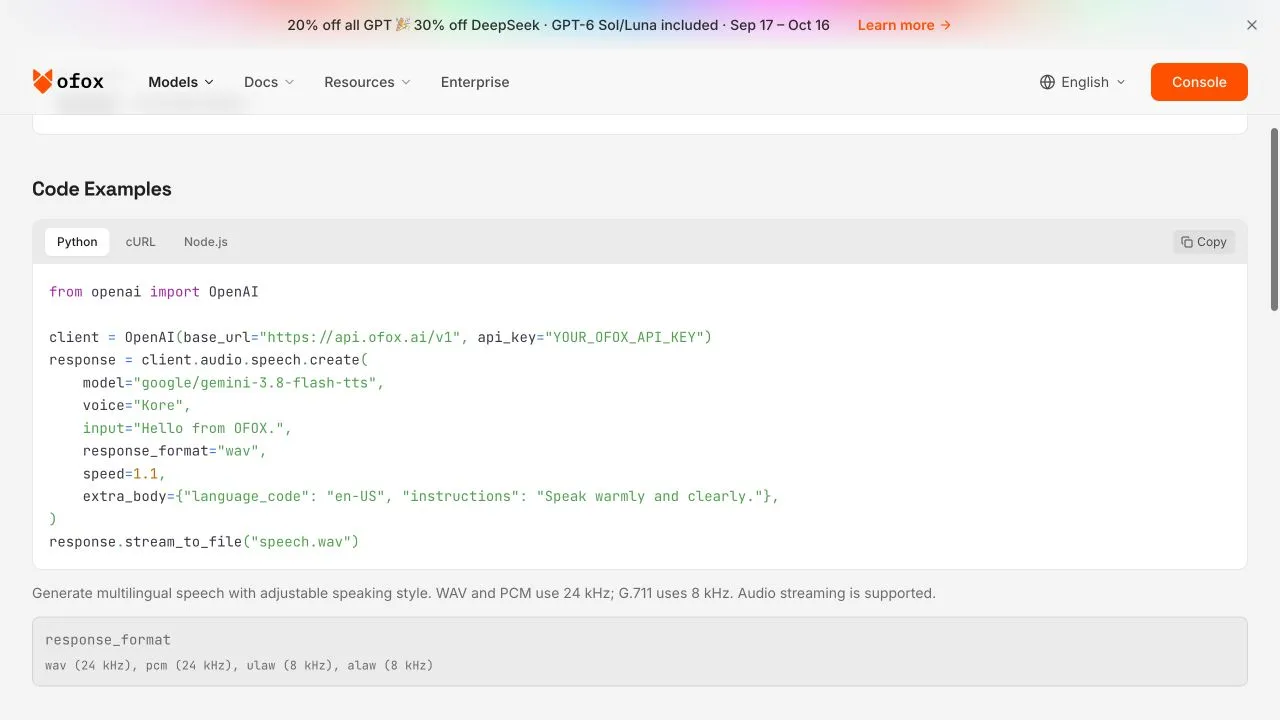
Реальный снимок страницы от 9 октября 2026 года; интерфейс оставлен на английском. На странице показан speed 1.1, тогда как в наших записанных запросах использован 1.0. Скриншот подтверждает отображаемый способ подключения, а успешную генерацию — WAV и записи запросов.
Понадобятся Python 3, пакет requests, FFmpeg и ffprobe. Ключ передаётся через переменную окружения OFOX_API_KEY. Не вставляйте его в общедоступный скрипт, клиентский код браузера или коммит. Команды ниже рассчитаны на Unix-подобную оболочку; в Windows активация виртуального окружения и установка переменной выглядят иначе, но Python-запрос остаётся тем же.
python3 -m venv .venv
. .venv/bin/activate
python3 -m pip install requests
ffmpeg -version
ffprobe -version
WAV занимает больше места, чем сжатый звук, зато его удобно проверять и собирать. В AAC мы кодируем только итоговый MP4, не пережимая промежуточные файлы многократно. Документация Google по синтезу и форматам описывает upstream-интерфейс; для запроса через шлюз сверяйтесь со страницей Ofox. Возможность у исходного провайдера не означает её автоматическую поддержку каждым посредником.
3. Отправьте небольшой запрос и отделите ошибки от аудио
Скрипт audio_api.py использует фиксированный базовый URL Ofox, проверяет наличие инструментов для обработки медиа до платного запроса, читает ключ из окружения и сохраняет метаданные без заголовка Authorization. Перед сохранением он проверяет HTTP-статус и Content-Type, затем измеряет и полностью декодирует аудио. Автоматического повтора платных POST-запросов нет.
python3 audio_api.py speech --engine gemini \
  --text narration.en.txt --output first-take.wav --language en-US
Эта команда создаёт один непрерывный пробный дубль из текста, включённого в архив. Для готового ролика пять реплик генерировались отдельно. Ниже — основа Python-запроса; для дополнительных проверок и журналирования используйте клиент из архива.
import os
from pathlib import Path
import requests

response = requests.post(
    "https://api.ofox.io/v1/audio/speech",
    headers={"Authorization": "Bearer " + os.environ["OFOX_API_KEY"]},
    json={
        "model": "google/gemini-3.8-flash-tts",
        "voice": "Kore",
        "input": "A clear product video starts with a clear brief.",
        "language_code": "en-US",
        "speed": 1.0,
        "response_format": "wav",
    },
    timeout=(15, 120),
)
response.raise_for_status()
if not response.headers.get("content-type", "").startswith("audio/"):
    raise RuntimeError("Expected audio; inspect the response before saving")
Path("line.wav").write_bytes(response.content)
Первый непрерывный тест вернул HTTP 200 и WAV длительностью 10,4 секунды. Затем мы получили успешные ответы на пять отдельных запросов — по одному для каждой сцены. Это подтверждает конкретные вызовы, но не гарантирует такую же длину повторного дубля или неограниченную доступность сервиса. Храните параметры рядом с хешем аудио: нельзя после изменения текста выдать старый WAV за новый результат.
При тайм-ауте сначала проверьте состояние запроса и расход, затем решайте, повторять ли его. Отсутствие ответа не доказывает, что генерации не было. JSON с ошибкой, сохранённый как speech.wav, тоже не становится повреждённой речью. Сохраняйте ошибку и request ID отдельно, чтобы не искать проблему в кодеке вместо HTTP-обработки.
4. Измерьте реплики и исправьте реальные выходы за границы
Проверяйте каждый WAV через ffprobe. Длительности ниже относятся ко всему файлу, включая возможную тишину в конце. Это не измерения отдельных фонем.
ffprobe -v error -show_entries stream=codec_name,sample_rate,channels \
-show_entries format=duration -of json scenes/line-1.wav| Сцена | Точная английская реплика | Начало | Длина WAV | Конец |
|---|---|---|---|---|
| Задача | A clear product video starts with a clear brief. | 0,35 с | 3,56 с | 3,91 с |
| Каталог | Show the real interface. Here, we begin with the model catalog. | 4,35 с | 4,64 с | 8,99 с |
| Документация | Then show where a viewer can find the documentation. | 11,35 с | 3,44 с | 14,79 с |
| API | Connect each scene to an actual page, such as this API reference. | 18,35 с | 4,96 с | 23,31 с |
| Завершение | Keep the message simple. Plan, build, and verify. | 25,35 с | 5,44 с | 30,79 с |
Две реплики не прошли первоначальную проверку. Первая превысила запланированную границу 3,60 секунды на 0,31 секунды. Мы расширили её окно до 4,00 секунды, до начала следующей сцены. Последняя вышла за границу 29,50 секунды на 1,29 секунды и закончилась уже после исходного 30-секундного видео. Последний кадр удерживается ещё две секунды: результат длится 32 секунды, новое окно последней реплики заканчивается на 31,50 секунды.
Мы не обрезали слова и не ускоряли звук незаметно для читателя. Если площадка требует ровно 30 секунд, предоставленный 32-секундный вариант не подходит. Сократите заключительную фразу, перегенерируйте только её и снова измерьте. Настройка скорости не гарантирует математически точного преобразования 5,44 секунды в нужный интервал.
5. Соберите видео из сохранённых файлов
В архиве лежат scenes/line-1.wav–line-5.wav, манифест времени и source.mp4 — исторический пример без озвучки. Из распакованного каталога выполните:
python3 assemble_scenes.py scenes source.mp4 rebuiltКлюч не нужен, сетевых запросов нет. Сборщик проверяет хеш каждого аудиофайла, формат PCM и исправленные временные окна. Он размещает отсчёты по заданным начальным позициям, заполняет остальную дорожку тишиной и выбирает только исходное изображение и новый голос для MP4 с H.264/AAC. Реплика за границами окна вызывает ошибку; её конец не теряется молча из-за -shortest.
Звуковые отсчёты на частоте 24 кГц и кадры видео используют разные шкалы времени. Точное размещение аудиофайла не даёт временных меток отдельных слов. Универсальный mux.py предназначен для замены готовой звуковой дорожки и отвергает звук длиннее видео. Для этого примера с осознанным двухсекундным продлением используйте специальный сборщик сцен, а не ожидайте от общего инструмента монтажных решений.
После измерения можно передать Opus ограниченную задачу по правке своего проекта. Это шаблон для повторного использования, а не запись дополнительного модельного теста:
Измени только текущую видеокомпозицию и данные времени.
Сохрани согласованные скриншоты и порядок сцен.
Используй приложенные WAV; не генерируй звук заново и не сокращай слова.
Размести реплики по измеренным началам из timing.json.
До рендера сообщи о выходе за границы. Если нужна более длинная сцена,
укажи, какие точки монтажа и общая длительность меняются.
Сохрани весь видимый текст. Верни изменённые файлы, команду рендера
и кадры для проверки. Не заявляй о синхронизации губ или отдельных слов
на основании времён целых реплик.
6. Проверяйте экспорт, а не только предпросмотр
ffprobe -v error -show_streams -show_format -of json rebuilt/narrated.mp4
ffmpeg -v error -i rebuilt/narrated.mp4 -f null -
Таймлайн итогового видео — 32 секунды, кодеки — H.264 и AAC. Исходный собранный WAV имеет ровно 32 секунды. Из-за дополнения при кодировании длительность сжатого потока и контейнера иногда немного различается; небольшое расхождение не доказывает обрезку содержания. Полное декодирование должно завершиться без ошибок, но декодер не оценивает произношение и соответствие слов экрану.
Прослушайте первую фразу, переходы, самую длинную реплику и последнее слово. Отдельно оцените названия продуктов, аббревиатуры и паузы. Наши записи подтверждают API-ответы, формат, длительность, размещение и декодирование. Это не экспертная панель слушателей и не доказательство превосходства Gemini над другим сервисом. Готовый файл позволяет самостоятельно оценить голос для своей задачи.
Для русского, японского или корейского дубля нужны отдельные тексты, генерация и проверка. Перевод меняет длину, произношение и паузы; английские времена не переносятся автоматически. Переведённые субтитры также не заменяют локализацию речи.
7. Определите, на каком уровне произошёл сбой
| Проблема | Что проверить | Действие |
|---|---|---|
| 401 с сообщением о квоте | Текст ошибки, request ID и лимит провайдера | Проверить соответствующий аккаунт или маршрут, не объявлять кошелёк Ofox пустым |
| 400 при выборе формата | Точный ID и допустимую комбинацию параметров | Начать с проверенного WAV-пресета |
| WAV не открывается | Не сохранён ли JSON вместо звука | Проверять HTTP-статус и Content-Type, ошибки хранить отдельно |
| Реплика пересекает монтажный переход | Измеренную длину и следующую границу | Сократить текст или продлить сцену и перепроверить |
| В MP4 нет звука | Выбор потоков в готовом файле | Явно выбрать новую дорожку, декодировать экспорт |
| Повторный запрос увеличил расход | Исходный результат и журнал использования | Не повторять платный POST вслепую |
При подготовке один и тот же ключ Ofox успешно создавал Gemini-аудио, а маршруты ElevenLabs speech и Scribe возвращали 401 с исчерпанной квотой. Проверка баланса Ofox показала положительный остаток. Эти данные не дают оснований советовать пополнить кошелёк Ofox: нужно разбираться с затронутым upstream-маршрутом. Состояние конкретного аккаунта провайдера ещё не установлено. ElevenLabs описывает такой класс ошибок 401 при превышении квоты. Это наблюдение на дату теста, не заявление о постоянной недоступности сервиса.
Разделяйте опубликованные ставки, фактическое использование и окончательное списание. Тарификацию по аудиотокенам нельзя точно пересчитать в стоимость минуты по одной длительности файла. Здесь нет независимо сверенного счёта, поэтому мы не приводим итоговую стоимость или процент экономии. Перед масштабированием проверьте актуальную страницу модели и собственные записи запросов.
Версионируйте весь комплект: текст, пять исходных WAV, измеренные времена, собранную дорожку и MP4. При следующей правке замените конкретную реплику, измерьте её и пересоберите видео. Похожее число символов не означает одинаковую длительность.
Часто задаваемые вопросы
- Голос в примере создан Opus 5.5?
- Нет. WAV-файлы созданы Gemini 3.8 Flash TTS через Ofox, а видео и звук собраны локально в FFmpeg. Opus можно использовать для редактирования проекта, но в этой статье нет нового тестового вызова Opus.
- Можно собрать видео без расходования API-кредитов?
- Да. В архиве есть пять готовых WAV и исходный MP4. Локальная сборка не обращается к API. Для генерации новых реплик нужны действующий ключ, доступ к модели и доступная квота.
- Можно ли точно подогнать реплику параметром speed?
- Точная длительность не гарантируется. Измерьте результат, при необходимости сократите текст или продлите сцену, а затем проверьте, что конец фразы не обрезан.