DeepSeek V4.1 Flash 1017 更新了什么?性能变化、API 模型名与升级检查
对照 DeepSeek V4.1 Flash 1017 与9月版的官方成绩,区分模型价格和 Search/Fetch 费用,并用具体任务检查 API 版本、工具能力与升级结果。
 Ofox
DeepSeek V4.1 Flash 1017 是10月17日推出的 V4.1 Flash 更新。官方 API 仍使用 deepseek-flash,发布说明明确表示调用方式与模型价格不变。对于已有工作流,更值得确认的是:新版能否完成原来的任务,输出、工具调用和预算是否仍符合要求。
本文面向 API 开发者和编程 Agent 用户,对照官方成绩,拆开模型与搜索工具两类费用,并提供可跟做的小型验收任务。核验日期为2026年10月19日;这是一篇基于公开文档的分析,不是独立模型测评。本文由 Ofox 发布,Ofox 也是文中讨论的接入选项之一。本轮没有进行付费模型推理。
一、1017 相比之前改了什么?
官方更新日志说明,网页和手机应用也已同步更新。DeepSeek 表示新版减少了任务运行时间和输出长度,并建议使用 DeepSeek Harness 的用户升级到 0.2.1-rc.1 或更高版本。这里分别是厂商的性能描述与客户端版本建议,不能直接当成你的工作流已经加速或省钱的证据。
官方模型卡列出了与原 V4.1 Flash 的对照,下面选取其中的编程与 Agent 评测:
| 官方评测 | 原 V4.1 Flash | 1017 | 分数变化 |
|---|---|---|---|
| Terminal-Bench 4.0 | 31.2 | 42.3 | +11.1 |
| ProgramBench | 20.3 | 29.1 | +8.8 |
| DeepSWE v1.1 | 74.2 | 77.0 | +2.8 |
| Automation-Bench v1.0.6 | 54.8 | 60.5 | +5.7 |
模型卡注明,Terminal-Bench 4.0 使用 Claude Code 框架,DeepSWE v1.1 使用 Mini-SWE-V2。这些成绩支持我们优先考察编程和 Agent 任务,但不能推导出所有客户端都有相同提升。分数增加也不等于实际业务错误率降低了同样的百分比,更不能拿这里的 Terminal-Bench 4.0 与旧评测中的其他版本直接比较。
对应用维护者,下一步应落到具体结果:同一个修复任务能否通过测试,必填字段有没有丢失,工具参数是否正确,是否减少了重试。答案变短却漏掉要求,不算效率提升;答案稍长但能一次完成任务,也可能更值得保留。
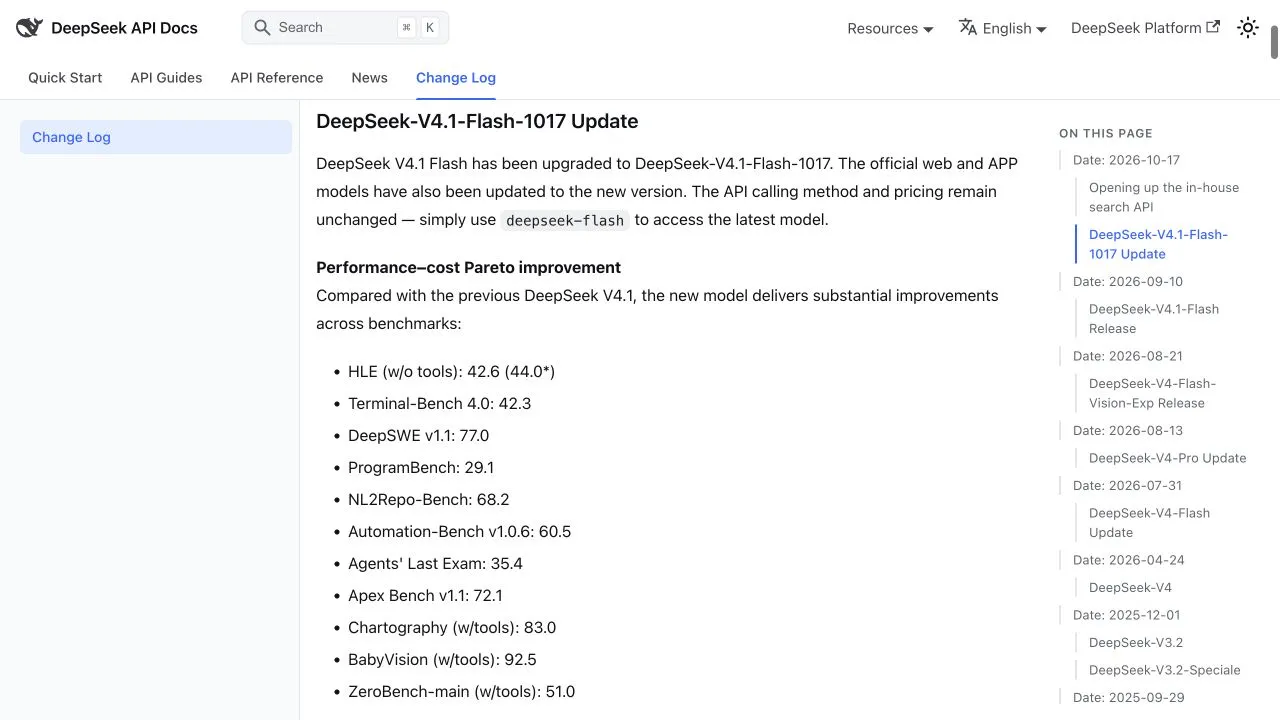
官方英文更新日志截图,截取于2026年10月19日。截图展示发布说明,不是模型调用实测。
二、API 用户需要改模型名吗?
对于 DeepSeek 官方 API,发布说明要求继续使用 deepseek-flash。也就是说,配置不变,别名背后的模型仍可能更新。同一份请求不能保证一直调用旧版本。如果历史日志只记了别名,没有可核对的模型修订信息,就不能仅凭日志断定它来自哪个检查点。
下面三个名称属于不同系统,不能混填:
| 名称 | 所属系统 | 要核对什么 |
|---|---|---|
deepseek-flash | DeepSeek 官方 API 别名 | 官方当前映射,以及客户端实际访问的端点 |
deepseek-ai/DeepSeek-V4.1-Flash-1017 | 官方 Hugging Face 仓库 | 自行部署时使用的权重修订与推理实现 |
| 第三方目录中的日期版 ID | 对应供应商的模型目录 | 可用性、实际版本、协议、工具能力与账号权限 |
不要因为两者指向同一模型家族,就把 Hugging Face 仓库名直接填进托管 API;也不要自行给官方别名加上 -1017,除非接口文档明确接受这个名称。
已有客户端先检查保存的 Base URL 和模型选择,包括子代理的默认设置,再通过请求记录确认实际发出的值。凭据测试通过或下拉框出现模型,不等于完整任务已经运行成功。具体配置可参考站内的 Claude Code 接入教程与 Codex 接入教程;本次更新不代表两种客户端的协议可以互换。
三、这次提价了吗?把模型和工具分开算
10月17日的模型发布说明明确表示模型价格不变。但它不等于 Agent 用到的所有工具都免费,也不代表第三方供应商必须采用同一价格。
同日开放的 Search 和 Fetch 是另外两类接口。根据官方 Search & Fetch 文档,Search 返回搜索结果,Fetch 将网页内容提取为 Markdown;两者标价均为每1,000次成功请求0.75美元,计费要求返回 HTTP 200,且搜索结果非空或成功提取网页内容。失败请求、空搜索结果和超时不收费。
文档另外说明,通过 DeepSeek Harness、Claude Code、Codex 使用的相关服务端工具调用目前免费,从北京时间2026年11月1日零点开始按请求计费。这个过渡安排不能扩大解释为“所有直接 API 请求到11月前都免费”。
举一个演算例子,并非实际账单:100个完成的任务,每个任务产生2次可计费 Search 和3次可计费 Fetch,共500次工具请求。按照上述费率,工具部分为 500 × 0.75 / 1,000 = 0.375美元,模型用量另算。Agent 如果重复搜索,而且每次都符合计费条件,就要分别计数。
比较升级前后的成本时,建议把模型用量、工具请求、重试和验收结果分列。用总花费除以验收通过的任务数,同时保留失败任务数,才能看到完成任务的成本。否则,一个单次便宜却反复失败的流程,可能看起来比一次成功的流程更划算。估算前使用实际供应商、实际账号适用的费率与缓存分类,不能套用另一条调用路线的价格。
四、先做什么检查,才能判断升级是否适合?
下面是本文设计的验收方法,不是 DeepSeek 的强制要求,也不是已经完成的模型测试。先用不含客户资料的合成任务,检查输出是否满足要求。
输入与指令:
只返回 JSON,且只能包含以下字段:
request_id、category、amount、currency、action。

工单编号为 REF-1017。客户因重复支付申请退回19.50美元,
尚未提供付款ID。

category 只能取 billing、technical、other。
action 只能取 request_payment_id、escalate、no_action。
request_id 填工单编号,currency 使用 ISO 币种代码。
缺少付款ID时,action 必须为 request_payment_id。
amount 必须是 JSON 数字。不要执行退款,不要编造付款ID。下面是验收目标。它是人为编写的预期结果,不是模型输出截图或实测响应。
{"request_id":"REF-1017","category":"billing","amount":19.5,"currency":"USD","action":"request_payment_id"}实际运行后先解析 JSON,再对比字段集合和值;额外解释文字、遗漏字段或虚构付款信息均不通过。这个例子只检查狭窄的信息提取任务,不能代替代码修复和工具调用测试。
如果真实工作流涉及工具,可以再加入一个只读的测试工具,返回预先确定的付款状态,检查 Agent 是否传入正确参数,并在后续结果中使用了工具返回值。测试时禁用真正的退款、邮件发送等操作,不能用“模型说已完成”代替工具执行记录。
编程场景则在隔离的仓库副本中选一个小问题,先准备能复现问题的失败测试。验收要求包括:相关测试通过,无关测试没有回归,改动仅涉及允许的文件。解释看起来正确,不等于代码已经通过运行验证。
每次运行都记录同一组信息:
| 记录项 | 用途 |
|---|---|
| 时间、端点、请求模型名与响应模型标签 | 区分路由变化与模型更新;单独一个别名不能证明检查点 |
| 客户端版本、提示词、思考参数、工具定义 | 避免把客户端或提示词变化误归因于模型 |
| 最终输出、测试结果与工具参数 | 判断任务是否正确完成 |
| 完整任务耗时、用量和可计费工具调用 | 评估整个任务,而不仅是首字出现时间 |
| 重试与全部失败尝试 | 防止成本和成功率只统计成功样本 |
要提出性能结论,需要在相同条件下重复运行。一次成功只能证明那次请求成功。如果旧检查点已经不可访问,又没有条件一致的历史记录,就只报告当前任务是否通过,不编造升级前后的对照。
五、在 Ofox 使用前,怎么核对路线?
打开 Ofox 模型目录,检查当前 DeepSeek 条目,把精确模型 ID、供应商、协议和账号适用价格与目标工作流对应起来。站内的 DeepSeek 故障与备用模型指南记录了10月19日核对过的日期版候选,也解释了目录信息能够证明什么、不能证明什么。
确认路线符合要求后,在 API Keys 创建自己的密钥,按认证文档配置。密钥放在客户端凭据存储或环境变量中,不要写进导出的工作流或截图。先完成上面的验收任务,再连接生产操作。
OpenAI 兼容的文本端点,本身不能证明包含 DeepSeek 官方 Search、Fetch 服务,工具能力需要单独核对。同样,目录中的日期版标签不能证明不同供应商有完全相同的延迟、量化方式、输出质量和可用性。本文不提供 Ofox 报价,也不宣称已实测 Ofox 调用。
六、哪些用户应该优先检查?
已经使用官方 deepseek-flash 的用户,应优先做回归验收,因为后端可能已经切到新版;使用第三方路线的用户,应先确认实际版本与能力,再改配置;依赖搜索工具的用户,需要单独估算工具账单及适用的开始计费时间。
1017 的官方对照成绩使编程和 Agent 任务值得优先评估,但是否保留在工作流中,仍要看输出有效、工具执行完成、任务成本可接受,以及失败时有明确处理路径。遇到持续报错,按API 排查与备用切换步骤定位,不要把每次失败都归因于模型能力退步。