DeepSeek V4.1 Flash 1017の変更点と、アップデート後に確認したいこと
DeepSeek V4.1 Flash 1017と9月版の違いを公式資料で比較。モデル料金とSearch・Fetchの課金を区別し、APIの接続先と既存ワークフローを確認する手順を解説します。
 Ofox
DeepSeek V4.1 Flash 1017は、10月17日に公開されたV4.1 Flashの更新版です。 公式APIのモデル名は引き続きdeepseek-flashで、リリース告知では呼び出し方法とモデル料金は変わらないとしています。既存ユーザーが確かめたいのは、出力形式、ツール、予算への影響を抑えながら、これまでのタスクをより適切に処理できるかという点です。
本記事は、更新後の確認項目を知りたいAPI開発者やコーディングエージェントの利用者向けです。公開された評価結果を比較し、モデル料金と検索ツール料金を整理したうえで、小さな動作確認の課題を示します。2026年10月19日時点の公式資料に基づく解説であり、独自のモデル性能検証ではありません。 記事を公開するOfoxも、本文で紹介する接続先の一つです。本記事のための有料推論は実行していません。
1017では何が変わったのか
公式更新履歴によると、APIと同時にWeb版とモバイルアプリも更新されました。DeepSeekはタスク実行時間と出力が短くなったと説明し、新モデルにはDeepSeek Harness 0.2.1-rc.1以降を推奨しています。これらは提供元の発表とクライアントの推奨バージョンです。利用者の処理で実測した速度や、費用削減を保証するものではありません。
公式モデルカードには、従来のV4.1 Flashとの比較が掲載されています。以下は、そのうちコーディングとエージェントに関する評価の一部です。
| 公開ベンチマーク | 従来のV4.1 Flash | 1017 | スコア差 |
|---|---|---|---|
| Terminal-Bench 4.0 | 31.2 | 42.3 | +11.1 |
| ProgramBench | 20.3 | 29.1 | +8.8 |
| DeepSWE v1.1 | 74.2 | 77.0 | +2.8 |
| Automation-Bench v1.0.6 | 54.8 | 60.5 | +5.7 |
モデルカードでは、Terminal-Bench 4.0の実行環境にClaude Code、DeepSWE v1.1にMini-SWE-V2を使ったと記載されています。これらの結果はコーディングやエージェント用途で試す理由になりますが、どのクライアントでも同じように改善することを示すものではありません。スコア差は、自分の処理におけるエラー率の低下率でもありません。また、ここに示すTerminal-Bench 4.0を、古いレビューに載っている別バージョンの結果と直接比較しないでください。
アプリケーションの運用では、同じ修正を完了できるか、必須フィールドを保持できるか、正しいツールを少ない試行で呼び出せるかを確認します。必要な内容を省いた短い回答は、効率の改善とはいえません。反対に、もう一度処理をやり直さずに済むなら、長くても正しい回答のほうが適している場合があります。
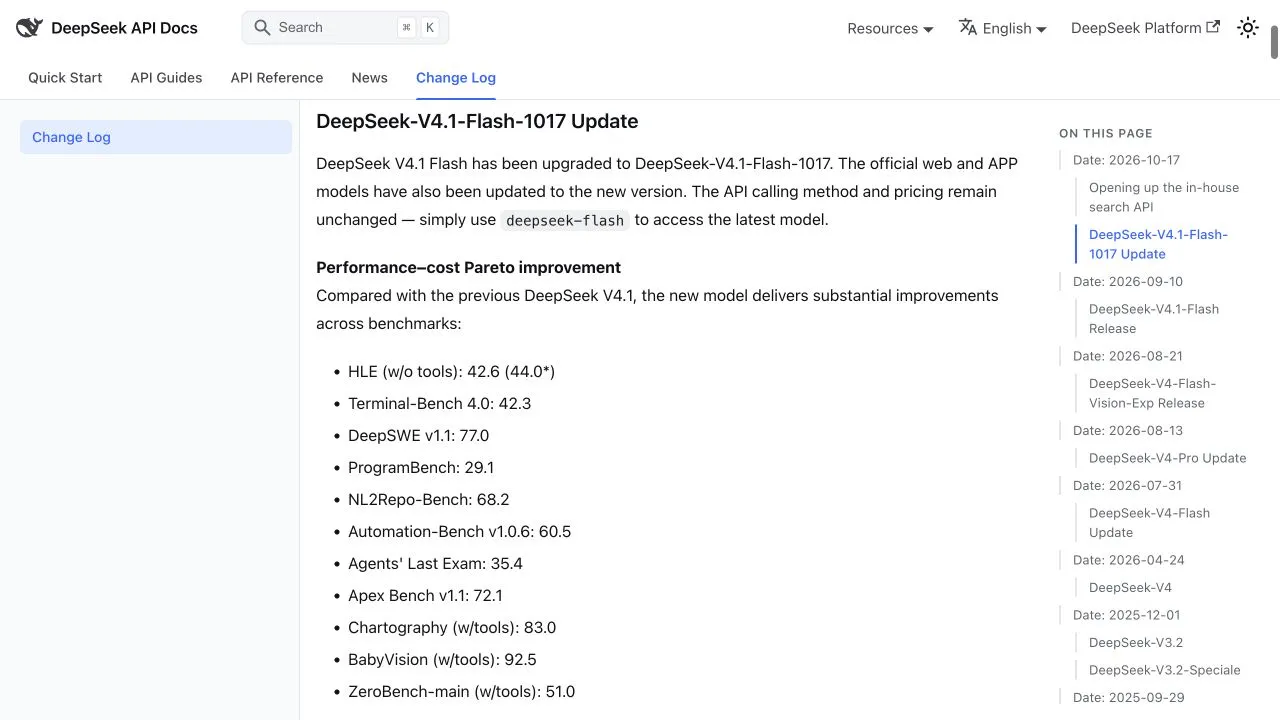
2026年10月19日に取得した公式更新履歴の英語画面です。リリース告知を確認するための資料であり、推論テストの結果ではありません。
モデル名の変更は必要か
DeepSeek公式APIの更新告知では、引き続きdeepseek-flashを使うよう案内しています。そのため、設定を変えなくても、同じエイリアスが新しいモデルを指すことがあります。同じリクエストを使い続けても、旧版の比較基準を維持できるとは限りません。 モデルのリビジョンを日付などで特定できない過去のログだけでは、どのチェックポイントがその結果を生成したかは証明できません。
似た名前でも、それぞれが使われる場所は異なります。
| 名前 | 使用する場所 | 確認すること |
|---|---|---|
deepseek-flash | DeepSeek公式APIのエイリアス | 現在の公式な対応先と、クライアントが実際に呼び出すエンドポイント |
deepseek-ai/DeepSeek-V4.1-Flash-1017 | 公式Hugging Faceリポジトリ | 自前で配備する場合の重みのリビジョンと推論サーバーの実装 |
| プロバイダー独自の日付付きID | 外部プロバイダーのカタログ | 提供状況、実際のモデル版、プロトコル、ツール、アカウントの利用権限 |
同じモデル系列だからといって、Hugging Faceのリポジトリ名をホスト型APIのモデル名にそのまま入れないでください。また、利用可能だとドキュメントで確認できない限り、公式APIのエイリアスに自分で-1017を付けることも避けます。
既存クライアントでは、保存済みのBase URLとモデル設定を確認します。サブエージェントのデフォルト設定も対象です。そのうえでリクエスト記録を調べ、実際にその値が送られているかを確かめてください。接続テストの成功やモデル選択欄への表示は、タスクの完了を意味しません。クライアントごとの設定は、Claude Code設定ガイドとCodex設定ガイドで説明しています。今回の更新によって、両者のプロトコルを相互に置き換えられるようになったわけではありません。
値上げされたのか:モデルとツールの料金を分ける
10月17日のリリースでは、モデル料金は変わらないとしています。これはエージェントが使うすべてのツールが無料だという意味ではなく、外部プロバイダーの料金を示すものでもありません。
DeepSeekはSearch APIとFetch APIも公開しました。Search & Fetchガイドによると、Searchは検索結果を返し、FetchはページをMarkdownとして取得します。いずれも、HTTP 200と空ではない検索結果または取得したページ内容が返る成功リクエストについて、1,000回あたり0.75米ドルと記載されています。失敗したリクエスト、検索結果が空のリクエスト、タイムアウトには課金されません。DeepSeek Harness、Claude Code、Codexを通じたサーバー側のツール呼び出しについては、北京時間2026年11月1日午前0時に課金を開始し、それまでは無料と案内されています。この移行期間の説明を、すべての直接APIリクエストが11月まで無料だという意味に広げてはいけません。
次は計算例であり、実際の請求額ではありません。完了したタスクが100件あり、1件ごとに課金対象のSearchを2回、Fetchを3回使う場合、ツールのリクエストは計500回です。記載の単価なら、ツール部分の料金は500 × $0.75 / 1,000 = $0.375となります。モデルの利用料金は別途加えます。同じ検索を繰り返し、それぞれが課金対象になる場合は、すべてのリクエストを数えてください。
比較表では、モデル利用量、ツールのリクエスト数、再試行、合格したタスク数を分けて記録すると便利です。総費用を合格したタスク数で割るとともに、不合格のタスク数も残します。そうしないと、何度も失敗する安い処理が、一度で成功するやや高い処理より有利に見えることがあります。予算を見積もる前に、別の接続先から転載した単価ではなく、実際のプロバイダーとアカウントの料金、キャッシュの課金区分を確認してください。
既存ユーザーが最初に確認すること
以下は本記事で提案する検証方法であり、DeepSeekの必須要件や実施済みのテストではありません。顧客データを共有せずに正しさを確認できるよう、小さな架空の課題を使います。
入力と指示:
次のキーだけを持つJSONを返してください。
request_id, category, amount, currency, action.

問い合わせ番号:REF-1017。顧客は二重払いについて、
19.50米ドルの返金を求めています。支払いIDは提示されていません。

categoryに使える値:billing, technical, other。
actionに使える値:request_payment_id, escalate, no_action。
問い合わせ番号をrequest_id、ISO通貨コードをcurrencyに使ってください。
支払いIDがない場合、actionはrequest_payment_idにしてください。
amountにはJSONの数値を使ってください。返金を実行したり、IDを捏造したりしないでください。合格条件となるJSONオブジェクトは次のとおりです。これは筆者が定義した期待結果であり、モデルから取得した応答ではありません。
{"request_id":"REF-1017","category":"billing","amount":19.5,"currency":"USD","action":"request_payment_id"}出力をJSONとしてパースし、キーの集合と値が完全に一致するかを確認します。余分な説明文や、存在しない支払い情報が含まれる場合は不合格です。この課題が確認できるのは限定的な情報抽出だけで、リポジトリの修正やツール利用は検証できません。実際のワークフローがツールを使う場合は、既知の支払い状況を返す読み取り専用のテスト用ツールを追加します。エージェントが正しい引数を渡し、返された結果を回答に反映するかを確認してください。この確認中は、返金やメール送信の処理を無効にしておきます。
コーディングでは、隔離したリポジトリのコピーで、あらかじめ失敗するテストがある小さな不具合を扱います。該当テストが通ること、無関係なテストも引き続き通ること、差分が許可したファイルの範囲に収まることを合格条件にします。もっともらしい説明を、実行済みのテストの代わりにしないでください。
各試行で、同じ項目を記録します。
| 記録する項目 | 確認できること |
|---|---|
| 時刻、エンドポイント、要求したモデル、応答に含まれるモデル名 | 接続先の変更とモデル更新を区別する手がかりになる。ただし、エイリアスだけではチェックポイントを特定できない |
| クライアントのバージョン、プロンプト、推論設定、ツール定義 | クライアントや指示の変更による影響を、モデルの変化と取り違えるのを防ぐ |
| 最終出力、テスト結果、ツールの引数 | タスクを正しく完了できたかを確認する |
| 処理全体の所要時間、利用量、課金対象のツール呼び出し | 最初のトークンまでの時間だけでなく、タスク全体を評価する |
| 再試行とすべての失敗した試行 | 費用と信頼性の比較から失敗を除外しない |
性能について結論を出す前に、同じ設定で繰り返し試してください。1回の成功から分かるのは、そのリクエストが成功したことだけです。旧チェックポイントを使えず、条件のそろった過去の記録もない場合は、現在の検証結果として報告します。更新前後の比較を作り上げてはいけません。
Ofox経由で使う場合の確認方法
まずOfoxモデル一覧で、現在のDeepSeekの掲載内容を確認します。正確なモデルID、プロバイダー、対応プロトコル、アカウントに適用される料金が、予定しているワークフローに合うかを調べてください。DeepSeekの障害対応・代替モデル切り替えガイドでは、10月19日に記録した日付付きの候補モデルと、カタログだけでは確認できない点を説明しています。
条件を満たす接続先であれば、API Keysで自分のキーを作成し、認証ドキュメント(英語)に沿って設定します。キーはクライアントの認証情報ストアや環境変数に保存し、エクスポートしたワークフローやスクリーンショットには含めないでください。本番の処理につなぐ前に、検証用のタスクを完了させます。
OpenAI互換のテキスト用エンドポイントがあるだけでは、DeepSeek公式のSearch・Fetchサービスも使えるとは限りません。ツールへの対応は別途確認が必要です。同様に、カタログの日付付き名称は、プロバイダー間で遅延、量子化、出力品質、稼働率が同じであることを証明しません。本記事ではOfoxの料金を引用しておらず、Ofox経由の呼び出しを実測したとも主張していません。
アップデート後の判断基準
すでに公式のdeepseek-flashエイリアスを使っている場合は、既存機能が正常に動くかの確認を優先します。サービス側では、すでに更新版が使われている可能性があるためです。外部プロバイダー経由で使う場合は、設定を変更する前に、実際のモデル版と対応機能を確認します。検索ツールに依存している場合は、ツール料金を別枠で見積もり、その利用方法に適用される課金開始日も確認してください。
公式比較で改善が示されていることから、1017はコーディングやエージェントのタスクで検証する価値があります。ワークフローで使い続けるかどうかは、出力の正しさ、ツール処理の完了、合格したタスクあたりの費用、実行可能な障害対応手順を基準に判断します。エラーが繰り返される場合は、すべてをモデル品質の低下と捉えるのではなく、APIの診断・代替モデル切り替え手順に沿って切り分けてください。