다중 턴 도구 호출에 DeepSeek, Gemini, Qwen 중 무엇을 쓸까? 소규모 재현 테스트
DeepSeek, Gemini, Qwen으로 도구 호출 전체 흐름을 테스트하고 오류를 한 번 주입했습니다. 실제 출력, 재시도 동작, 토큰 사용량, JSON 검증 결과를 비교합니다.
 Ofox
DeepSeek V4.1 Flash, Gemini 3.8 Flash, Qwen3.8 Flash는 모두 합성 주문 조회를 완료했고, 재시도 가능한 도구 오류를 한 번 주입한 뒤에도 복구했습니다. 유용한 출발점이 되는 결과지만, 안정성 면에서 우위에 있는 모델을 가려내지는 못했습니다. 각 모델은 사례별로 한 번씩 실행됐으며, 최종 응답은 모두 순수 JSON이 아니라 Markdown 코드 펜스를 포함했습니다.
따라서 실제 선택을 하려면 애플리케이션의 계약을 기준으로 도구 호출 전체 흐름을 검증해야 합니다. 인수가 올바른지, 도구 결과가 정확히 연결되는지, 재시도 횟수가 제한되는지, 최종 답변이 허용 기준을 충족하는지, 사용량이 기록되는지를 확인하세요. 모델이 도구 호출을 반환하는 것은 그 흐름의 시작일 뿐입니다.
이 글에서는 작업, 관찰 결과, 실행 가능한 테스트 키트를 소개합니다. DeepSeek, Gemini, Qwen 일반 비교에 범위가 좁은 실제 API 테스트 근거를 더합니다. 주문 데이터와 오류는 인위적으로 만들었지만, 모델 요청은 실제로 전송했습니다.
정확한 워크플로
사용자가 주문 A17을 조회해 달라고 요청합니다. 사용할 수 있는 도구는 lookup_order 하나뿐이며, 문자열 order_id를 받습니다. 로컬 함수는 민감하지 않은 고정 레코드를 반환합니다.
{"order_id":"A17","status":"shipped","amount_eur":42,"next_action":"track_delivery"}정상 사례에서는 첫 번째 호출이 성공합니다. 오류 사례에서는 첫 번째 도구 결과를 다음과 같이 바꿉니다.
{"error":"temporarily_unavailable","retryable":true}다음의 유효한 조회에서는 주문 정보가 반환됩니다. 이는 애플리케이션 수준의 도구 오류이지, HTTP 429나 제공업체 서비스 중단을 시뮬레이션한 것이 아닙니다. 이 차이를 분명히 해야 여기서 재시도에 성공한 결과를 모델 서비스의 장애 복구 근거로 잘못 홍보하지 않을 수 있습니다.
프롬프트는 모델에 도구를 사용하고, 추측하지 않으며, 재시도 가능한 오류가 발생하면 정확히 한 번 재시도한 뒤, 이름이 지정된 필드 네 개를 포함한 JSON을 반환하라고 요청합니다. 테스트 하네스는 사례당 모델 요청을 최대 네 번 허용합니다. 신용카드 결제, 메시지 전송, 주문 변경을 할 수 있는 도구는 제공하지 않습니다.
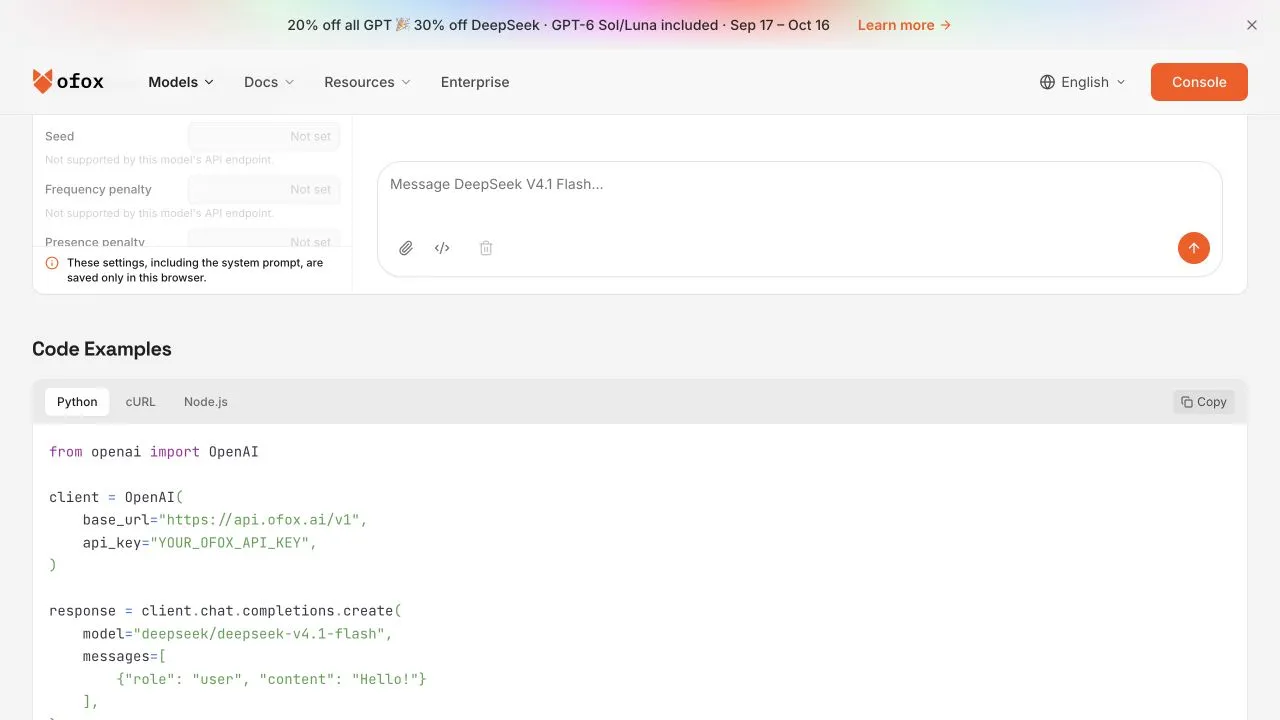
10월 12일에 캡처한 실제 모델 페이지의 코드 인터페이스입니다. 기본 연결 예시이며, 다중 턴 평가 화면은 아닙니다.
전송한 내용과 측정 항목
세 모델 모두 Ofox의 /v1/chat/completions 경로와 max_tokens: 1800을 사용했습니다. 네임스페이스가 포함된 정확한 ID는 다음과 같습니다.
deepseek/deepseek-v4.1-flash
google/gemini-3.8-flash
qwen/qwen3.8-flash
명시적인 temperature나 추론 설정은 지정하지 않았습니다. 이 테스트는 게이트웨이의 현재 기본값을 사용하므로, 추론 예산을 동일하게 맞춘 비교가 아닙니다. 제공업체의 기본 네이티브 엔드포인트도 테스트하지 않았습니다.
| 모델 | 정상 사례: 도구 호출 수 / 요청 시간 합계 | 재시도 사례: 도구 호출 수 / 요청 시간 합계 | 보고된 총 토큰 수, 정상 / 재시도 |
|---|---|---|---|
| DeepSeek V4.1 Flash | 1 / 3.14 s | 2 / 5.03 s | 899 / 1,474 |
| Gemini 3.8 Flash | 1 / 4.52 s | 2 / 6.40 s | 532 / 945 |
| Qwen3.8 Flash | 1 / 3.36 s | 2 / 4.35 s | 1,008 / 1,527 |
시간은 각 워크플로에서 클라이언트가 관찰한 모델 요청 시간을 합산한 값입니다. 지연 시간 백분위나 순수 모델 추론 시간은 아닙니다. 토큰 총계는 반복된 대화 기록을 포함해 각 턴의 API 사용량을 합한 값입니다. 토크나이저와 집계 방식이 다를 수 있으므로, 보고된 토큰 수가 적다고 해서 반드시 작업량이 적거나 비용이 낮은 것은 아닙니다.
완료된 테스트를 실행하기 전, 최초 DeepSeek 시도에서 전송 계층의 프록시 연결이 끊기는 문제가 발생했습니다. 이 시도는 별도로 기록했으며 표에서는 제외했습니다. 이 제외를 실패가 전혀 없었다는 가용성 결과로 오해해서는 안 됩니다. 표는 준비 과정에서 이루어진 모든 네트워크 시도가 아니라 완료된 사례를 설명합니다.
통과한 항목과 통과하지 못한 항목
완료된 정상 사례는 각각 유효한 조회를 한 번 수행했습니다. 완료된 오류 사례는 각각 유효한 조회를 두 번 수행해 처음 주입한 오류에서 복구했습니다. 최종 답변에는 모두 예상한 주문 값이 포함됐습니다. 성공적인 결과를 받기 전에 주문 상태를 지어낸 모델은 없었습니다.
하지만 답변 여섯 개 모두 Markdown 코드 펜스로 감싸져 있었습니다. DeepSeek의 재시도 사례에서는 재시도 이유를 설명하는 문장도 덧붙였습니다. 애플리케이션에서 응답 텍스트 전체를 하나의 JSON 값으로 파싱해야 한다면, 값이 정확하더라도 이 출력은 엄격한 계약을 충족하지 못합니다.
자동화에 사용할 모델을 고를 때 이 점이 중요합니다. 사람이 보는 고객 지원 도우미라면 코드 펜스로 감싼 답변도 괜찮을 수 있습니다. JSON 객체를 기대하는 백그라운드 작업자는 그렇지 않을 수 있습니다. 측정하기 전에 허용 기준을 정하고 의미상 정확성, 구문, 도구 동작을 각각 별도 항목으로 기록하세요.
| 허용 기준 확인 항목 | 완료된 사례에서 관찰한 결과 |
|---|---|
| 허용된 도구와 올바른 주문 ID 사용 | 여섯 사례 모두 통과 |
| 오류 주입 후 조회를 정확히 한 번 추가 수행 | 오류 사례 세 건 모두 통과 |
| 최종 답변에 예상한 주문 값 포함 | 여섯 사례 모두 포함 |
| 코드 펜스나 설명 없이 순수 JSON 반환 | 여섯 사례 모두 실패 |
| 전반적인 프로덕션 안정성 | 측정하지 않음 |
턴 사이에 assistant 메시지 보존하기
하네스는 반환된 assistant 메시지 뒤에 도구 결과를 추가합니다. 마지막으로 화면에 표시된 텍스트만으로 대화 기록을 재구성하지 마세요. 다음 턴에 도구 호출 ID와 제공업체별 이어쓰기 필드가 필요할 수 있습니다. 이 게이트웨이 테스트에서는 이어쓰기 메타데이터가 있었고 다음 요청에도 보존했습니다.
핵심 순서는 다음과 같습니다.
message = response["choices"][0]["message"]
messages.append(message)

for call in message.get("tool_calls", []):
    # Validate name and arguments before executing any application action.
    result = lookup_validated_order(call)
    messages.append({
        "role": "tool",
        "tool_call_id": call["id"],
        "content": json.dumps(result),
})lookup_validated_order는 모델이 반환한 이름을 임의로 실행하는 것이 아니라, 애플리케이션의 검증 경계를 나타냅니다. 다운로드 가능한 구현은 lookup_order만 허용하며 인수는 정확히 {"order_id":"A17"}이어야 합니다. 프로덕션 구현에서는 요청된 레코드에 대해 인증된 사용자가 권한을 갖고 있는지도 확인해야 합니다.
제공업체 네이티브 방식으로 연동할 때는 이 OpenAI 호환 표현을 무작정 복사하지 말고, 해당 업체의 메시지 및 도구 결과 계약을 따르세요. DeepSeek 도구 호출 가이드와 Gemini 함수 호출 문서에서 각각 다른 인터페이스를 설명합니다. 이 게이트웨이 테스트를 통과했다고 해서 실행해 보지 않은 네이티브 어댑터까지 검증된 것은 아닙니다.
테스트를 재현한 뒤 범위 넓히기
테스트 키트를 다운로드해 압축을 풀고 스크립트를 확인한 다음, 격리된 Python 환경에 requests를 설치하세요. 평소 사용하는 시크릿 관리 방식으로 OFOX_API_KEY를 설정하세요. 스크립트는 요금이 부과되는 모델 요청을 전송하며, 무료 크레딧이 있다고 가정하지 않습니다.
도구 테스트 모음을 실행하고 결과를 새 디렉터리에 저장하세요.
python3 -m venv .venv
source .venv/bin/activate
python -m pip install requests
python tool_suite.py --output ./tool-results
스크립트는 설정된 턴 제한에 도달하면 각 사례를 중단하고 HTTP 또는 전송 오류를 기록하며 실패한 사례도 보존합니다. HTTP 200을 애플리케이션 테스트 통과로 간주하지 말고 응답 텍스트를 읽고 구조를 검증하세요. 결과를 공유할 때 원시 이어쓰기 메타데이터나 인증 정보를 공개하지 마세요. 제공된 근거 자료에서는 추론 필드를 제거했습니다.
그다음 단일 픽스처를 자체 라벨링 사례로 바꾸세요. 존재하지 않는 주문, 누락된 인수, 여러 도구 호출, 잘못된 JSON 인수, 재시도할 수 없는 오류, 시간 초과 도구를 추가하세요. 프로토콜을 정립하는 동안에는 읽기 전용 도구를 사용하세요. 부작용을 일으키는 도구에는 멱등성이나 명시적 권한 부여 같은 추가 통제가 필요합니다. 재시도 지시만으로 안전성이 보장되지는 않습니다.
허용 기준을 충족한 작업으로 선택하기
소규모 연동 시험에서는 세 모델 모두 이번 특정 흐름을 완료했으므로 후보로 고려할 만합니다. 관찰한 시간 순서는 변동성이 커서 프로덕션 순위로 삼기 어렵습니다. 애플리케이션에서 사용할 입력 길이, 동시성, 추론 설정으로 작업을 반복하세요.
허용 기준을 충족한 작업의 비율, 전체 지연 시간, 요청 횟수, 사용 기록과 대조한 지출을 기록하세요. 최초 시도 실패, 형식 수정 재시도, 대체 처리에 드는 비용도 작업 비용에 포함하세요. 저렴하지만 유효하지 않은 결과가 겉보기 성공률을 높이지 않도록 사용자에게 보이는 정확성은 별도로 측정하세요.
배포 전에 애플리케이션에서 최대 턴 수와 도구별 재시도 제한을 강제하세요. 모델은 이번 테스트에서 한 번만 재시도하라는 지시를 따랐지만, 서비스가 언제나 그렇게 동작하리라고 기대해서는 안 됩니다. 제공업체 오류, 도구 오류, 출력 검증 실패를 구분하세요. 각각 필요한 대응이 다릅니다.
다음 과제가 도구 호출 흐름이 아니라 구조화된 추출이라면, Haiku 마이그레이션 평가에서도 구문, 구조, 사실을 별도로 검증해야 하는 이유를 확인할 수 있습니다.
자주 묻는 질문
- 도구 호출에 가장 안정적인 모델은 무엇인가요?
- 이 6개 사례로는 판단할 수 없습니다. 세 모델 모두 정상 워크플로와 오류를 주입한 워크플로를 각각 한 번 완료했습니다. 안정성 면에서 우위에 있는 모델을 고르기 전에 대표성 있는 라벨링 데이터로 테스트하고 실패 사례를 보고하세요.
- 제공업체의 요청 제한 복구도 테스트했나요?
- 아니요. 주입한 오류는 로컬 합성 주문 도구에서 발생했습니다. 제공업체의 HTTP 오류나 요청 제한, 서비스 중단은 아니었습니다.
- 모델이 요청하는 도구를 무엇이든 실행해도 되나요?
- 아니요. 도구 이름을 허용 목록으로 제한하고, 인수를 검증하며, 실행 전에 레코드에 대한 권한을 확인하세요. 이 테스트 픽스처는 합성 주문 한 건만 읽을 수 있으며 외부 작업은 수행할 수 없습니다.