DeepSeek, Gemini или Qwen: небольшой тест многошаговой работы с инструментами
Сравниваем DeepSeek, Gemini и Qwen на полном цикле вызова инструмента с одной искусственно созданной ошибкой: ответы, повторы, токены и проверка JSON.
 Ofox
DeepSeek V4.1 Flash, Gemini 3.8 Flash и Qwen3.8 Flash выполнили поиск синтетического заказа и восстановились после одной искусственно созданной ошибки инструмента, допускающей повтор запроса. Это полезный исходный результат, но он не позволяет выбрать самую надёжную модель. Каждая модель запускалась для каждого случая один раз, и все итоговые ответы были обрамлены Markdown-блоками кода, а не представляли собой чистый JSON.
Поэтому на практике выбирать нужно, проверив полный цикл работы с инструментами на требованиях вашего приложения: правильность аргументов, соответствие результатов вызовам инструментов, ограничение числа повторов, приемлемость итогового ответа и фиксацию использования. Ответ модели с вызовом инструмента — лишь начало этого цикла.
В статье приведены задача, наблюдаемые результаты и набор инструментов для запуска теста. Она дополняет общее сравнение DeepSeek, Gemini и Qwen реальными API-данными с узкой областью применимости. Данные о заказе и ошибка были искусственными; запросы к моделям — реальными.
Точный сценарий
Пользователь запрашивает заказ A17. Доступен только один инструмент — lookup_order, который принимает строковый параметр order_id. Наша локальная функция возвращает фиксированную запись, не содержащую конфиденциальных данных:
{"order_id":"A17","status":"shipped","amount_eur":42,"next_action":"track_delivery"}В обычном сценарии первый вызов выполняется успешно. В сценарии со сбоем вместо этого возвращается такой результат первого вызова инструмента:
{"error":"temporarily_unavailable","retryable":true}Следующий корректный запрос возвращает заказ. Это ошибка инструмента на уровне приложения, а не смоделированный HTTP 429 и не сбой провайдера. Если не проводить это различие, успешный повтор здесь можно ошибочно представить как доказательство того, что сервис модели восстанавливается после сбоев.
В запросе мы просим модель воспользоваться инструментом, не делать предположений, ровно один раз повторить запрос после ошибки, допускающей повтор, и вернуть JSON с четырьмя полями с заданными именами. Тестовая обвязка разрешает не более четырёх запросов к модели на один сценарий. В её распоряжении нет инструментов для списания средств с карты, отправки сообщений или изменения заказа.
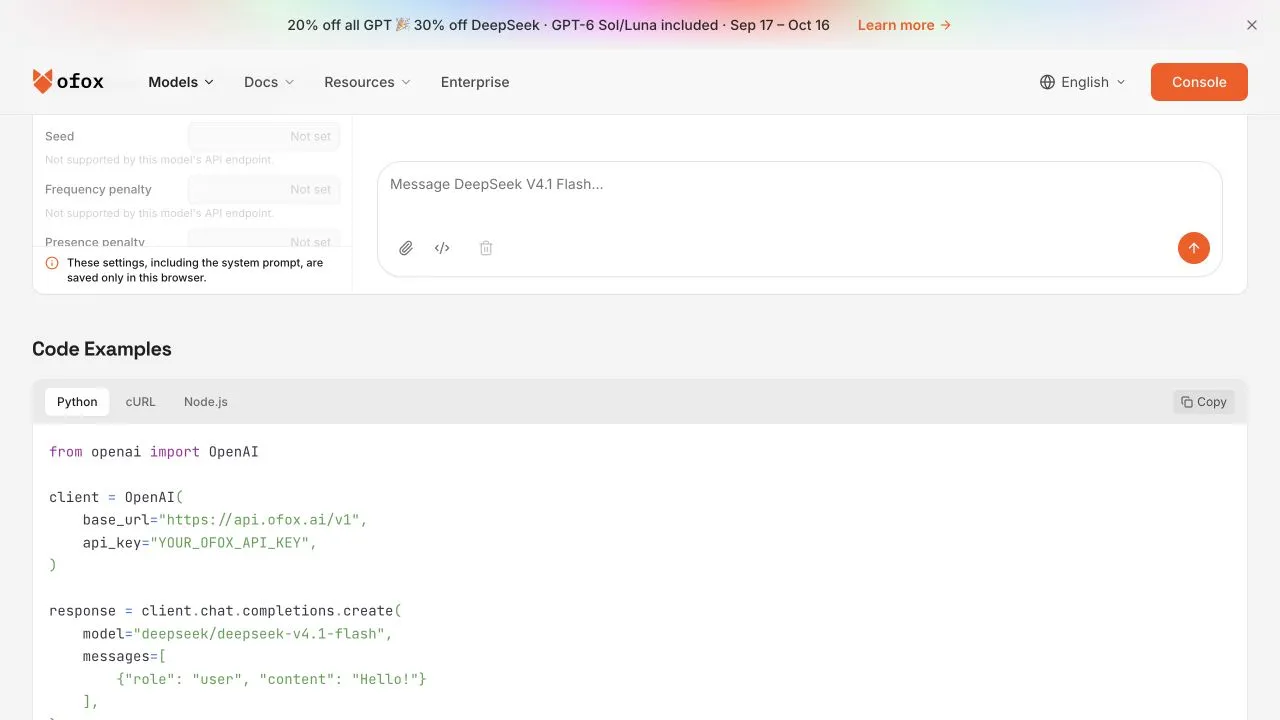
Скриншот интерфейса со страницей модели и кодом, сделанный 12 октября. Это базовый пример подключения, а не снимок экрана с многошаговой оценки.
Что мы отправляли и измеряли
Для всех трёх моделей использовался маршрут Ofox /v1/chat/completions с параметром max_tokens: 1800. Мы указали точные имена с пространством имён:
deepseek/deepseek-v4.1-flash
google/gemini-3.8-flash
qwen/qwen3.8-flash
Параметры температуры и рассуждений явно не задавались. Таким образом проверяются текущие настройки по умолчанию шлюза; это не контролируемое сравнение при одинаковом бюджете рассуждений. Нативные конечные точки провайдеров напрямую также не тестировались.
| Модель | Обычный сценарий: вызовы инструментов / суммарное время запросов | Сценарий с повтором: вызовы инструментов / суммарное время запросов | Всего токенов по данным API, обычный сценарий / сценарий с повтором |
|---|---|---|---|
| DeepSeek V4.1 Flash | 1 / 3,14 с | 2 / 5,03 с | 899 / 1 474 |
| Gemini 3.8 Flash | 1 / 4,52 с | 2 / 6,40 с | 532 / 945 |
| Qwen3.8 Flash | 1 / 3,36 с | 2 / 4,35 с | 1 008 / 1 527 |
Время — это сумма длительностей запросов к модели в каждом сценарии, измеренных на стороне клиента. Это не перцентиль задержки и не чистое время инференса модели. Общее число токенов складывается из данных API по всем ходам, включая повторно переданную историю. Из-за различий в токенизаторах и учёте меньшее число заявленных токенов не обязательно означает меньше выполненной работы или меньший счёт.
Во время первоначальной попытки с DeepSeek произошёл обрыв соединения с прокси на транспортном уровне, до запуска завершённого набора тестов. Этот случай записан отдельно и в таблицу не включён. Такое исключение нельзя принимать за результат, свидетельствующий об отсутствии сбоев доступности. В таблице представлены завершённые сценарии, а не все сетевые попытки, предпринятые в ходе подготовки.
Что прошло проверку, а что нет
В каждом завершённом обычном сценарии был выполнен один корректный запрос к инструменту. В каждом завершённом сценарии со сбоем таких запросов было два, что позволило восстановиться после первой искусственно созданной ошибки. Все итоговые ответы содержали ожидаемые сведения о заказе. Ни одна модель не выдумала статус заказа до получения успешного результата.
При этом все шесть ответов были обрамлены блоками Markdown. В ответе DeepSeek для сценария с повтором вдобавок было предложение с пояснением, почему запрос повторили. Если приложению нужно разобрать весь текст как одно значение JSON, эти ответы не соответствуют строгому формату, хотя содержат правильные данные.
При выборе модели для автоматизации это важно. Ассистент службы поддержки, рассчитанный на общение с человеком, может допускать ответ в блоке Markdown. Фоновый процесс, ожидающий объект JSON, — нет. До измерений определите критерии приёмки и отдельно учитывайте смысловую корректность, синтаксис и поведение при вызове инструментов.
| Проверка приёмки | Результаты завершённых сценариев |
|---|---|
| Разрешённый инструмент и правильный идентификатор заказа | Пройдено во всех шести сценариях |
| Ровно один дополнительный запрос после искусственно созданной ошибки | Пройдено во всех трёх сценариях со сбоем |
| Ожидаемые сведения о заказе в итоговом ответе | Есть во всех шести сценариях |
| Чистый JSON без блока кода и дополнительного текста | Не пройдено во всех шести сценариях |
| Общая надёжность в промышленной среде | Не измерялась |
Сохраняйте сообщение ассистента между ходами
Тестовая обвязка добавляет возвращённое сообщение ассистента в историю, прежде чем добавить результат каждого вызова инструмента. Не пересобирайте историю только по последнему видимому тексту: для следующего хода могут понадобиться идентификаторы вызовов инструментов и дополнительные поля продолжения, специфичные для провайдера. В этом тесте шлюза метаданные для продолжения присутствовали, и мы сохранили их в следующем запросе.
Основная последовательность выглядит так:
message = response["choices"][0]["message"]
messages.append(message)

for call in message.get("tool_calls", []):
    # Validate name and arguments before executing any application action.
    result = lookup_validated_order(call)
    messages.append({
        "role": "tool",
        "tool_call_id": call["id"],
        "content": json.dumps(result),
    })
lookup_validated_order обозначает границу валидации приложения, а не произвольное выполнение инструмента, имя которого вернула модель. В предоставленной реализации теста разрешён только lookup_order с аргументом {"order_id":"A17"}. В промышленной реализации также следует проверять, есть ли у аутентифицированного пользователя право доступа к запрошенной записи.
При нативной интеграции с провайдером используйте его собственный формат сообщений и результатов инструментов, а не копируйте без проверки это представление, совместимое с OpenAI. В руководстве DeepSeek по вызову инструментов и документации Gemini по вызову функций описаны отдельные интерфейсы. Успешное прохождение этого теста не подтверждает работу нативного адаптера, который вы не запускали.
Сначала повторите тест, затем расширяйте его
Скачайте и распакуйте набор для тестирования, проверьте скрипт и установите requests в изолированном окружении Python. Задайте OFOX_API_KEY обычным для вас способом управления секретами. Скрипт выполняет платные запросы к моделям; предположение о наличии бесплатных кредитов не заложено.
Запустите набор тестов с инструментами и сохраните результаты в новую директорию:
python3 -m venv .venv
source .venv/bin/activate
python -m pip install requests
python tool_suite.py --output ./tool-results
Скрипт останавливает каждый сценарий по достижении заданного предела ходов, записывает HTTP-ошибки и транспортные сбои, а также сохраняет результаты неудачных сценариев. Изучайте текст ответа и проверяйте его структуру, а не считайте HTTP 200 успешным результатом на уровне приложения. Не публикуйте необработанные метаданные продолжения или учётные данные, когда делитесь результатами; в предоставленных данных поля рассуждений удалены.
Затем замените единственный тестовый пример собственными размеченными сценариями. Добавьте неизвестные заказы, отсутствующие аргументы, несколько вызовов инструментов, некорректные аргументы JSON, ошибку, не допускающую повтора, и инструмент с тайм-аутом. Пока отрабатываете протокол, используйте инструменты только для чтения. Инструменты с побочными эффектами требуют дополнительных мер, например идемпотентности и явной авторизации: одной инструкции повторить запрос недостаточно, чтобы сделать их безопасными.
Выбирайте по объёму принятой работы
Для небольшого пробного внедрения все три модели — разумные кандидаты: каждая завершила именно этот цикл. Наблюдаемый порядок по времени слишком ненадёжен, чтобы делать из него рейтинг для промышленного применения. Повторите тесты на длинах входных данных, при параллельной нагрузке и с настройками рассуждений, которые будут использоваться в вашем приложении.
Записывайте долю принятых задач, сквозную задержку, число запросов и сверенные расходы. Включайте в стоимость задачи первоначальные неудачные попытки, попытки исправить формат и переходы на запасной вариант. Отдельно измеряйте корректность результатов с точки зрения пользователя, чтобы дешёвые, но недействительные ответы не завышали кажущийся процент успеха.
Перед развёртыванием задайте в приложении максимальное число ходов и ограничение на повторы для каждого инструмента. В нашем тесте модель выполнила инструкцию повторить запрос один раз, но сервис не должен полагаться на то, что она всегда будет её выполнять. Разделяйте ошибки провайдера, ошибки инструмента и ошибки проверки формата ответа: для каждого типа нужен свой способ обработки.
Если следующая задача — структурированное извлечение данных, а не цикл работы с инструментами, в оценке миграции на Haiku показано, почему синтаксис, структура и факты там тоже нужно проверять отдельно.
Часто задаваемые вопросы
- Какая модель надёжнее всего работает с инструментами?
- По этому тесту из шести случаев определить это нельзя. Все три модели прошли по одному обычному сценарию и сценарию с искусственно созданной ошибкой. Перед выбором самой надёжной модели проверьте репрезентативный размеченный набор и укажите число сбоев.
- Проверяли ли вы восстановление после ограничения частоты запросов провайдером?
- Нет. Ошибка была искусственно создана в нашей локальной синтетической функции для работы с заказами. Это не HTTP-ошибка провайдера, не ограничение частоты запросов и не сбой сервиса.
- Можно ли выполнять любую команду инструмента, которую запрашивает модель?
- Нет. Разрешайте только инструменты из списка, проверяйте аргументы и до выполнения проверяйте права доступа к записи заказа. Наш тестовый инструмент может только прочитать один синтетический заказ и не способен выполнять внешние действия.