Gemini 4 Carbon API: Was kostet eine vollständige Aufgabe?
Berechnen Sie die Kosten einer Gemini-4-Carbon-Aufgabe mit einem geprüften Python-Rechner: aktuelle und Dezember-Tarife, Cache, Denk-Token, Wiederholungen, Agentenschritte und separate Tool-Gebühren.
 Ofox
Für die Kostenschätzung einer Gemini-4-Carbon-Aufgabe addieren Sie die bekannten Kosten aller eigenständigen Versuche und Fortsetzungsschritte: Eingaben ohne Cache-Treffer, Eingaben aus dem Cache, generierte Token einschließlich Denk-Token sowie separat berechnete Tools. Wählen Sie vor der Rechnung den gültigen Tarifzeitraum. Die sichtbare Endantwort ist nur ein Teil dieser Rechnung. Ein Wiederholungsversuch oder ein früherer Agentenschritt kann Ressourcen verbrauchen, auch wenn er kein akzeptiertes Ergebnis liefert.
Dieser Leitfaden enthält einen vollständigen Python-Rechner zum Herunterladen, ein einheitliches Eingabeformat und nachvollziehbare Rechenbeispiele. Er verwendet die Google-Standardpreise in USD für gemini-4-carbon, geprüft am 15. November 2026. Batch, Flex, Priority, individuell vereinbarte Konditionen und Ofox-Routen sind nicht Gegenstand dieser Preise. Wenn Sie zunächst einen funktionierenden Aufruf benötigen, beginnen Sie mit der Anleitung zur Carbon-API-Einrichtung.
Herausgeber dieses Artikels ist Ofox. Rechner und CLI haben 24 Offline-Tests bestanden. Sämtliche Token-Mengen und Aufgabenergebnisse der Beispiele sind Annahmen, keine gemessenen Modellläufe oder Anbieterrechnungen. Das Paket ruft keine API auf, lädt keinen Schlüssel und interpretiert rohe Usage-Daten eines Anbieters nicht automatisch. Es soll ein inhaltlich bestätigtes Nutzungsprotokoll reproduzierbar berechnen und häufige Zählfehler erkennen.
Exaktes Modell, Tarifstufe und Gültigkeitsdatum auswählen
Googles Carbon-Preistabelle (Englisch) nennt die folgenden Standardpreise. Jede Rate gilt in USD pro einer Million Token, nicht pro Anfrage oder akzeptierter Aufgabe.
| Abrechnungskategorie | Bis einschließlich 30. November 2026 | Ab 1. Dezember 2026 | Anzuwenden auf |
|---|---|---|---|
| Reguläre Eingabe | 2,00 USD | 4,00 USD | Eingabe-Token ohne Cache-Treffer |
| Eingabe aus dem Cache | 0,10 USD | 0,20 USD | Den tatsächlich im Cache gefundenen Eingabeanteil |
| Ausgabe einschließlich Denken | 10,00 USD | 20,00 USD | Die bestätigte kombinierte abrechenbare Generierungsmenge |
Zum Prüfdatum ist die Dezember-Spalte ein Zukunftsszenario, nicht der aktuelle Preis. Bei identischen Token-Mengen verdoppeln sich diese drei Token-Raten. Separate Tool-Gebühren verdoppeln sich dadurch nicht automatisch. Google führt für Carbon keine Free-Stufe auf; ein Tool-Freikontingent macht die Token-Verarbeitung von Carbon nicht kostenlos.
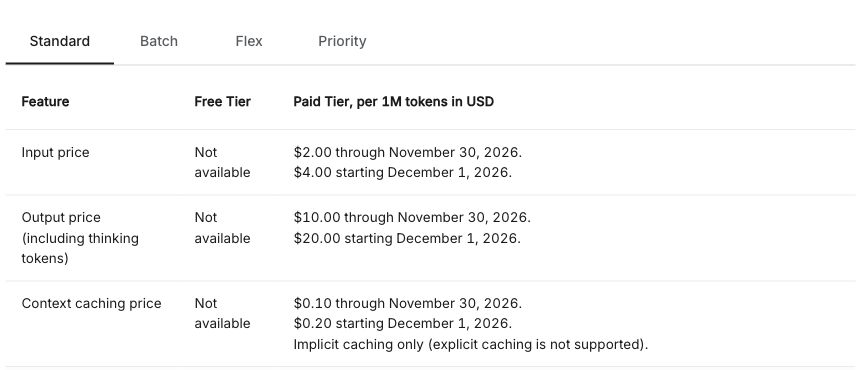
Echter Screenshot der offiziellen englischen Carbon-Preisseite, auf die Standard-Token-Raten ohne Kontoinformationen zugeschnitten. Er belegt Preise, keine Rechnung und kein Ofox-Angebot.
Halten Sie Modell-ID, Tarifstufe, Währung, Einheit und Gültigkeitszeitraum zusammen fest. Ein Preis einer benachbarten Gemini-Version oder einer anderen Inferenzstufe reicht nicht aus, um einen Carbon-Aufruf zu kalkulieren. Unser Leitfaden zur Google-Modellauswahl behandelt die Eignung für Aufgaben. Dieser Artikel belegt nicht, dass Carbon der günstigste Weg zu einem gleichwertigen Ergebnis ist.
Google berechnet manche Tools zusätzlich. Der Hinweis zu Search Grounding erklärt, dass eine Kundenanfrage mehrere Suchabfragen auslösen kann, die für die Tool-Abrechnung relevant sind. Gemeinsame Freikontingente und Grenzen müssen im aktuellen Abschnitt zu Tool-Preisen geprüft werden. Multiplizieren Sie keinen pauschalen Tool-Betrag mit der Zahl Ihrer Anwendungsanfragen, sofern dies nicht die tatsächliche Abrechnungseinheit ist. Der Rechner erwartet einen bekannten separaten Tool-Betrag in USD, keine geschätzte Anzahl von Tool-Aufrufen.
Nutzungsdaten vor der Formel vereinheitlichen
Das Protokoll nutzt eigene Feldnamen. Sie sind keine Antwortfelder von Google oder Ofox. Bevor Sie echte Werte eintragen, prüfen Sie die Spezifikation für den genauen Endpunkt, die SDK-Version und den Ausführungsmodus. Bewahren Sie die ursprünglichen Usage-Daten vertraulich auf, damit die Umrechnung nachvollziehbar bleibt.
| Protokollfeld | Erforderliche Bedeutung | Zu vermeidender Fehler |
|---|---|---|
id | Eindeutige Kennung eines separat gezählten Versuchs oder Fortsetzungsschritts | Dieselbe Anfrage anhand mehrerer Momentaufnahmen doppelt erfassen |
input_total | Gesamte abrechenbare Eingabe der Zeile einschließlich ihres Cache-Anteils | Ein Feld, das bereits nur nicht gecachte Eingabe zählt, als Gesamtmenge behandeln |
cached_input | Bestätigter Cache-Trefferanteil innerhalb von input_total | Alle cachefähigen Token als tatsächliche Treffer annehmen |
generated_including_thinking | Kombinierte abrechenbare Generierungsmenge, Denk-Token genau einmal enthalten | Denk-Token zu einem Feld addieren, das sie bereits enthält |
tools_usd | Bekannte separate Tool-Gebühr als Dezimalzeichenfolge; "0" nur bei bestätigtem Nullbetrag | Unbekannte Gebühren oder Tool-Token-Mengen als null Dollar behandeln |
Googles Dokumentation zur Token-Zählung (Englisch) nennt unter anderem total_input_tokens, total_output_tokens, total_thought_tokens, total_cached_tokens und total_tool_use_tokens. Die Namen allein liefern keine allgemeingültige Zuordnung zur Rechnung. Die für diesen Artikel geprüften Dokumente und SDK-Kommentare belegen keine einheitliche Einschlussregel für Ausgabe und Denken über sämtliche Carbon-Routen und Modi hinweg.
Die Umwandlung muss daher bedingt erfolgen: Bestätigt die passende Spezifikation, dass die Ausgabesumme das Denken bereits enthält, verwenden Sie diese kombinierte Menge einmal. Bestätigt sie, dass sichtbare Ausgabe und Denken getrennte, nicht überlappende abrechenbare Mengen sind, addieren Sie sie einmal zum normalisierten Feld. Ist das Verhältnis unklar, stoppen Sie und markieren die Menge als unbekannt. Wählen Sie keine Formel nur deshalb, weil die Zahlen plausibel wirken. Auch die Zahl der Tool-Nutzungstoken entspricht nicht automatisch einer zusätzlichen Geldgebühr.
Klären Sie ebenso, ob ein Usage-Objekt eine Anfrage, einen Fortsetzungsschritt oder die kumulierte Interaktion abdeckt. Addieren Sie keine kumulativen Streaming-Zwischenstände. Enthält der Endwert frühere Schritte bereits, verwenden Sie entweder diesen Endwert einmal oder bestätigte überschneidungsfreie Einzelwerte. Beides zusammen überschätzt die Aufgabe.
Nach dieser Vereinheitlichung ist die Formel für eine Zeile einfach:
ordinary_input = input_total - cached_input
row_cost_usd = (
    ordinary_input * ordinary_input_rate
    + cached_input * cached_input_rate
    + generated_including_thinking * generated_rate
) / 1_000_000 + tools_usd

task_cost_usd = sum(cost of each non-overlapping row)
Wegen dieser Subtraktion muss Cache-Eingabe eine Teilmenge der Gesamteingabe sein. Wer zuerst den gesamten Eingang regulär bepreist und dann den Cache-Anteil hinzurechnet, zählt diese Token doppelt. Ergänzen Sie diese Carbon-Formel auch nicht um eine Speichergebühr für explizites Caching: Die zitierte Rate gilt für implizite Cache-Treffer, und explizites Caching wird nicht unterstützt.
Den vollständigen Rechner lokal ausführen
Laden Sie das Carbon-Paket zur Aufgabenkostenberechnung herunter, entpacken Sie es und wechseln Sie nach carbon-task-cost-kit. Es enthält cost.py, die CLI calculate.py, zwei Testmodule, zwei Beispielprotokolle und eine englische README. Es nutzt ausschließlich die Python-Standardbibliothek; Modell-SDK, API-Schlüssel und Netzwerkaufruf sind nicht nötig.
Verwenden Sie Python 3.11 oder neuer. Führen Sie vor dem Ersetzen der Beispieldaten die Tests aus:
python -m unittest test_cost.py test_cli.py -vErwartet werden 24 erfolgreiche Tests: 16 Rechnerprüfungen und acht CLI-Prüfungen. Sie decken Dezimalarithmetik, Cache-Teilmengen, fehlende Nutzung, doppelte IDs, ungültige Zeiträume, doppelte JSON-Felder, fehlerhafte Protokolle und exakte CLI-Ausgaben ab. Das ist ein Nachweis für den lokalen Rechner, keine Validierung der Abrechnungsimplementierung eines Providers.
Die mitgelieferte Datei single-attempt.json enthält einen erfundenen Versuch:
[
  {
    "id": "illustrative-success",
    "input_total": 50000,
    "cached_input": 40000,
    "generated_including_thinking": 6000,
    "tools_usd": "0"
  }
]
Führen Sie die enthaltenen Szenarien aus:
python calculate.py single-attempt.json --period through-2026-11-30
python calculate.py single-attempt.json --period from-2026-12-01
python calculate.py retry-task.json --period through-2026-11-30
Die USD-Gesamtergebnisse lauten in dieser Reihenfolge "0.084", "0.168" und "0.234". Die JSON-Ausgabe zerlegt jede Zeile zusätzlich in reguläre Eingabe, Cache-Eingabe, generierte Token und Tool-Gebühren. Geldbeträge werden als Dezimalzeichenfolgen ausgegeben, um die genaue Rechnung zu erhalten, nicht bei jedem Zwischenschritt auf Cent gerundet. Formatieren Sie einen Anzeigewert erst, nachdem das exakte Ergebnis gespeichert ist.
Für eigene Daten kopieren Sie ein Beispiel in eine neue JSON-Datei, tragen Werte mit bestätigter Bedeutung ein und starten python calculate.py your-ledger.json --period through-2026-11-30 oder den anderen ausdrücklich gewählten Zeitraum. Prüfen Sie die Einzelbeträge zunächst von Hand, bevor Sie viele Zeilen verarbeiten. Ein leeres Protokoll wird abgelehnt: Es beweist nicht, dass eine erledigte Aufgabe nichts gekostet hat.
Das Programm beendet sich bei fehlenden Mengen, negativen oder nicht ganzzahligen Token-Zahlen, Cache-Eingabe über der Gesamteingabe, doppelten IDs, doppelten JSON-Feldern und unerwarteten Feldern mit einem Fehler. Tool-Gebühren müssen bekannte nichtnegative Dezimalwerte sein; verwenden Sie in JSON beispielsweise "0.01". Zusätzliche Denk-Mengen oder zeilenweise Preisüberschreibungen werden ebenfalls abgelehnt, damit die Normalisierung ausdrücklich erfolgt. Menschliche Notizen und Verweise auf Quelldatensätze gehören in eine separate Datei, nicht beliebig in das Rechenschema.
Die Aufgabenszenarien nachrechnen
Die folgenden Rechnungen verwenden erfundene normalisierte Nutzung. Sie sagen nicht voraus, wie viele Token Carbon für Ihren Prompt benötigt, ob der Cache trifft oder ob das Ergebnis Ihre Qualitätskriterien erfüllt.
Ein akzeptierter Versuch zu aktuellen Preisen
Angenommen, die Gesamteingabe beträgt 50.000 Token, davon 40.000 Cache-Treffer. Die kombinierte Generierung umfasst 6.000 Token, und separate Tool-Gebühren sind nachweislich null. Reguläre Eingabe sind somit 10.000 Token.
- Reguläre Eingabe:
10,000 × $2 / 1,000,000 = $0.020. - Cache-Eingabe:
40,000 × $0.10 / 1,000,000 = $0.004. - Generierung einschließlich Denken:
6,000 × $10 / 1,000,000 = $0.060. - Gesamt: 0,084 USD.
Der sichtbare Endtext kann weniger als 6.000 Token enthalten. Die Generierungsmenge dieses Beispiels ist bereits kombiniert und darf keinen zusätzlichen Denk-Anteil erhalten.
Dieselbe Nutzung zu den angekündigten Dezember-Preisen
Bei unveränderten Mengen ergibt sich $0.040 + $0.008 + $0.120 = $0.168. Das ist genau das Doppelte des reinen Token-Szenarios, weil alle drei genannten Standardraten steigen. Es ist ein Vergleich von Tarifzeiträumen bei identischer Nutzung, keine Vorhersage identischer Token-Mengen für reale Dezember-Aufgaben.
Käme in beiden Zeiträumen eine separate bekannte Tool-Gebühr von 0,01 USD hinzu, wären die Summen 0,094 USD und 0,178 USD. Eine Verdopplung der ersten Summe auf 0,188 USD würde die unveränderte Tool-Gebühr fälschlich mitverdoppeln. Die 0,01 USD sind eine Annahme zur Illustration, kein zitierter Google-Tool-Preis.
Ein fehlgeschlagener erster Versuch vor dem akzeptierten Ergebnis
retry-task.json ergänzt vor dem oben akzeptierten Versuch einen ersten mit bekannter Nutzung: 50.000 nicht gecachte Eingabe-Token und 5.000 generierte Token einschließlich Denken. Beide Zeilen nehmen separate Tool-Gebühren von null an.
[
  {
    "id": "illustrative-failed-attempt",
    "input_total": 50000,
    "cached_input": 0,
    "generated_including_thinking": 5000,
    "tools_usd": "0"
  },
  {
    "id": "illustrative-success",
    "input_total": 50000,
    "cached_input": 40000,
    "generated_including_thinking": 6000,
    "tools_usd": "0"
  }
]
Die erste Zeile kostet $0.100 + $0.050 = $0.150. Mit der erfolgreichen Zeile sind es 0,234 USD für die Aufgabe, obwohl der akzeptierte Versuch allein 0,084 USD kostet. „Fehlgeschlagen“ bezeichnet hier einen angenommenen Versuch mit unabhängig bekannter abrechenbarer Nutzung. Es wird nicht behauptet, jede abgelehnte HTTP-Anfrage verursache diese Kosten.
Einzelne kontrollierte Änderungen zeigen, worauf die Rechnung reagiert:
| Angenommenes Szenario | Gesamt in USD | Änderung |
|---|---|---|
| Aktuelle Preise, 40.000 Cache-Treffer, 6.000 generierte Token | 0,084 | Ausgangsfall |
| Aktuelle Preise, keine Cache-Treffer, gleiche Gesamtmengen | 0,160 | Alle 50.000 Eingabe-Token zum regulären Preis |
| Aktuelle Preise, 40.000 Cache-Treffer, 16.000 generierte Token | 0,184 | 10.000 zusätzliche generierte Token einschließlich Denken |
| Dezember-Preise, Token-Mengen des Ausgangsfalls | 0,168 | Nur Tarifzeitraum geändert |
| Aktuelle Preise, Ausgangsfall plus bekannte Tool-Gebühr von 0,01 USD | 0,094 | Nur separate Tool-Gebühr ergänzt |
| Dezember-Preise, Ausgangsfall plus dieselbe Gebühr von 0,01 USD | 0,178 | Geänderte Token-Preise, unveränderte Tool-Gebühr |
Das sind Rechnungen, kein Modellbenchmark und kein Versprechen, dass eine bestimmte Prompt-Änderung den gezeigten Betrag spart.
Cache-Voraussetzungen und kurze Agentenschritte verstehen
Googles Caching-Leitfaden (Englisch) nennt für implizites Carbon-Caching mindestens 4.096 Eingabe-Token. Diese Voraussetzung garantiert keinen Treffer. Die zitierte Cache-Rate liegt für tatsächlich treffende Token 95 Prozent unter der regulären Eingaberate. Das ist kein Rabatt von 95 Prozent auf sämtliche Token oder die gesamte Aufgabe.
Explizites Anlegen von Caches und cached_content-Referenzen werden für Carbon nicht unterstützt. Fügen Sie keine explizite Cache-ID hinzu, nur um die günstigere Spalte zu erzwingen. Stabile gemeinsame Präfixe und ähnliche Anfragen in engem zeitlichem Abstand können implizite Wiederverwendung begünstigen; maßgeblich fürs Protokoll sind aber tatsächlich gemeldete Treffer. Die Dokumentation nennt dafür usage.total_cached_tokens. Prüfen Sie trotzdem vor der Normalisierung das Verhältnis zur Eingabesumme des Endpunkts.
Derselbe Leitfaden beschreibt eine weitere Gemini-4-Regel für mehrstufige Gespräche und Agentenschleifen: Die vollständige vorige Anfrage wird nur gecacht, wenn die neue mindestens 2.050 Token ergänzt, wobei Modellausgabe, Denken und Funktionsergebnisse mitzählen. Bei kleinerer Ergänzung werden die letzten 2.050 Token der vorigen Anfrage zum regulären Eingabepreis erneut verarbeitet.
Diese Regel ist nicht identisch mit der 4.096-Token-Voraussetzung. Sie besagt weder, dass der Cache des gesamten Gesprächs verloren geht, noch definiert sie eine feste Zusatzgebühr pro Schritt. Wenn normalisierte Eingabe- und Cache-Mengen die tatsächliche Verarbeitung bereits abbilden, würde das Hinzufügen weiterer 2.050 Token doppelt zählen. Nutzen Sie die Regel zur Erklärung unerwarteter Nutzung, nicht zum Erfinden zusätzlicher Mengen über gemessene Felder hinaus.
Zwei Agenten können zum Beispiel dieselben langen Startanweisungen behalten und dennoch andere Eingabekosten erzeugen, weil sie pro Schritt unterschiedlich viel neues Material ergänzen. Vergleichen Sie ihre tatsächlichen Eingabe- und Cache-Daten. Füllen Sie Prompts nicht allein zum Überschreiten einer Schwelle auf, ohne den zusätzlichen Verarbeitungsaufwand und die Qualität des akzeptierten Ergebnisses zu bewerten.
Denken, Verlauf und Fortsetzungen budgetieren
Die Carbon-Dokumentation (Englisch) beschreibt max_output_tokens als Grenze für Denken und Ausgabe zusammen. Es ist kein Dollarbudget für die vollständige Agentenaufgabe. Eingabe, Tool-Gebühren, Wiederholungen und spätere Aufrufe können außerhalb der Generierungsgrenze einer einzelnen Antwort weitere Kosten verursachen.
Carbon unterstützt low, medium und high als Denkstufen; dokumentierter Standard ist medium. Weniger Denken kann sowohl den Verbrauch als auch die Wahrscheinlichkeit eines brauchbaren Resultats verändern. Ein günstigerer Versuch bedeutet bei mehr Wiederholungen nicht zwingend eine günstigere akzeptierte Aufgabe. Vergleichen Sie dieselbe Aufgabe unter denselben Abnahmekriterien, bevor Sie eine Stufe wählen. Dieser Artikel enthält kein Qualitätsexperiment zum Vergleich dieser Stufen.
Lange Generierung kann sich über Fortsetzungsschritte erstrecken. Serverseitige Fortsetzung im Hintergrund kann eine kumulierte Interaktion liefern, während eine clientseitige Schleife einzelne Datensätze erzeugt. Carbons gemeinsamer Kontext umfasst Eingabe, Denken und Ausgabe; ein großes Fenster ist kein unabhängiges Kontingent für jede der drei Mengen. Unsere Carbon-Einrichtungsanleitung behandelt Konfiguration und Fortsetzungswege. Das Kostenprotokoll muss den tatsächlichen Grenzen der zurückgegebenen Nutzung folgen.
Verfolgen Sie bei mehrstufigen Agenten, welche Historie und Tool-Ergebnisse jede Anfrage enthält. Auch wenn der Nutzer nur einen kurzen Satz ergänzt, kann die abrechenbare Eingabe erhaltenen Kontext einschließen. Umgekehrt darf ein korrekt abgegrenzter Cache-Anteil nicht erneut als reguläre Eingabe berechnet werden. Addieren Sie niemals die abschließende kumulierte Interaktion und deren Einzelschritte gleichzeitig.
Eine praktische Ausgabenkontrolle kombiniert ein Generierungslimit pro Antwort, eine maximale Zahl von Agentenschritten, eine Regel für unklare Ergebnisse und ein zwischen Schritten geprüftes Aufgabenbudget. Der Rechner kann bekannte Nutzung oder eine ausdrücklich angenommene Prognose auswerten. Er garantiert nicht, dass eine schon laufende Anfrage exakt an einer Dollargrenze stoppt, und erschließt keine nicht gemeldete Gebühr.
Wiederholungen und fehlende Nutzung als Abrechnungsfragen behandeln
Ein Client-Timeout beweist nicht, ob der Server die Anfrage ausgeführt hat. Ein HTTP-Fehler beweist nicht, dass jeder solche Versuch berechnet wurde, und ein fehlender Usage-Block beweist keinen Nullverbrauch. Bewahren Sie die Anfragekennung auf und führen Sie die Zeile als unbekannt, bis die Providerdaten sie klären. Setzen Sie keine erfundenen Nullen ein, nur damit der Rechner die Eingabe akzeptiert.
Unterscheiden Sie vor einem erneuten Versuch zwischen Authentifizierung, Zugriff, Kontingent, ungültigen Parametern und vorübergehenden Fehlern. Unser Leitfaden zu Gemini-4-API-Fehlern liefert eine nützliche Einteilung; seine modellspezifischen Beispiele beziehen sich allerdings auf Argon und nicht Carbon. Anwendungen auf Ofox’ API sollten die zugehörige Dokumentation zu Fehlerbehandlung und Wiederholungen nutzen. Dieser Verweis belegt keine Ofox-Unterstützung der hier behandelten Carbon-Route.
Erfassen Sie jeden wirklich eigenständigen Versuch genau einmal. Ein erneuter Versuch kann eine neue Anfrage sein, ein GET zur Ergebnisabfrage dagegen nur bereits geleistete Arbeit abrufen. Bezeichnen Sie nicht beides ohne Spezifikationsprüfung als zweite Generierung. Ebenso dürfen App-Log und Provider-Log desselben Versuchs nicht allein wegen verschiedener Quellen zwei Kostenzeilen erzeugen.
Definieren Sie Erfolg auf Aufgabenebene. Bei Programmieraufgaben könnte eine Abnahme die verlangte Änderung, das passende Testergebnis und die Akzeptanz des Endartefakts dokumentieren. Bei Extraktion könnten Schemavalidität und geprüfte Übereinstimmung mit Quellen zählen. HTTP 200 allein belegt keines dieser Ergebnisse. Bewahren Sie Abnahmenachweise beim Kostenprotokoll auf und schützen Sie private Ausgangsmaterialien.
Vergleichen Sie Alternativen mit denselben Aufgaben und Abnahmeregeln, schließen Sie bekannte erfolglose Versuche ein und weisen Sie ungeklärte Nutzung separat aus. Dann lassen sich zurechenbare Ausgaben durch die Zahl akzeptierter Aufgaben teilen. Wurde keine Aufgabe akzeptiert, berichten Sie das, statt endliche Kosten pro Erfolg zu erfinden. Die Beispiele dieses Artikels setzen Abnahmelabels voraus; sie messen keine Erfolgsquote.
Das Protokoll mit Providerdaten abgleichen
Beginnen Sie mit einer kleinen Aufgabe, deren Nutzungsgrenzen Sie erklären können. Speichern Sie rohe Antwort, Normalisierungsnotizen, exaktes Modell und Tarifstufe, Preisstand, Abrechnungszeitraum, eindeutige Versuchskennungen, Rechnerversion und Abnahmeergebnis vertraulich. Berechnen Sie das Protokoll und vergleichen Sie die Bestandteile mit Providerdaten. Klären Sie Abweichungen, bevor Sie die Schätzung auf Tausende Aufgaben hochrechnen.
Überschreitet eine Aufgabe den Preiswechsel, teilen Sie Zeilen nach gültigem Zeitraum auf, berechnen jede Gruppe getrennt und addieren die exakten Ergebnisse. Die CLI verwendet absichtlich einen expliziten Zeitraum für die komplette Eingabe. Sie ermittelt weder Abrechnungsdaten noch Zeitzonen und lehnt zeilenweise Überschreibungen ab. Ordnen Sie echte Zeilen nach den tatsächlichen Gültigkeitsregeln des Anbieters zu. Eine Simulation zukünftiger Preise bleibt auch bei exakter Arithmetik eine Prognose.
Die berechnete Nutzungssumme ist zudem von Steuern, Währungsumrechnung, vertraglichen Anpassungen und Rundung auf Rechnungsebene zu unterscheiden. Erhalten Sie während der Berechnung volle Dezimalpräzision und dokumentieren Sie spätere Rundung für die Anzeige. Schreiben Sie historische Rechnungen nicht mit heutigen Tarifen um.
Für Ofox-unterstützte Modelle erläutert die Dokumentation zur Nutzungsverfolgung Anfrage-, Token- und Kostenaufschlüsselungen. Die Abrechnungsdokumentation verweist auf Kostenansichten und Modellkatalog. Unsere Prüfung vom 15. November verfolgte den Catalog-Proxy von ofoxai/home-page bei Commit 0e0c8cc6e655b606466142aae0929a666fbaaf0e und speicherte alle 133 Einträge der aktuellen öffentlichen Antwort. In diesem Datenstand erschien Carbon nicht. Das beweist keine dauerhafte Nichtverfügbarkeit, bedeutet aber, dass hier kein verifizierter Ofox-Carbon-Preis zitiert werden kann. Die Google-Raten oben dürfen nicht als Ofox-Preise dargestellt werden.
Ofox’ Protokolle für Anfrageinhalte sind eine andere Funktion als Nutzungs- und Gebührenaufzeichnungen. Inhaltsspeicherung ist standardmäßig deaktiviert und gilt nach Aktivierung durch einen berechtigten Teamadministrator für nachfolgende Anfragen im konfigurierten Umfang. Gehen Sie weder davon aus, alte Prompts wiederherstellen zu können, noch davon, für reine Kostenberechnung vollständige Inhalte speichern zu müssen. Beachten Sie bei der Beweissicherung die Datenregeln Ihres Teams.
Das Ergebnis ist ein Protokoll, das sich auf bekannte Nutzung, einen festgelegten Tarifzeitraum und die Aufgabenabnahme zurückführen lässt. Bleibt eine Menge unbekannt, machen Sie diese Grenze sichtbar. Eine reproduzierbare Rechnung mit klaren Grenzen ist hilfreicher als eine präzise wirkende Summe auf ungeprüften Annahmen.