Von Gemini 3.8 Flash zu Hydrogen wechseln und den Kontext erhalten
Gemini 3.8 Flash zu Hydrogen migrieren: Denkstufe festlegen, Cache-Inhalte wiederherstellen, Tool-Verlauf erhalten und Regression sowie Rollback prüfen.
 Ofox
Bei der Migration von Gemini 3.8 Flash zu Gemini 4 Hydrogen behalten Sie den API-Vertrag und Anwendungskontext bei, ändern die Modell-ID, wählen die Denkstufe ausdrücklich und prüfen die Aufgabenergebnisse erneut, bevor Sie produktive Arbeit umleiten. Ein ausgetauschter Modellname stellt keine Dokumente hinter einem nicht mehr unterstützten Cache-Verweis wieder her. Er beweist auch nicht, dass eine serverseitig gespeicherte Unterhaltung mit einem anderen Modell fortgesetzt werden kann.
Dieser Leitfaden richtet sich an bereits funktionierende Anwendungen. Für den ersten Schlüssel und Request verwenden Sie die Hydrogen-API-Anleitung. Hier erstellen wir einen kleinen Vorher-nachher-Request, prüfen die Erhaltung des Verlaufs und definieren Abnahme und Rollback. Kontext erhalten bedeutet, die beschriebenen Prüfungen und Wiederherstellungen durchzuführen; identische Antworten beider Modelle werden nicht garantiert.
Die Dokumentation wurde am 14. November 2026 geprüft. Unser Download-Kit bestand 21 Offline-Tests für das Request-Audit und eine separate Prüfung der tatsächlichen Request-Serialisierung von google-genai==3.3.0 mit einem simulierten HTTP-Transport. Wir haben keines der Modelle aufgerufen, keine reale modellübergreifende Unterhaltung geprüft, keine Qualität gemessen und keine Rechnungen verglichen. Die folgenden Regressionskriterien sind ein Prüfplan für Ihre Anwendung, keine gemessenen Benchmark-Ergebnisse.
Tatsächliche Änderungen erkennen
Lesen Sie die Hydrogen-Migrationshinweise zusammen mit der Veröffentlichungsdokumentation zu Gemini 3.8. Eine im neuen Leitfaden wiederholte Einschränkung muss keine neue inkompatible Änderung sein. Die verlinkten Google-Dokumentationen sind auf Englisch.
| Bereich | Bisheriges Verhalten von Gemini 3.8 Flash | Entscheidung für Hydrogen |
|---|---|---|
| Modell-ID bei Google | gemini-3.8-flash | gemini-4-hydrogen verwenden und Kontozugriff separat bestätigen |
| Standard-Denkstufe | medium | Jetzt high; für einen kontrollierten Vergleich explizit festlegen |
| Denkstufen | low, medium, high | xhigh kommt hinzu; minimal war bereits bei 3.8 nicht unterstützt |
| Kontextbudget | Getrennte Eingabe- und Ausgabelimits | Eingabe, Denken und Ausgabe teilen 1.048.576 Token |
| Expliziter Kontext-Cache | Abhängigkeit des vorhandenen Requests prüfen | Bei Hydrogen nicht unterstützt; Inhalte vor Entfernen des Verweises rekonstruieren |
| Sampling-Parameter | Schon im 3.8-Migrationsleitfaden als veraltet beschrieben | Benutzerwerte im gültigen Bereich werden ignoriert; Werte außerhalb können weiterhin einen 400-Validierungsfehler auslösen |
| Lange Ausgabe | Anwendung erwartet möglicherweise eine einzelne Antwort | Oberhalb von 65.536 Token pro synchronem Schritt sind Hintergrundausführung oder clientseitige Fortsetzungen nötig |
Hydrogen auf medium zu setzen kontrolliert eine Konfigurationsvariable. Das bedeutet nicht, dass interne Denkarbeit, Latenz oder Qualität gleich sind. Ein größeres maximales Ausgabefenster bedeutet auch nicht, dass nach einer fast vollständigen Eingabe noch genauso viel Platz übrig bleibt. Kalkulieren Sie Denken und Antwort im gemeinsamen Budget und behalten Sie anwendungsseitige Ausgabe- und Kostengrenzen bei.
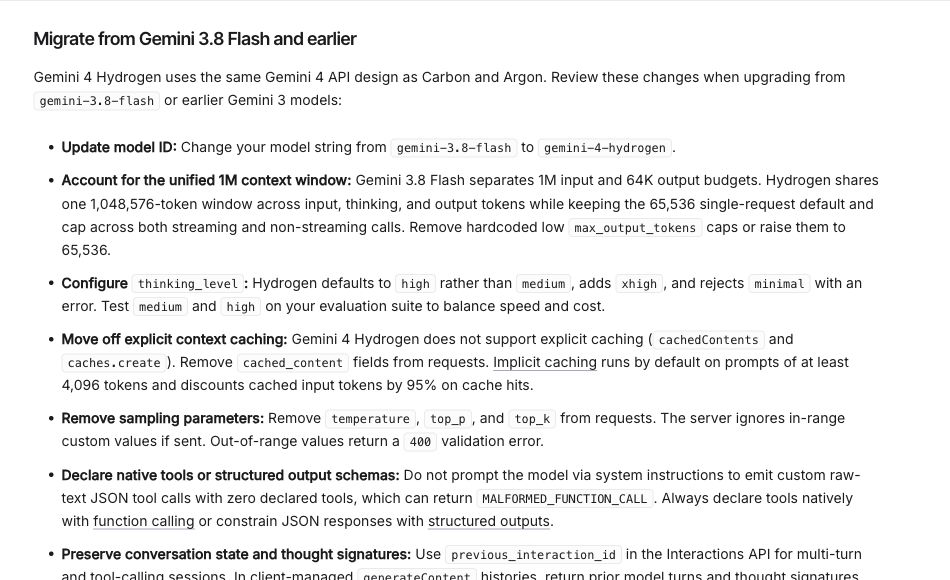
Tatsächlicher Screenshot der englischen Google-Migrationsdokumentation. Er dokumentiert die Quelle, keinen erfolgreichen API-Wechsel und keinen Ofox-Leistungstest.
Details zur Ausgabe finden Sie in Googles Long-Decode-Dokumentation. Ein Limit pro Schritt ist eine Grenze für die Controller-Architektur, kein Beleg dafür, dass jeder größere angeforderte Ausgabewert grundsätzlich ungültig ist.
Ausgangskonfiguration sichern und beim Protokoll bleiben
Speichern Sie vor dem Modellwechsel eine versionierte Ausgangskonfiguration und einen kleinen reproduzierbaren Aufgabensatz. Erfassen Sie Modell, Endpoint, SDK-Version, Systemanweisungen, Eingabeaufbau, Tools, Antwortschema, Ausgabelimit, Speicherung, Retry-Regeln und Provider-Routing-Felder. Originaldokumente und zulässige Nutzereingaben gehören in den üblichen geschützten Speicher, nicht als Migrationsarchiv in öffentliche Debug-Logs.
Unterscheiden Sie drei Request-Formate:
| Bestehender Aufrufer | Diese Grenze beibehalten | Nicht unverändert einsetzen |
|---|---|---|
| Google Interactions | input, generation_config, Interaktionsschritte und IDs | GenerateContent-Struktur mit contents |
| Google GenerateContent | contents, Inhalts-Parts, Tool-Deklarationen und SDK-Konfiguration | Interactions-previous_interaction_id als Ersatz für den Verlauf |
| OpenAI-kompatibler Ofox-Client | Dokumentierte Nachrichten, Modellrouting und Antwortvertrag | Nativen Google-Interactions-Request |
Das vollständige Beispiel unten verwendet Google Interactions. Der separate Serialisierungstest im Kit nutzt GenerateContent, weil er Modell-Parts und Tool-Antworten untersucht. Es sind unabhängige Prüfungen; eine führt keine Konvertierung des anderen Protokolls durch.
Prüfen Sie in Ofox-Anwendungen zuerst den tatsächlich verwendeten Weg: Gemini Generate Content oder OpenAI-kompatible Chat Completions. Nutzen Sie die entsprechenden Ofox-Schlüssel- und Authentifizierungshinweise. Google- und Ofox-Schlüssel sind nicht austauschbar. Ein dokumentierter nativer Gemini-Weg bestätigt nicht automatisch alle Google-Interactions-Funktionen oder Cache-Fähigkeiten jedes Modells.
Trennen Sie außerdem fertige Tool-Clients von eigenen Anwendungen. Baut Cline oder OpenCode den Request, folgen Sie der Hydrogen-Einrichtung für Coding-Tools und prüfen Sie die tatsächlich gesendeten Daten. Gehen Sie nicht davon aus, dass der Client das folgende JSON sendet.
Einen kleinen, expliziten Vorher-nachher-Request erstellen
Wählen Sie eine Aufgabe, deren richtige Antwort ohne ein zweites Modell prüfbar ist. Im Ausgangsbeispiel stehen zwei Datensätze; nur B ist blockiert. Speichern Sie das vollständige Objekt als source-request.json:
{
  "model": "gemini-3.8-flash",
  "input": "Records: A=ready; B=blocked. Return the blocked record IDs only.",
  "generation_config": {
    "max_output_tokens": 8192
  },
  "response_format": {
    "type": "text",
    "mime_type": "application/json",
    "schema": {
      "type": "object",
      "properties": {
        "blocked_ids": {"type": "array", "items": {"type": "string"}}
      },
      "required": ["blocked_ids"],
      "additionalProperties": false
    }
  }
}
Erstellen Sie hydrogen-request.json, indem Sie Eingabe, Schema und Ausgabelimit erhalten, aber das Modell wechseln und die Denkstufe explizit setzen:
import json
from pathlib import Path

source = json.loads(Path("source-request.json").read_text())
target = json.loads(json.dumps(source))
target["model"] = "gemini-4-hydrogen"
target["generation_config"]["thinking_level"] = "medium"
Path("hydrogen-request.json").write_text(json.dumps(target, indent=2))
Beide vollständigen JSON-Dateien liegen im Kit. Die 8.192 Token sind eine kontrollierte Einstellung dieses Beispiels, keine allgemeine Produktionsempfehlung. Selbst eine kurze JSON-Antwort kann scheitern, wenn das Denken das Budget aufbraucht. Prüfen Sie Abschluss und Abbruch; erhöhen Sie Produktionslimits nicht automatisch auf das Maximum, um einen Fehler zu verdecken.
Das Antwortformat folgt Googles aktuellem Vertrag für strukturierte Ausgaben: Text mit MIME-Typ application/json und einem Schema. Dieses begrenzt die Form, beweist aber nicht die Auswahl des richtigen Datensatzes.
Nach Einrichtung Ihres Google-Projektschlüssels in GEMINI_API_KEY über die übliche Geheimnisverwaltung können Sie optional den folgenden echten Request senden. Er kontaktiert Google und kann Kontingent oder kostenpflichtige Nutzung verbrauchen. Für diesen Artikel wurde er nicht ausgeführt.
curl --fail-with-body --max-time 180 \
  'https://generativelanguage.googleapis.com/v1beta/interactions' \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  --data-binary @hydrogen-request.json \
  --output hydrogen-response.json
Wiederholen Sie den Befehl mit source-request.json und einem anderen Ausgabedateinamen für die Ausgangsbasis. Konto, Eingabe, Schema und Bedingungen müssen vergleichbar bleiben. Prüfen Sie zuerst Interaktionsstatus, Fehler und unvollständige Ergebnisse. Nur eine abgeschlossene Antwort mit erwarteter Ausgabe darf den Anwendungsparser erreichen. Parsen Sie den JSON-Text und verlangen Sie für dieses Beispiel genau {"blocked_ids":["B"]}, ohne weitere Schlüssel oder IDs. HTTP 200, gültiges JSON und eine richtige Aufgabenlösung sind drei getrennte Kriterien.
Bei einem Timeout behalten Sie vorhandene Request- oder Interaktions-IDs und prüfen vor dem Retry den Dienststatus. Ein clientseitiger Timeout beweist nicht, dass der Server die Arbeit beendet hat.
Offline-Kit ausführen und seine Grenzen verstehen
Laden Sie das Hydrogen-Migrationskit herunter, entpacken Sie es und wechseln Sie in hydrogen-migration-kit. Die README des Kits ist auf Englisch. Verwenden Sie Python 3.11 oder neuer für beide Werkzeuge. Das Request-Audit selbst braucht nur die Standardbibliothek:
python -m unittest test_audit.py -v
python migration_audit.py source-request.json
python migration_audit.py hydrogen-request.json
Erwartet werden 21 bestandene Tests. Der Auditor schreibt die Datei nicht um, sondern gibt eine unveränderte Kopie mit Blockern und Prüfpunkten aus. Exit-Code 2 bedeutet Blocker; 0 bedeutet lediglich, dass dieser begrenzte Audit keinen Blocker gefunden hat. Das ist keine Freigabe für den Rollout. Auch das Zielbeispiel benötigt die Anwendungsbewertung und eine Prüfung seines absichtlich begrenzten Ausgabebudgets.
Geprüft werden vollständige initiale Interactions-Requests: fremde Protokollstrukturen, fehlende Eingaben, explizite Cache-Abhängigkeiten, ungültige Denkstufen, fehlerhafte Ausgabelimits und widersprüchliche Speicher-/Hintergrundparameter. Auch durch Standardwerte verborgene Änderungen werden markiert. Der Auditor rekonstruiert keine Dokumente, liest keinen Serververlauf, bestätigt keine Kontorechte und validiert nicht jedes mögliche API-Feld.
Die Ausgabe enthält eine vollständige Kopie des Requests. Beginnen Sie mit dem unkritischen Beispiel und vermeiden Sie vertrauliche Prompts in gemeinsam genutzten Terminal-Logs. Ein API-Schlüssel gehört nicht in das Request-JSON.
Für den separaten SDK-Serialisierungstest legen Sie eine isolierte Umgebung an:
python -m venv .venv
source .venv/bin/activate
python -m pip install 'google-genai==3.3.0' httpx
python sdk_wire_check.py
Unter Windows PowerShell aktivieren Sie mit .venv\Scripts\Activate.ps1. Die Installation lädt Pakete herunter; der Test selbst nutzt einen ausdrücklich erfundenen Schlüssel und httpx.MockTransport, liest keine Zugangsdaten aus der Umgebung und sendet keinen Modellrequest.
Das Skript serialisiert zwei GenerateContent-Requests mit dem installierten SDK. Es prüft identische drei Verlaufsturns, Tool-Deklarationen und zwei Tool-Antworten. Der Modellturn enthält zwei parallele Funktionsaufrufe; eine synthetische Signatur bleibt auf ihrem ursprünglichen ersten Part und wird nicht auf den zweiten kopiert. Das Ziel setzt Hydrogen und ausdrücklich MEDIUM. Die erfassten Bodies stehen in sdk-wire-requests.json neben dem Skript.
Dies belegt lokale Serialisierung. Synthetische Antwort und Signatur beweisen weder Serverakzeptanz noch eine modellübergreifende Fortsetzung oder einen funktionierenden Tool-Executor. Die Prüfung findet unbeabsichtigten Verlaufsverlust vor einer echten Bewertung, ersetzt diese aber nicht.
Cache-Inhalte rekonstruieren und Gesprächszustand erhalten
Eine explizite Cache-ID ist ein Verweis, kein Dokument. Entfernen Sie cached_content oder cachedContent, kann der Request einfacher aussehen, während wesentliche Materialien fehlen. Googles Cache-Dokumentation unterscheidet implizite Wiederverwendung von explizit verwalteten Ressourcen. Implizites Caching rekonstruiert keine fehlende Eingabe.
Für jede cacheabhängige Aufgabe:
- Finden Sie die ursprünglichen Systemanweisungen, Dokumente, Medienreferenzen und Tool-Deklarationen, mit denen die Anwendung den Cache erstellt hat. Sind sie nicht wiederherstellbar, stoppen Sie diesen Migrationsfall; ein leerer Ersatz ist nicht gleichwertig.
- Erfassen Sie Versionen und Reihenfolge. Prüfen Sie, ob externe Dateien für Zielkonto und Request-Pfad weiterhin zugänglich sind.
- Bauen Sie einen vollständigen Request mit den Feldern Ihres Protokolls. Erhalten Sie System-/Benutzerrollen und Tools; legen Sie nicht alles in eine Benutzernachricht, nur um die Cache-ID zu entfernen.
- Berechnen Sie den rekonstruierten Kontext gegen das gemeinsame Hydrogen-Budget neu und lassen Sie Platz für Denken und Antwort. Teilen Sie die Aufgabe bei Bedarf.
- Stellen Sie eine Frage, die eine bekannte Information aus den wiederhergestellten Materialien benötigt. Prüfen Sie die exakte Antwort, bevor Sie den alten Cache-Pfad außer Betrieb nehmen.
Der Gesprächszustand ist separat zu entscheiden. In Interactions kann previous_interaction_id auf eine gespeicherte frühere Interaktion verweisen. store=false im aktuellen Request verhindert nicht automatisch das Lesen früher gespeicherten Zustands, speichert aber das neue Ergebnis nicht für spätere Fortsetzungen. Hintergrundausführung ist mit store=false unvereinbar. Leiten Sie aus einer vorhandenen ID keine modellübergreifende Unterstützung ab; testen Sie Konto und Modellkombination oder starten Sie einen neuen kleinen Testdialog mit explizit rekonstruiertem Kontext.
Bei zustandsloser Fortsetzung behalten Sie die vollständige geforderte Reihenfolge einschließlich Denk-Schritten und Signaturen integrierter Tools. In GenerateContent bleiben Modellinhalt und Parts vollständig in Reihenfolge erhalten, gefolgt von den zugehörigen Tool-Antworten. Der sichtbare Text eines Chats reicht als Verlaufsspeicher nicht aus.
Bei einer fehlenden Thought Signature helfen die Gemini-Anleitung zu Tool-Signaturfehlern (Englisch) und die offiziellen Signaturregeln. Jede Signatur bleibt auf ihrem ursprünglichen Part. Kopieren Sie eine Signatur nicht auf parallele Aufrufe und erfinden Sie keinen Ersatz. Die synthetische Signatur des Kits dient ausschließlich der Offline-Prüfung des Serialisierers.
Tools, Ausgabe und gemeinsames Budget zusammen prüfen
Ein Request kann seinen gesamten Text erhalten und trotzdem Anwendungsverhalten verlieren. Halten Sie Funktionsnamen, Argumentschemata, Berechtigungen, Zuordnung von Aufrufen und Ergebnissen sowie Reihenfolge konsistent. Googles Function-Calling-Anleitung beschreibt das Protokoll; Ihr Executor muss weiterhin entscheiden, welche Aktionen erlaubt sind und ob sie tatsächlich gelungen sind.
Beginnen Sie mit einem lesenden Test, bevor Tools schreiben dürfen. Beispielsweise liefert lookup_record A als ready und B als blocked, und die strukturierte Abschlussantwort muss B identifizieren. Protokollieren Sie Aufruf-IDs, Argumente und Ergebnisse ohne Geheimnisse. Werden zwei Aufrufe erzeugt, liefern Sie zwei passende Ergebnisse, keine freie Zusammenfassung, welche die Zuordnung verliert.
Behandeln Sie Modelloutput als zu prüfende Anwendungsdaten. Validieren Sie beim Datensatzbeispiel erst das Schema, dann die Antwort gegen die bekannten Werte. Bei Schreibaktionen prüfen Sie den tatsächlichen Zielzustand. „Erfolgreich gespeichert“ im Modelltext ist kein Schreibnachweis. Für UI-Ausführung statt Funktionstools erklärt die Computer-Use-Anleitung den zusätzlichen Zyklus aus Beobachten, Freigeben, Ausführen und Prüfen.
Budgetprobleme können wie Aufgabenfehler wirken. Erfassen Sie Eingabe- und Ausgabenutzung, verfügbare Angaben zum Denken, Abschlussstatus und Abbruchsignale. Fehlende Nutzung bleibt unbekannt, nicht null. Enthält die Ausgabesumme des Providers bereits Denken, addieren Sie es nicht erneut. Prüfen Sie die dokumentierten Einheiten vor jeder Kostenableitung.
Für lange Antworten wählen Sie Fortsetzungscontroller oder Hintergrundpfad ausdrücklich und definieren Stopps. Bewahren Sie Wiederaufnahme-IDs auf, wiederholen Sie keine erledigten Seiteneffekte und begrenzen Sie die Gesamtarbeit über alle Schritte. Ein höheres einzelnes Limit ohne angepassten Controller schafft keine zuverlässige Langzeitaufgabe.
Regressionsfälle mit unabhängigen Abnahmekriterien aufbauen
Beginnen Sie mit bereinigten realen Anwendungsfällen, für die Sie die nötigen Rechte haben. Decken Sie Erfolge und bekannte Fehlergrenzen ab. Die Tabelle ist ein reproduzierbarer Testentwurf und enthält keine gemessenen Modellresultate.
| Fall | Konkreter Test | Erfolgskriterium |
|---|---|---|
| Einfache Extraktion | A=ready; B=blocked | Abgeschlossene Antwort enthält nach Parsing nur die blockierte ID B |
| Cache-Wiederherstellung | Dokument enthält release_owner=team_amber, Frage nicht | Nach Wiederherstellung des vollständigen Dokuments lautet die Antwort team_amber |
| Verlaufskontinuität | Erster Turn weist A team_amber zu; nächster fragt nach Zuständigkeit | Richtige Zuständigkeit über den gewählten Zustandsmechanismus |
| Parallele Tools | Zwei lookup_record-Aufrufe für A und B | Zuordnungen bleiben erhalten, keine Doppelausführung, korrektes Endergebnis |
| Kontrollierter Abbruch | Absichtlich zu kleines Ausgabelimit für größere Aufgabe | Anwendung erkennt Unvollständigkeit und verweigert Abnahme |
| Ungültige Konfiguration | Sampling außerhalb des Bereichs oder Speicher-/Hintergrundkonflikt | Passender Fehlerpfad statt bedingungsloser Wiederholung |
| Rollback mit Schreibaktion | Operations-ID vorhanden, Clientantwort unklar | Vor Wiederholung prüft Operator oder Executor den Zielzustand |
Speichern Sie je Lauf Konfigurationsversion, Modell-ID, Prompt-/Fixture-Hash, SDK-Version, Konto oder Routingumgebung, Beginn/Ende, Abschlussstatus, Validierung und verfügbare Nutzung. Vertrauliche Rohantworten unterliegen Ihrer normalen Aufbewahrungsrichtlinie. Vergleichen Sie gleiche Bedingungen und schreiben Sie Verbesserungen nicht nur dem Modell zu, wenn zugleich Prompt, Schema und Executor geändert wurden.
Legen Sie Kriterien vor einer kosten- oder kontingentverbrauchenden Bewertung fest. Schemavalidität und Sicherheit von Seiteneffekten können strikte Anforderungen haben. Genauigkeit, Latenz und Kosten benötigen passende Schwellen und aussagekräftige Stichproben. Dieser Artikel liefert keine universelle Prozentzahl und erklärt sieben Tests nicht zum Zuverlässigkeitsnachweis für Produktion. Untersuchen Sie Abweichungen einzeln, besonders plausible Antworten, die deterministische Prüfungen nicht bestehen.
Schrittweise ausrollen und einen nutzbaren Rollback behalten
Leiten Sie zunächst eine begrenzte Zahl neuer lesender Aufgaben an Hydrogen. Halten Sie Ausgangs- und Zielkonfiguration getrennt wählbar und verwenden Sie dieselben freigegebenen Testversionen. Prüfen Sie Fehler und unvollständige Antworten vor einer Erweiterung. Schreibende Aufgaben kommen erst nach erfolgreicher Prüfung von Executor, Deduplizierung und Zielzustand hinzu.
Korrigieren Sie fehlerhafte Requests, statt identische Eingaben zu wiederholen. Prüfen Sie bei fehlendem Modellzugriff Konto, Route und genaue ID. Vorübergehende Fehler erhalten begrenzte Retries mit Backoff und gespeicherten IDs. Ofox-Aufrufer folgen der dokumentierten Fehler- und Retry-Behandlung. Die Diagnose zu Gemini-4-API-Fehlern hilft beim Trennen von Zugriff, Format und Limits; ihre modellspezifischen Beispiele nutzen allerdings Argon und dürfen nicht als Hydrogen-IDs übernommen werden.
Rollback stellt die Ausgangskonfiguration für geeignete neue Aufgaben wieder her, nicht durch blindes Wiederholen sämtlicher laufender Interaktionen. Pausieren Sie neue Seiteneffekte, identifizieren Sie unklare Operationen, prüfen Sie das Ziel und entscheiden Sie über Fortsetzung, Kompensation oder Neustart. Die alte Route ist nur nutzbar, solange Zugriff und Modellangebot bestehen. Eine gespeicherte Konfiguration überwindet keine Abschaltung oder verlorene Berechtigung.
Die Migration ist bereit, wenn Ihre Anwendung auf der tatsächlichen Route Kontextwiederherstellung, Tool-Zustand, valide Ergebnisse, begrenzte Ausführung und einen geprobten Rollback belegen kann. Bewahren Sie versionierte Nachweise auf, damit spätere Prompt-, SDK- und Provider-Änderungen von diesem Modellwechsel unterscheidbar bleiben.