Gemini 4 Carbon、Hydrogen、Argon 怎么选?按任务和成本判断
编程、Agent 和文档分析该用哪个 Gemini 4?对比 Carbon、Hydrogen、Argon 的接入条件、思考设置与任务成本,用可复算案例和评测表判断何时值得换模型。
 Ofox
新建日常编程或 Agent 工作流,可以先评估 Hydrogen;在输入充分、配置正确的情况下仍解不出的复杂推理问题,再考虑 Carbon。已经用 Argon 跑通且通过验收的工作流,可以继续保留。 不必仅因新模型发布,就迁移一个运转正常的应用。
这是依据 2026 年 11 月 13 日核对的 Google 官方规格给出的选型建议,不是三模型性能实测:本文没有让三个模型在同一测试集上运行。下文的任务说明、成本计算和评测表供你复现自己的比较,不代表我们已经取得的模型成绩。
Hydrogen 比 Carbon 更晚推出,原来“强模型还是便宜模型”的二选一,现在需要增加一个候选。Google 将 Hydrogen 定位为高效执行,Argon 面向比 Carbon 消耗更少推理资源的进阶任务,Carbon 则强调对难题的深入验证。这些定位可以帮助确定测试起点,最终仍应看结果是否通过验收、耗时多少、整项任务花了多少钱。来源为 Google 的 Hydrogen 指南(英文)、Argon 指南(英文)和 Carbon 指南(英文)。
真正影响选择的差异
| 决策项 | Hydrogen | Argon | Carbon |
|---|---|---|---|
| 精确模型 ID | gemini-4-hydrogen | gemini-4-argon | gemini-4-carbon |
| 适合首先评估的任务 | 交互式编程、工具执行、常规多模态任务 | 已经通过验收的现有进阶工作流 | 复杂调试、架构分析、证据综合 |
| 思考档位 | low、medium、high、xhigh | low、medium、high | low、medium、high |
| 默认思考档位 | high | medium | medium |
| Gemini API 免费层 | 有,受资格与配额约束 | 无 | 无 |
| 共享上下文预算 | 1,048,576 token | 1,048,576 token | 1,048,576 token |
| 什么时候考虑更换 | 补齐上下文、修好工具后仍反复发生推理错误 | 代表性评测证明另一个模型更符合要求 | 更多推理时间和 token 消耗没有改善验收结果 |
表里的任务建议是编辑判断,不意味着 Argon 一定强于 Hydrogen,也不意味着 Carbon 能拿下每个难题。模型名称、规模和发布先后,都不能直接推出通用排名。
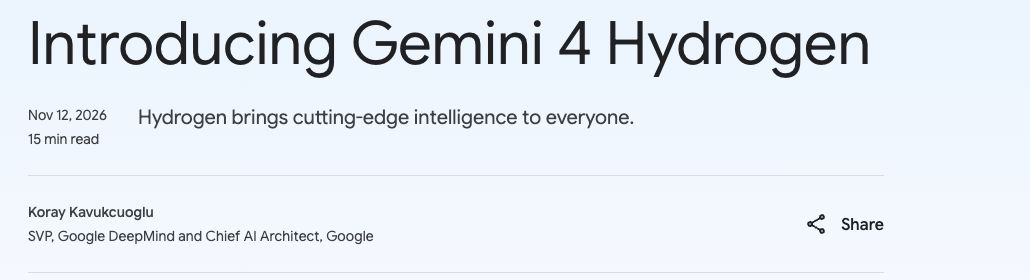
截图采集于 2026 年 11 月 13 日,展示官方发布背景。它不是 Ofox 接入截图,也不是模型实测结果。查看英文原公告。
三者共有的能力,不构成升级 Carbon 的理由
三个模型都接收多模态材料、输出文本。规格中均列有函数调用、结构化输出和 Computer Use 等能力。能够接收图片或视频,不等于能够生成图片或视频。如果最终交付物是图片、视频或语音,应选择对应的生成模型,而不是试图用更高思考档位解锁这些输出。
更大的模型也不会自动补齐应用缺少的执行环境。工具调用只是在提出操作;程序仍要执行工具、返回结果、处理异常,并落实用户权限。界面自动化同样需要区分模型给出的动作与负责截图、点击的客户端。这一分工可参考Computer Use 控制器说明。
接入前应核对 Hydrogen、Argon和 Carbon 的英文规格。Google 原生 API 支持的功能,不等于第三方网关或每个客户端 SDK 都已经支持。
百万上下文不是“百万输入再加百万输出”
输入、思考和输出共同使用 1,048,576 token 的窗口。输入占用越多,留给推理与答案的空间就越少。常规同步请求的预算,也不能直接等同于模型最长的连续生成能力。
Google 文档给出的默认思考与输出预算为 65,536 token;更长生成需要相应的续传或后台执行机制。原始 HTTP 单次响应限制与 SDK 的续传行为有差别,不能假设每次非流式请求都会返回 65K 可见文字或 token。准备生成长篇内容时,先阅读长输出指南(英文)。
做有来源依据的报告,应该先删除无关输入、定义交付物。如果请求已经没有可用输出空间,换 Carbon 也无法修复预算设计。
按需要验收的任务选择
开发一个功能,或交互式网页应用
新工作流可以先评估 Hydrogen。有效的功能需求应有清楚的改动范围、可运行仓库、明确测试和完成条件。这样才能判断模型真的交付了功能,而不是只写出看似可信的代码。
例如,让模型开发一个 CSV 上传页面:校验表头、显示无效行、导出修正后的文件。验收至少应确认项目能启动、错误样例会被正确拒绝、导出保留预期列,并且窄屏可以使用。只看截图不够:上传界面再漂亮,如果导出按钮没有连通,任务仍然失败。
如果 Argon 已经稳定完成这个流程,而迁移没有测得收益,就保留它。只有失败源于复杂依赖或设计冲突时,才值得把 Carbon 纳入评估;缺少软件包、浏览器不可用、测试命令写错,应该先修执行环境。
排查跨多个组件反复出现的故障
当问题需要同时分析多个竞争性解释,例如间歇性重试竞态、服务间状态不一致,或修复一个案例却破坏另一个案例,Carbon 是可以考虑的候选。官方强调的深入验证与这类任务相关,但模型仍需要证据。
提供失败测试、最小复现、相关日志,并明确不允许无关重构。要求模型说明故障机制、提交聚焦的补丁,同时指出哪条回归测试会在没有补丁时失败。如果问题尚不可复现,合理的阶段性交付可能是更精确的诊断实验,而非笃定地声称已修复。
升级模型时,应交接当前假设和失败检查。不要仅把“再努力一点”复制给另一个模型。首轮从未拿到相关文件时,补文件可能比换模型更重要。
对比 PDF、表格与相互冲突的来源
材料与输出结构明确时,可以先用 Hydrogen 评估发票金额提取、两份规格表对比或证据表整理。主要难点是来源冲突、定义模糊或跨文档推理时,再评估 Carbon。现有 Argon 流程如果已经可靠地处理这些情况,也仍然是合理选择。
验收要落实到每条陈述:每个数字应附来源文件名及页码或单元格;缺失信息必须明确保留为缺失;总额应在文字回答以外重新计算;相互冲突的数据应分别展示,不能默默求平均。
下面这份任务说明可以原样用于三个模型的同类文档评测:
对比附件中的供应商规格文件。
输出表格,包含:需求项、供应商数值、单位、
来源文件名、页码或单元格引用、尚未解决的冲突。

不要用常识补齐缺失值。
定义不一致的项目分别列出。
表格之后,列出解决冲突所需的最少问题。
成功标准:每个报告值都能追溯到提供的文件。
这是一份建议使用的评测提示词,不代表某个模型已经完成任务,也不表示它输出的表格可以免于复核。
多步骤工具工作流
模型选择与工作流设计应该分开评估。常见流程是“读取来源 → 提取事实 → 调用工具 → 验证结果 → 保存文件”。执行循环可以先评估 Hydrogen;复杂规划或复核阶段可以再评估 Carbon。
只有职责边界清楚时才拆分模型。规划模型交付规格和验收项,执行模型完成限定改动,验证者检查最终文件。增加 Agent 会带来交接 token、重复上下文与协调错误,因此并行不天然更便宜。
不要把不兼容的对话历史原封不动地传给另一个模型或供应商。用明确的文件保存任务状态,再遵循目标 API 对工具调用及结果的要求。若请求在工具轮次之后失败,先检查 Gemini thought signature 的处理方式,不要直接归因于推理能力不足。
比较整项任务成本,而不只是 token 单价
以下为 Google Gemini API Standard 付费层价格,单位为美元/每百万 token,核对日期为 2026 年 11 月 13 日。它们不是 Ofox 价格、订阅价格,也不是 Batch、Flex 或 Priority 报价。输出价格包含思考 token。表内费率与日期均来自 Google 价格页(英文)。
| 模型 | 至 11 月 30 日未缓存输入 | 至 11 月 30 日输出(含思考) | 2026 年 12 月 1 日起输入 | 2026 年 12 月 1 日起输出 |
|---|---|---|---|---|
| Hydrogen | $1.50 | $7.50 | $1.50* | $7.50* |
| Argon | $2.00 | $10.00 | $4.00 | $20.00 |
| Carbon | $2.00 | $10.00 | $4.00 | $20.00 |
所核对来源没有为 Hydrogen 公布同样的 12 月 1 日涨价安排。这不构成其未来永不变价的保证。
Carbon 与 Argon 单价相同,不代表每项任务费用相同。推理长度、跨轮重复输入、失败重试、验收和工具费用都可能改变总账单。这几个模型的 Google API 使用隐式缓存,旧的显式缓存请求不能直接当作通用省钱方案。
未缓存场景可先这样计算:
模型费用 = 未缓存输入 token / 1,000,000 × 输入单价
         + 计费输出 token / 1,000,000 × 输出单价

任务费用 = 所有尝试的模型费用之和
         + 适用的工具、执行环境及其他服务费用
如果采用的 usage 字段已经包含思考,就不要重复计入。应阅读实际调用接口的计费字段定义;有缓存命中时,将缓存输入按对应费率单独计算。
第一个受控案例:用量相同
假设一项完成的任务消耗 100,000 个未缓存输入 token 和 10,000 个计费输出 token,后者包含思考,不使用付费工具。这里是合成用量示例,不是实测工作负载。
- Hydrogen:
0.1 × $1.50 + 0.01 × $7.50 = $0.225。 - Argon 或 Carbon,至 11 月 30 日:
0.1 × $2 + 0.01 × $10 = $0.30。 - Argon 或 Carbon,12 月 1 日起:
0.1 × $4 + 0.01 × $20 = $0.60。
此例只隔离比较单价,无法说明哪个模型会成功,也无法预测实际 token 消耗。
第二个案例:更多推理与重试
输入仍为 100,000 token,假设 Carbon 一次尝试产生 30,000 个计费输出 token。按介绍期费率,这次合成调用为 $0.50;按公布的 12 月费率则为 $1.00。
如果 Hydrogen 尝试三次,每次都消耗第一个案例中的用量,总计为 $0.675。因此,在这组人为设定的条件下,一次成功的 Carbon 尝试在介绍期比三次 Hydrogen 更便宜,而在公布的 12 月价格下更贵。真实重试可能命中缓存、输出长度不同,或因非推理问题失败,所以不能把这里的差额当作预测节省。
应记录的是每项通过验收的任务总成本,包含失败尝试。低 token 单价只有结合可接受的完成率与延迟,才具有实际意义。
修改默认模型前,先做一轮小型评测
用可下载的评测 CSV记录自己的结果。文件只有英文列名和空白行,没有预填模型分数。选择真实工作负载中的代表案例,并包含当前流程至少一个失败案例。
| 测试 | 固定输入 | 验收条件 | 值得记录的失败 |
|---|---|---|---|
| 代码修改 | 同一仓库 commit、问题与样例 | 必要测试通过,无无关行为变化 | 补丁看似合理,回归问题仍在 |
| 文档对比 | 同一批文件与提取结构 | 数值来源有效,总额可核对 | 编造数值、丢失单位、引用无依据 |
| 工具工作流 | 同一工具定义与初始状态 | 工具完成、结果验证、文件能打开 | 无效调用、重复副作用、输出未完成 |
记录精确模型 ID、供应商、客户端版本、思考档位、token 限制、工具配置、耗时、用量与结果。首次使用体验比较可以采用各模型的官方默认设置,但要标为“默认配置比较”:Hydrogen 默认是 high,Carbon 和 Argon 默认是 medium。
第二轮可以统一到共同支持的档位,例如 medium。不过,同名档位并不意味着内部计算量相同。Carbon 和 Argon 没有文档支持的 xhigh 档位,不应为它们传入这个值。
先定义成功条件,再看答案。如果全部通过,就按应用需要的延迟和总成本选。如果某个失败,先区分缺证据、API 请求无效、执行环境故障与推理错误,再决定是否换模型。用足够的案例理解波动;单次回答胜出不能建立可靠的总体排名。
先检查接入与集成,再归因于模型
Google API 层级、Gemini 应用订阅、Antigravity 订阅以及第三方 API 余额,是不同的接入机制。消费端产品出现某个模型,不证明当前 API 项目能调用它。Hydrogen 的免费 API 层,也不意味着不限次数或与付费层拥有完全相同的工具访问权限。
遇到接入或请求问题,可以参考已有的 Argon 接入指南和 Gemini API 报错排查,再核对当前模型自己的条件。旧文章有明确版本与日期,不能把其中接入细节不加检查地套到 Hydrogen 或 Carbon。
使用 Ofox 时,以账号实际显示的模型和协议为起点。本文不证明三个模型及所有 Google 原生功能都已通过 Ofox 提供。原生协议接入参考 Ofox Gemini API 文档,验证请求时参考错误处理指南。一次文本响应成功,并不代表流式、结构化输出或完整工具往返都通过验收。
新应用的下一步,是保存一个有边界的 Hydrogen 任务输入和验收条件。已有 Argon 应用则保留工作正常的版本作为基线。对于已经确认属于推理难题的失败案例,再评估 Carbon,并仅在验收结果值得额外时间与费用时保留它。