Opus 5.5 영상 프로젝트에 내레이션과 자막을 맞춰 넣는 방법
Opus 5.5로 만든 Remotion 프로젝트에 내레이션과 문장 단위 자막을 맞춰 넣습니다. 작동하는 MP4, WAV, SRT, 소스를 제공하고 타이밍 점검법과 싱크가 어긋날 때의 해결법을 정리했습니다.
 Ofox
Opus 5.5 영상에 보이스오버와 자막을 넣을 때는 오디오 타이밍을 프로젝트 데이터로 다루세요. 내레이션을 합성하거나 녹음하고, 길이를 측정하고, 문장마다 타임라인에 배치한 뒤 오디오와 자막을 함께 렌더링합니다. 실제 타이밍 정보 없이 모델에게 “자막 싱크를 맞춰 줘”라고만 요청해서는 부족합니다.
이 튜토리얼은 제품 데모 튜토리얼과 같은 실제 스크린샷 프로젝트를 사용합니다. 그 글을 먼저 끝내지 않아도 내려받은 파일로 바로 시작할 수 있습니다. 목표는 읽기 쉬운 문장 자막과 편집 가능한 타이밍 소스, 별도 SRT를 갖춘 30초 내레이션 MP4입니다. 새 프롬프트 모음이나 검증되지 않은 자동 더빙을 약속하는 글이 아닙니다.
오디오 예제 보고 확인하기
영어 합성 참고 음성을 넣어 Remotion으로 실제 내보낸 결과입니다. 이 음성은 타이밍을 확인하려고 일부러 사용한 것이며, 전문 내레이션 품질을 보여 주기 위한 것이 아닙니다. 자막은 문장 단위로 표시되고 읽을 시간을 포함합니다.
전체 프로젝트, 내레이션 MP4, 참고용 WAV, 영어 SRT를 내려받을 수 있습니다. 다섯 개 언어로 된 글이 모두 이 영어 예제를 함께 사용합니다. 언어별로 오디오를 다섯 번 제작한 것은 아닙니다.
실제 모델 호출에서는 퍼스트파티 Claude Code로 claude-opus-5-5를 실행해 Remotion 코드를 생성했습니다. 모델에는 파일명과 텍스트로 쓴 장면 지시만 전달했으며, 이미지 픽셀이나 오디오 녹음은 전달하지 않았습니다. 그 뒤 실제 원본 캡처를 넣고, eSpeak NG로 참고 음성을 만들고, 코드를 수정해 로컬에서 렌더링했습니다. 이 역할 분담이 튜토리얼의 핵심입니다. Opus는 코드를 썼고, 음성 엔진이 오디오를 만들었으며, Remotion이 최종 파일을 만들었습니다.
상황에 맞는 타이밍 워크플로 고르기
흔히 쓰는 출발점은 두 가지입니다. 대본과 장면 길이를 아직 조정할 수 있다면, 승인된 음성을 먼저 녹음하거나 합성한 뒤 화면을 그 속도에 맞추세요. 이미 승인된 30초 분량에 맞춰야 한다면 장면 구간을 먼저 정하고, 자연스럽게 들어가지 않는 문장은 줄이세요.
이 예제는 두 번째 방식을 따릅니다. 이미 만든 장면 다섯 개에 짧은 문장 다섯 개가 있습니다. 각 오디오 구간은 할당된 자막 구간 안에 들어가야 하며, 종료 시각을 넘는 구간이 있으면 참고 오디오 스크립트가 오류를 냅니다. 이 점검으로 실제로 자주 생기는 싱크 오류를 렌더링 전에 잡을 수 있습니다.
| 출발 자료 | 권장 방식 | 주로 확인할 위험 |
|---|---|---|
| 승인된 연속 내레이션 | 길이를 측정하거나 받아 적은 뒤, 실제 음성에 맞춰 화면과 자막을 배치 | 단어 수로 문장 타이밍을 추측하는 것 |
| 길이가 정해진 제품 영상 | 장면마다 짧은 문장을 쓰고 녹음을 하나씩 측정 | 정해진 컷을 지키려고 문장을 급하게 읽거나 잘라 내는 것 |
| 음성이 있는 기존 영상 | 실제 사운드트랙에서 타임스탬프를 얻은 뒤 검토 | 자동 전사 결과를 검증된 자막 파일로 취급하는 것 |
| 다국어 버전 | 언어마다 다시 녹음하고 타이밍을 새로 맞춤 | 말하는 길이가 달라졌는데 영어 타이밍을 재사용하는 것 |
Remotion의 자막 문서에서 자막 가져오기, 표시, 내보내기 방법을 확인할 수 있습니다. 이 프로젝트는 타이밍을 눈으로 확인하고 검토하기 쉽도록 작은 JSON 문장 일정을 일부러 사용합니다. 자동 전사나 강제 정렬(forced alignment)은 실행하지 않습니다.
제공된 음성으로 시작한 뒤 교체하기
프로젝트를 실행하기 전에 Node.js와 npm을 설치하세요. 아래의 선택 사항인 터미널 미디어 점검에는 ffprobe가 포함된 FFmpeg를 따로 설치해야 합니다. npm ci는 이 셸 명령을 설치하지 않습니다. 선택 사항인 점검 명령을 쓰지 않아도 제공된 npm 스크립트로 렌더링할 수 있습니다.
아카이브 압축을 풀고 루트 폴더에서 프로젝트를 실행합니다.
npm ci
npm startDemoNarrated를 선택합니다. 아카이브에 public/narration.wav가 이미 들어 있으므로 음성 엔진을 설치하거나 음성 서비스를 구매하지 않아도 렌더링할 수 있습니다. 시작 부분의 첫 문장, 13초 무렵의 문서 문장, 27초 무렵의 마지막 문장을 확인하세요.
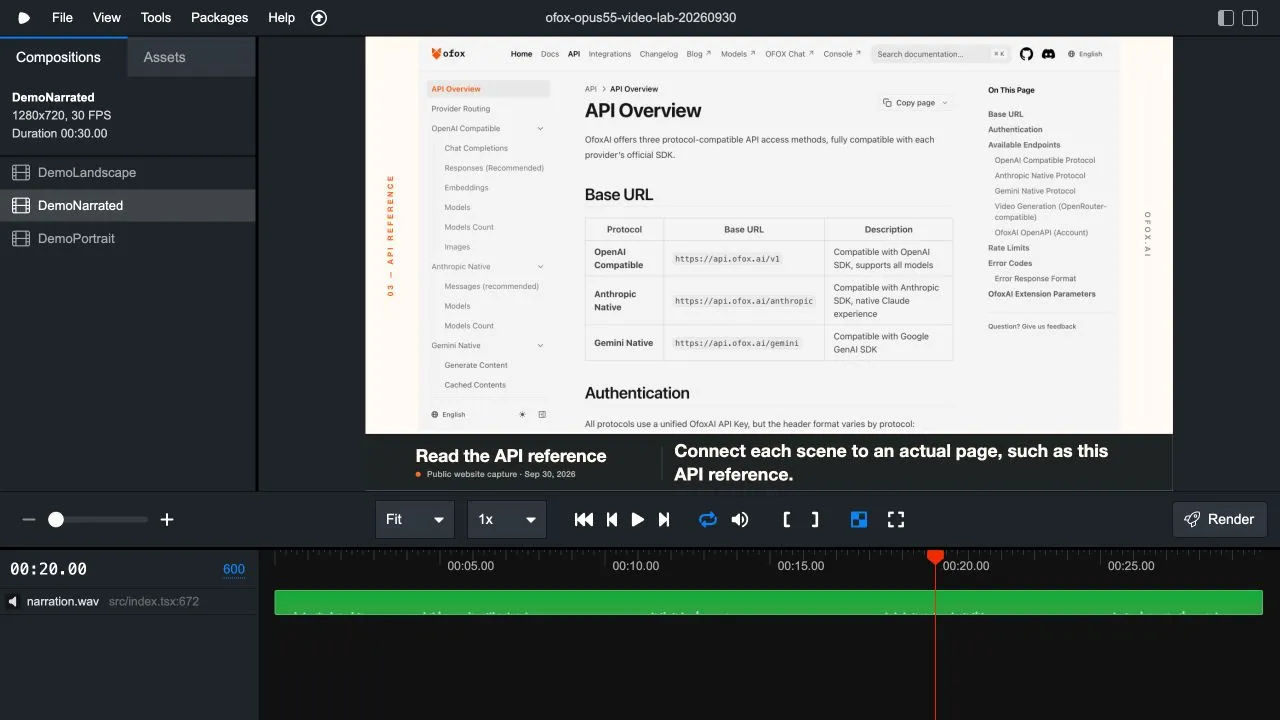
WAV 오디오 트랙이 들어간 실제 프로젝트 미리보기입니다. 파형이 보이면 프로젝트에 오디오가 있다는 것만 알 수 있으며, 발음 품질이나 단어 단위 정렬까지 확인되는 것은 아닙니다.
참고 음성을 직접 재현하려면 공식 문서에 안내된 방법으로 내 시스템에 eSpeak NG를 설치한 뒤 다음을 실행합니다.
python3 scripts/make_audio.py
npm run render:narrated
eSpeak NG 1.52.0, en-us 음성, 분당 190단어 속도 설정을 사용했습니다. 이 포먼트 기반 음성은 일부러 합성음 티가 나게 두었습니다. 최종 내레이션을 고르기 전에 타임라인을 테스트하는 데 유용합니다. 이 숫자는 도구 설정값일 뿐이며, 모든 문장의 말하기 속도가 똑같다는 보장은 아닙니다.
실제 캠페인에는 공개할 권한이 있는 녹음이나 음성 출력을 사용하세요. 제품명, 약어, 문장 부호에서의 쉼, 각 문장의 마지막 단어를 직접 들어 보세요. 대본이 정확해도 음성이 자연스럽게 들리는지는 알 수 없습니다. 이 글에서 측정한 항목은 길이, 배치, 화면에 보이는 자막이며, 사람이 발음이나 전달력을 검토한 결과가 아닙니다.
WAV, 자막, SRT에 같은 일정 사용하기
scripts/make_audio.py를 엽니다. 참고 소스는 LINES 배열이며, 각 항목에는 시작 시각, 자막 종료 시각, 텍스트가 있습니다. 스크립트를 실행하면 30초 WAV, src/captions.json, public/captions.en.srt, audio-timing.json이 생성됩니다. 컴포지션은 생성된 JSON을 불러오므로 영상 코드 안에 손으로 고친 자막 목록을 따로 둘 필요가 없습니다.
측정한 참고 구간은 다음과 같습니다. 이 예제가 공유하는 실제 영어 사운드트랙에서 말하는 문장이므로 영어 원문 그대로 두었습니다.
| 문장 | 시작 | WAV 구간 길이 | 구간 종료 | 자막 종료 |
|---|---|---|---|---|
| A clear product video starts with a clear brief. | 0.35초 | 2.664초 | 3.014초 | 3.60초 |
| Show the real interface. Here, we begin with the model catalog. | 4.35초 | 3.681초 | 8.031초 | 9.80초 |
| Then show where a viewer can find the documentation. | 11.35초 | 2.917초 | 14.267초 | 16.80초 |
| Connect each scene to an actual page, such as this API reference. | 18.35초 | 3.743초 | 22.093초 | 23.80초 |
| Keep the message simple. Plan, build, and verify. | 25.35초 | 3.537초 | 28.887초 | 29.50초 |
이 길이에는 생성된 구간 끝의 샘플까지 포함됩니다. 개별 음소를 측정한 값은 아닙니다. 자막은 일부러 음성이 끝난 뒤에도 조금 더 표시됩니다. 예를 들어 문서 문장은 WAV 구간이 끝난 뒤 약 2.53초 동안 더 읽을 수 있습니다. 자막 타이밍을 더 촘촘하게 맞추고 싶다면 실제 내레이션을 확인한 뒤 이 유지 시간을 줄이세요.
스크립트는 각 구간 앞뒤를 무음으로 채우고, 표에 적힌 절대 시작 시각에 오디오를 배치합니다. 너무 긴 문장을 구간에 억지로 넣으려고 속도를 높이지는 않습니다. 수정한 문장이 구간에 들어가지 않으면 명시적인 오류가 나므로, 렌더링하기 전에 문장을 줄이거나 종료 시각을 옮기세요.
처음부터 끝까지 이어서 녹음한 음성으로 교체한다면 준비 과정이 다릅니다. 전체 길이의 public/narration.wav 파일 하나를 내보낸 뒤, 실제 녹음에 맞게 src/captions.json과 SRT를 수정하세요. 그 녹음을 참고 음성으로 덮어쓸 생각이 아니라면 그 뒤에 make_audio.py를 실행하지 마세요. 원본 녹음과 생성된 예제는 별도 버전으로 저장해 두세요.
초를 프레임으로 정확하게 변환하기
컴포지션은 30 fps로 실행됩니다. 11.35초에 시작하는 자막은 두 영상 프레임 사이에 걸립니다. 최종 코드는 자막이 처음 보이는 프레임을 Math.floor(start * fps)로 계산하므로, 이 문장은 약 11.333초인 340프레임에 나타나 음성보다 아주 조금 먼저 보입니다. 첫 단어를 가릴 수 있는 등장 페이드는 없고, 마지막 6프레임 동안 짧은 퇴장 페이드만 있습니다.
const first = Math.floor(caption.start * fps);
const last = Math.round(caption.end * fps);
const visible = frame >= first && frame < last;
최종 표시 규칙만 보여 주는 코드이며, 전체 컴포넌트에서는 텍스트 레이아웃과 종료 페이드도 설정합니다. 프레임 단위 반올림은 정상적인 동작입니다. 30 fps 영상 타임라인만 보고 샘플 단위로 오디오를 정렬했다고 주장하지 마세요.
제공된 Remotion 4.0.424 프로젝트는 remotion에서 Audio를 가져오고 staticFile로 WAV 경로를 지정합니다. 현재 Remotion 문서는 이 이전 HTML5 컴포넌트를 Html5Audio로 설명하며, 새로 오디오를 연동할 때는 더 새로운 미디어 컴포넌트를 권장합니다. 이 아카이브를 재현할 때는 고정된 버전을 그대로 쓰세요. 최신 문서의 API 변경을 반영하면서 이유를 설명할 수 없는 패키지 업그레이드까지 함께 하지 마세요.
단어를 숨기지 않고 자막을 읽기 쉽게 만들기
가로 컴포지션에서는 스크린샷과 분리된 어두운 띠에 자막이 표시됩니다. 문서와 API 장면에서는 장면 제목이 왼쪽, 문장 자막이 오른쪽에 놓입니다. 세로 버전은 이미지와 자막을 위아래로 쌓습니다. 세로 배치는 세로 영상 튜토리얼을 참고하세요.
영어 자막 글자 크기는 가로에서 28픽셀, 세로에서 30픽셀입니다. 이 프로젝트에서 정한 값일 뿐 소셜 플랫폼 공통 규칙은 아닙니다. 지금 문장 길이는 점검한 레이아웃에 맞습니다. 번역문이 더 길면 들어가지 않을 수 있습니다.
모델이 처음 만든 코드는 CSS line-clamping으로 텍스트를 두 줄까지만 보여 줬습니다. 나중에 문장을 고쳤을 때 세 번째 줄이 아무 경고 없이 사라질 수 있어 이 규칙을 제거했습니다. 자막이 너무 길다면 문장을 나누거나 다르게 쓰거나, 공간을 늘리거나, 레이아웃을 고쳐야 합니다. 넘친 단어를 보이지 않게 숨기는 것은 해결책이 아닙니다.
텍스트를 바꿀 때는 실제 표시 크기에서 첫 자막, 가장 긴 자막, 마지막 자막을 확인하세요. 시스템 대체 폰트 때문에 줄바꿈이 달라질 수 있으며, 이 아카이브는 모든 운영체제에서 똑같은 타이포그래피를 보장하지 않습니다. 브랜드 폰트를 고정해야 한다면 라이선스가 적절한 폰트를 프로젝트에 포함하고, 렌더링 전에 불러온 뒤 같은 점검을 반복하세요.
Opus에게 범위를 정해 타이밍 수정 요청하기
아래 변형용 프롬프트는 내 보이스오버를 직접 측정한 뒤에 쓰면 유용합니다. 자리표시자는 실제 측정 시간으로 바꾸세요. 모델로 추가 테스트를 한 결과는 아닙니다.
기존 DemoNarrated 컴포지션만 수정하세요.
승인된 스크린샷, 30 fps, 현재 장면 순서를 유지하세요.
교체할 내레이션은 public/narration.wav입니다.
다음은 초 단위로 측정한 문장 구간입니다.
[시작, 종료, 실제로 말한 텍스트를 붙여 넣기]

자막 데이터 소스는 하나만 사용하세요. 말한 단어를 하나도 빠뜨리지 마세요.
각 문장은 첫 단어가 들리기 전이나 그 순간에 표시하고, 프레임 반올림 방식을 설명하세요.
단어별 타임스탬프나 자동 전사 결과를 지어내지 마세요.
읽을 시간을 위한 유지 구간은 제가 명시한 곳에만 두세요.
넘치는 텍스트를 line-clamping으로 숨기지 마세요.
문장이 장면 컷을 넘으면 오디오를 몰래 잘라 내지 말고 해당 문장을 알려 주세요.
변경한 파일, 타이밍 전제, 확인해야 할 프레임을 반환하세요.
수정한 뒤에는 텍스트를 내레이션과 비교하고, 이어서 화면을 확인하세요. 카탈로그가 아직 화면에 있는데 API 페이지를 설명하는 문장이 나온다면, 두 파일이 각각은 문제가 없어도 합쳐진 스토리는 틀린 것입니다. 이럴 때는 공통 장면 일정이나 녹음을 고치세요. 자막 오프셋만 바꿔서는 내용이 맞지 않는 내레이션을 고칠 수 없습니다.
실제 파일 내보내기와 문제 진단
npm run render:narrated
ffprobe -v error -show_entries stream=codec_name,codec_type,duration,sample_rate \
  -show_entries format=duration -of json out/narrated.mp4
렌더링된 예제에는 H.264 영상 스트림과 AAC 오디오 스트림이 들어 있습니다. 영상 타임라인은 30초이지만, 압축 오디오는 인코더 패딩 때문에 스트림이나 컨테이너 길이가 약간 다르게 표시될 수 있습니다. 참고 WAV는 정확히 30초입니다. AAC 끝부분의 작은 차이를 장면 길이 오류로 보지 말고, 실제로 들리는 내용과 싱크를 확인하세요.
| 증상 | 확인할 곳 | 해결 방법 |
|---|---|---|
| MP4 전체에 소리가 없음 | 컴포지션, 음소거 플래그, WAV 경로, 스트림 메타데이터 | render:narrated를 사용하고, 오디오 에셋을 확인하고, 음소거 상태로 렌더링하지 않았는지 확인하세요. |
| 모든 문장이 똑같은 만큼 늦음 | 앞부분 무음이나 공통 시작 오프셋 | 오프셋 하나만 고친 뒤 첫 문장과 마지막 문장을 다시 확인하세요. |
| 영상이 진행될수록 어긋남이 커짐 | 잘못된 길이 전제, 오디오 속도, 원본 타임라인 | 실제 녹음을 측정하세요. 단어 수로 추측해 자막을 하나씩 고치지 마세요. |
| 한 문장이 컷을 넘어감 | 해당 문장의 길이와 장면 경계 | 문장을 줄이거나 다시 녹음하세요. 또는 장면을 늘리고 이에 연결된 모든 타이밍을 함께 조정하세요. |
| 화면에서 단어가 빠짐 | 텍스트 줄바꿈과 고정 크기 자막 상자 | 문장을 나누거나 레이아웃 크기를 조정하세요. 넘친 텍스트를 절대 숨기지 마세요. |
| 미리보기에서는 소리가 나지만 최종 파일에는 없음 | 최종 파일과 렌더링 명령 | Studio 파형만 보지 말고 MP4의 오디오 스트림을 확인하세요. |
| SRT와 영상에 입힌 자막이 다름 | 마지막으로 수정한 소스와 재생성 순서 | 같은 일정에서 둘 다 다시 생성하거나, 교체 녹음이라면 두 파일을 모두 직접 수정하세요. |
전달하기 전에 내보낸 파일 전체를 소리와 함께 재생하고, 문장의 시작과 끝을 확인하고, 게시 플랫폼에 올라간 버전도 확인하세요. 영상에 입힌(번인) 자막은 픽셀로 남아 항상 보이지만, 별도 SRT가 보일지는 플랫폼의 지원 여부와 설정에 따라 다릅니다. 이 예제는 두 가지를 모두 제공하지만, 어느 쪽도 소셜 채널에 업로드했다는 뜻은 아닙니다.
오디오 작업과 모델 이용 구분하기
Opus 5.5 모델 항목에서 이 코딩 워크플로와 관련된 모델을 확인할 수 있습니다. 이 예제로 Ofox에 TTS 기능이 있는지, 영상 렌더링에 어떻게 과금되는지 확인된 것은 없습니다. 기록된 모델 호출은 퍼스트파티 Claude Code로 실행했고, 오디오는 로컬에서 만들었습니다.
전체 제작 과정은 메인 Opus 영상 가이드, 원본 자료 선택은 스크린샷 데모 튜토리얼을 참고하세요. 모바일 중심 포맷으로 내보내기 전에는 세로 영상 변환 튜토리얼을 확인하세요. 믿을 수 있는 인수인계 패키지에는 최종 MP4와 WAV, 이에 맞는 자막 파일, 이 파일들을 만든 정확한 프로젝트 버전이 모두 들어 있어야 합니다.
자주 묻는 질문
- Opus 5.5가 내레이션을 만들었나요?
- 아닙니다. Opus는 영상 프로젝트 코드를 생성했습니다. 이 예제는 합성 음성임을 밝힌 eSpeak NG 참고 음성을 사용하며, WAV와 영상은 Remotion이 합칩니다.
- 단어 단위로 싱크를 맞춘 자막인가요?
- 아닙니다. 이 예제는 미리 시간을 정해 둔 문장 자막 다섯 개를 쓰며, 각 오디오 구간 뒤에 읽을 시간을 조금 더 둡니다. 단어 단위 하이라이트를 하려면 실제 단어 타임스탬프와 별도 검증이 필요합니다.
- 영상 디자인을 다시 생성하지 않고 음성만 바꿀 수 있나요?
- 네. 승인된 화면은 그대로 두고 오디오를 교체한 뒤 자막 타이밍을 새 오디오에 맞추면 됩니다. 새 보이스오버가 장면이나 프로젝트 길이를 넘는다면 내보내기 전에 공통 타임라인을 수정하세요.