GPT‑6.1 Sol API 怎么收费?缓存、长上下文与费用计算
按互斥 token 分类计算 GPT‑6.1 Sol API 费用,核对长上下文门槛、处理模式和多轮调用,附离线计算器与可复算示例。
 Ofox
GPT‑6.1 Sol 的 Standard API 标价是每百万输入 token 2 美元、输出 token 10 美元。但只看这两个数字,无法算清 Agent 的预算:缓存读取与写入、长输入、处理模式和工具调用都可能改变账单。本文从单次请求的计算讲到多轮任务对账,重点解决重复计费和遗漏条件的问题。
价格于 2026 年 9 月 30 日核对 OpenAI 模型文档和API 定价页。所有算例均为假设的美元预算,不是真实客户账单或模型实测;也不代表 Ofox 报价或 ChatGPT 套餐积分。
先分清四类 token
| Standard,输入不超过 272,000 token | 美元/百万 token |
|---|---|
| 普通未缓存输入 | 2.00 |
| 缓存读取 | 0.10 |
| 缓存写入 | 2.50 |
| 输出,含计费的推理 token | 10.00 |
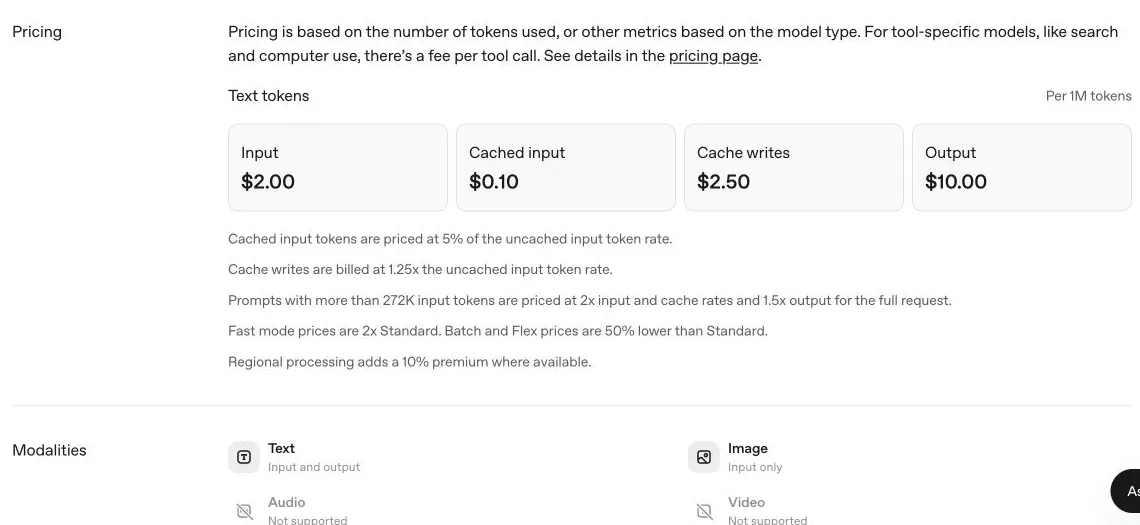
真实的 OpenAI 英文文档截图,只证明公布的费率,不是账单或推理测试结果。
把普通输入记为 U、缓存读取记为 R、缓存写入记为 W、输出记为 O。前三类必须互斥,短上下文 Standard 费用为:
美元 = (2 × U + 0.10 × R + 2.50 × W + 10 × O) / 1,000,000如果接口的总输入字段已包含缓存 token,不能把总输入按 2 美元计算后再加缓存费用。先查该接口 usage 字段含义,再拆成互斥分类。缺少分类字段应记为未知,不能擅自填零。本文的计算器要求显式输入各分类,不会猜测不同供应商返回值的含义。
推理 token 也容易被重复计算。如果输出总量已包含推理 token,再加一次推理明细就会高估;只数可见答案则可能低估。用提供方的计费输出总量算钱,推理明细仅用于解释构成。
超过长上下文门槛,整次请求切换费率
输入超过 272,000 token时,官方对整次请求采用输入及缓存费率的 2 倍、输出费率的 1.5 倍,并非只给超出的部分加价。按这一条件,恰好 272,000 仍属于短档。
| Standard 长上下文分类 | 美元/百万 token |
|---|---|
| 普通输入 | 4.00 |
| 缓存读取 | 0.20 |
| 缓存写入 | 5.00 |
| 输出 | 15.00 |
门槛按完整输入量判断,不能只看未缓存部分。20,000 普通输入加 260,000 缓存读取,共 280,000 输入 token,仍然越过门槛。把它当成只有两万 token 的短请求会算错。
例如,300,000 普通输入加 10,000 输出,费用为 300,000 × 4 / 1M + 10,000 × 15 / 1M = 1.35 美元。若误套短档会得到 0.70 美元。Agent 历史不断增长时,原始用户提问很短也不能保证后续请求仍在短档。
1,050,000 的总上下文窗口不等于可以全部用于输入。模型文档另列最大输入与输出上限。应预留输出容量,把工具定义、工具返回和会话历史计入预算;字符数只能粗估,不能代替真实 token 用量。
四组可复算预算
下表不含税、工具费、存储和区域处理加价,分类与计算器一致。
| 情形 | U | R | W | O | Standard 美元 |
|---|---|---|---|---|---|
| 短请求,无缓存 | 20,000 | 0 | 0 | 5,000 | 0.090 |
| 复用参考材料 | 10,000 | 100,000 | 0 | 5,000 | 0.080 |
| 首次写入缓存 | 10,000 | 0 | 100,000 | 5,000 | 0.320 |
| 长输入,无缓存 | 300,000 | 0 | 0 | 10,000 | 1.350 |
第二、三行是不同请求。尚未建立可复用缓存时,不能把首次写入按读取价计算。假设先写入一次,再命中读取九次,序列费用为 0.32 + 9 × 0.08 = 1.04 美元;若十次都按 110,000 普通输入和 5,000 输出处理,则为 2.70 美元。
差额成立的前提是九次读取实际命中,且分类与账单一致。前缀改变、过期、路由变化或不可缓存请求都可能使假设失效;输出长度也可能不同。因此这是工作负载算例,不是节省承诺。对账时同时记录写入、命中和未命中。
缓存建立后,是否真的能复用
当前缓存文档对 GPT‑5.6 及以后使用 prompt_cache_options.ttl,当前值为 "30m",可缓存前缀至少 1,024 个可见输入 token。缓存会在最近一次写入或复用后至少保留 30 分钟;这是保留条件,不保证改变了内容或无关的请求也会命中。不要照搬旧模型的 prompt_cache_retention: "24h"。
缓存可采用隐式或显式断点;显式模式若没有放置所需断点,就不会写入缓存。把稳定、共享的材料放在易变的请求内容之前,并检查实际缓存用量、计入首次写入成本。两次调用间隔短,或重复了一段文字,都不能单独证明缓存已经命中。
Standard、Fast、Batch 与 Flex 怎么选
官方列出 Fast 为 Standard 的 2 倍,Batch、Flex 各为 Standard 的一半。这些是不同处理模式,不能当优惠券叠加。使用前核对模型、端点与工作负载资格;Batch 不是给普通交互请求自动打折,Flex 也不应被当成与 Standard 拥有完全相同的时延保障。
0.09 美元的短请求,在相同 token 数下 Fast 为 0.18,Batch 或 Flex 为 0.045;1.35 美元的长请求,对应为 2.70 与 0.675。这只是固定用量的费率对照,实际回答的用量可能变化。
适用的区域处理有 10% 加价,只有请求确实采用相应选项时才计入。模型页同时说明 EU 数据驻留不支持 Fast,不能因两个系数分别存在就把不兼容选项组合起来。
使用离线计算器
下载 Python 费用计算器。它只用标准库,不联网,也不需要 API Key。保存后执行:
python3 cost_calculator.py --ordinary 10000 --read 100000 --write 0 --output 5000 --mode standard预期 token 费用为 0.080000 美元。--mode 可改成 fast、batch 或 flex;--regional 用于按适用条件估算区域加价,不会替你验证资格。负数会被拒绝,--region eu --mode fast 这一不兼容组合也会被拒绝。
算术逻辑已做本地测试,但没有在本文中用付费 Sol 请求核对真实账单。脚本费率有日期,不会自动更新;后续使用前应重查官方费率,并保存估算所用版本。脚本只计算 token 费用,不包含工具费,不代表工具免费。它也不校验上下文或输出容量:能算出金额,不代表这份请求符合模型的容量上限。
按任务对账,不只看一条消息
一个用户任务可能包含多次模型请求,每次又带上不同的指令、历史、工具定义和结果。不能拿第一笔费用简单乘以可见消息数。建议逐请求保留:
task_id, request_id, model, timestamp, mode, region,
input_total, ordinary_input, cache_read, cache_write,
output_total, reasoning_detail, tool_type, tool_quantity,
token_estimate_usd, tool_charge_usd, billing_adjustment_usd
每行先确认输入分类之和与总量相符,再单独判断长上下文门槛。输出总量与推理明细分开;按实际工具数量加入对应费率,最后按任务汇总。保存请求 ID 有助于查差异,不必为此存下私密提示词。
对账应包含成功请求、产生了计费用量的失败尝试和重试。不能假定所有失败 HTTP 请求都收费,也不能因用户没收到有用答案就删掉这笔尝试。应以 usage 和账单为据。若要算“每个验收通过任务的成本”,还必须记录最终验收结果。
估算与账单不一致时查什么
先查单位与范围:美元还是积分、每百万还是每千、API 还是套餐、单次请求还是完整任务。再查缓存分类和总输入是否重复计数,然后查输入长度、模式、区域与推理输出。最后检查工具费、重试及供应商调整。
网关可能有自己的价格和字段展示,不能从 OpenAI 费率推导 Ofox 折扣。选提供方前单独核验精确模型与当前目录,把渠道费用与本文官方参考价分开。
模型档位选择可继续看 Sol 与 Astra 对比;迁移应用时结合升级指南与工具调用迁移教程。输入单价只是决策的一部分。