GPT‑6.1 Sol или GPT‑6 Astra: когда оправдана более высокая цена
Сравните характеристики, кэш и длинный контекст Sol и Astra. Рассчитайте бюджет эскалации и задайте проверку результата для кода, исследований и документов.
 Ofox
Обычные входные и выходные токены GPT‑6.1 Sol в Standard стоят в пять раз дешевле, чем у GPT‑6 Astra. Sol поэтому разумно рассматривать для повторяющейся работы. Но это не гарантирует экономию 80% на принятой задаче: длина ответа, неудачные попытки, инструменты и ручное ревью меняют стоимость полезного результата.
OpenAI описывает Sol как близкий к Astra по возможностям для сложной работы при меньшей цене, а Astra оставляет для наиболее требовательных задач. Ниже — решение на основе спецификаций и явно гипотетических расчётов, проверенных 30 сентября 2026 года. Это не парный тест моделей, не доказательство равного качества и не совет заменить Astra во всех случаях.
Что показывает таблица характеристик
| Параметр | GPT‑6.1 Sol | GPT‑6 Astra |
|---|---|---|
| API ID | gpt-6.1-sol | gpt-6-astra |
| Вход / выход | Текст и изображения / текст | Текст и изображения / текст |
| Общее окно | 1 050 000 токенов | 1 050 000 токенов |
| Максимум входа | 922 000 | 922 000 |
| Максимум выхода | 128 000 | 128 000 |
| Срез знаний | 30 апреля 2026 | 30 апреля 2026 |
| Уровни рассуждений API | low, medium, high, xhigh, max | low, medium, high, xhigh, max |
| Короткий Standard, вход/выход, USD за 1 млн | 2 / 10 | 10 / 50 |
| Чтение/запись кэша, USD за 1 млн | 0,10 / 2,50 | 1 / 12,50 |
Источники: Sol, Astra, выбор модели.
Равная вместимость не означает одинакового понимания сложного входа. Окно не гарантирует сохранение всех ограничений, ссылок и зависимостей. Одинаковые имена уровней рассуждений также не доказывают равенство задержки, вычислений или качества. Сравнивайте итоговый артефакт, а не превращайте спецификации в рейтинг.
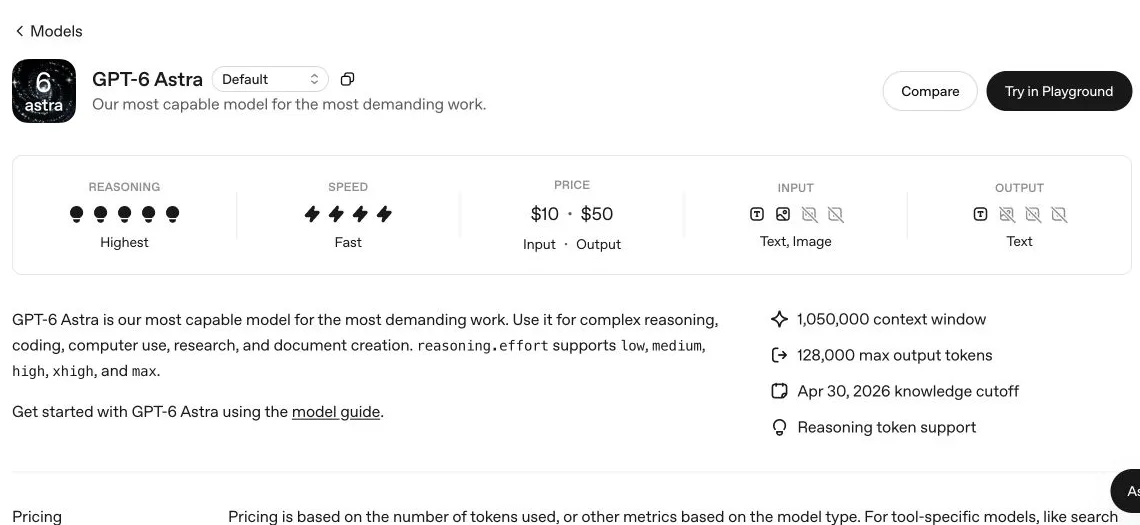
Настоящий снимок англоязычной документации с опубликованными сведениями; сравнительный запуск на нём не показан.
Три ценовых случая
10 000 обычных входных и 2000 выходных токенов стоят у Sol $0.02 + $0.02 = $0.04, у Astra — $0.10 + $0.10 = $0.20. Это короткий Standard API без инструментов, кэша и региональной надбавки. При этих фиксированных количествах разница пятикратная.
Добавим повторное использование: 10 000 обычных, 100 000 прочитанных из кэша и 2000 выходных. Sol стоит $0.02 + $0.01 + $0.02 = $0.05, Astra — $0.10 + $0.10 + $0.10 = $0.30. Соотношение уже шесть, потому что чтение различается в десять раз, остальные ставки — в пять. Первичная запись и промахи не входят в отдельный пример чтения; в реальной последовательности их нужно добавить.
Для 300 000 обычных входных и 10 000 выходных токенов получаются $1.35 и $6.75. Обе модели пересекают порог 272K: для всего запроса вход и кэш умножаются на 2, выход — на 1,5. Короткие ставки или повышенная цена только для превышения здесь неверны.
Это сравнение ставок при одинаковом расходе, а не прогноз токенов. Дополнительные раунды, рассуждения и ручная починка изменят отношение. Перед расчётом стоимости принятой задачи составьте журнал по руководству цен.
Определите недопустимую ошибку
Для узкого изменения кода с чёткими тестами Sol — разумный первый кандидат: есть сигнал приёмки, попытки можно ограничить, ошибку отклонить до публикации. Сохраняйте среду и не расширяйте разрешения из-за смены модели.
Для взаимосвязанных ограничений — межмодульного проектирования, трудного расследования или большой исследовательской сводки — стоит непосредственно оценить Astra. Основание — позиционирование и цена пропущенной ошибки, а не измеренная здесь гарантия успеха. Даже с более сильной по позиционированию моделью нужны проверяемые результаты.
Для документов проверяйте файл и доказательства. Красивый ответ может пропустить раздел, противоречить источнику или придумать число. Если дефекты легко обнаружить, дешёвый первый проход может подойти. Если нужен эксперт, учитывайте его работу вместе с токенами.
| Ситуация | Что попробовать первым | Приёмка |
|---|---|---|
| Повторное извлечение со схемой | Sol сначала | Схема и соответствие источнику |
| Небольшой баг с регрессиями | Sol сначала | Тесты и ограниченный diff |
| Неясный дизайн с дорогой переделкой | Прямое сравнение обеих | Ограничения, эксперт и число правок |
| Большое исследование | Одинаковый набор источников | Поддержка цитат, конфликты и пропуски |
| Значимая запись или деплой | Модель предлагает, приложение исполняет | Соответствующая авторизация |
Это направления эксперимента, не результаты оценки. Разрешения, проверка и откат нужны при любой модели.
Арифметика перехода с Sol на Astra
Пусть попытка Sol стоит Cs, попытка Astra — Ca, а доля p после надёжной проверки отправляется на второй уровень. Для политики максимум по одной попытке на каждом уровне:
Ожидаемые токен-затраты на отправленную задачу = Cs + p × Ca
Дешевле Astra сразу, если p < 1 − Cs / Ca
Для $0.04 и $0.20 порог равен p < 0.80. Если предположить 25% переходов, выходит $0.04 + 0.25 × $0.20 = $0.09 против $0.20 за попытку Astra для каждой задачи. Это гипотеза бюджета, не наблюдавшаяся доля переходов и не доказанная экономия 55%.
Предпосылки могут нарушиться. Повтор Astra получает дополнительную историю и дорожает; проверка пропускает ошибку Sol; Astra тоже не справляется и требует человека или ещё одной попытки. Формула не включает инструменты, задержку и ревью. Отправленная задача не равна принятой, поэтому без исходов это нельзя назвать стоимостью успеха.
Сохраняйте расход первого уровня, причину перехода, расход второго, итог приёмки и ручные исправления. Низкая доля переходов может означать плохой валидатор, а не хорошую модель. Выборочно проверяйте и результаты, которые система уже приняла.
Сначала проверка, затем маршрутизация
Для кода заморозьте синтетический репозиторий или временную ветку и определите поведение тестами. Дайте одинаковые файлы, инструкции и инструменты; запишите модель, настройки рассуждений, клиент, дату и среду. Не совмещайте первое сравнение с посторонними изменениями промпта и среды выполнения.
Требуйте патч и успешное прохождение соответствующих проверок, отсутствие лишних изменений и объяснение, согласующееся с diff. Измеряйте время целиком, выход, инструменты и затраты на проверку. В исследовании замените кодовые тесты обязательными утверждениями, источниками и проверкой конфликтов. Для документа откройте сам экспортированный файл.
Заранее задайте причину эскалации: отсутствующее доказательство, упавшая регрессия, повторяющаяся ошибка инструмента или неразрешённый конфликт требований. Для автоматики «ответ кажется слабым» слишком расплывчато. Передавайте Astra исходную задачу, доверенные материалы и проверенное описание неудачи, а не неподтверждённые выводы Sol как факты.
Ограничьте повторы и предусмотрите конечное состояние «нужна проверка». Эскалация — попытка восстановления, не право работать бесконечно. Откат должен возвращать прежнюю конфигурацию, не удаляя записи оценки.
Ошибки интеграции могут испортить сравнение
Sol требует Responses для инструментов. Неисправная интеграция Chat Completions может выглядеть как слабость модели, хотя запрос не поддерживается. Перед записью неудачи в показатели качества проверьте миграцию инструментов.
Из-за разной накопленной истории только одна попытка может пересечь длинный порог. Сравнивайте реальные количества и фиксируйте тёплый или холодный кэш. Если одному кандидату дали готовый пакет источников, а другой ищет его инструментами, нельзя приписать всю разницу модели.
Наконец, API-доллары и подписка — разные системы. Эти примеры не определяют число задач в вашем Codex-плане; разграничение есть в руководстве доступа. Выбирайте проверенный процесс, соответствующий качеству, времени и общим затратам, а не победителя одной строки таблицы.