GPT‑6.1 Sol или Claude Sonnet 5.5: инструменты, код и стоимость API
Сравнение Sol и Sonnet 5.5 по официальным интерфейсам, кэшу, длинному контексту и условиям задач — с расчётами и без выдуманного рейтинга.
 Ofox
У GPT‑6.1 Sol и Claude Sonnet 5.5 одинаковые Standard-тарифы короткого запроса: 2 доллара за миллион обычных входных и 10 долларов за миллион выходных токенов. Поэтому ответ на вопрос «что дешевле?» зависит от кэша, длины входа, фактического выхода, повторов и стоимости адаптации инструментов.
Это сравнение официальных характеристик, цен и инженерных условий на 30 сентября 2026 года, не сравнительный тест программирования. В расчётах фиксировано число токенов, чтобы выделить разницу ставок; одинаковый текст у разных поставщиков может токенизироваться по-разному. Результат производителя против старой модели не доказывает преимущество одной из этих двух в вашем проекте.
Где условия совпадают, а где различаются
| Условие | GPT‑6.1 Sol | Claude Sonnet 5.5 |
|---|---|---|
| API ID | gpt-6.1-sol | claude-sonnet-5-5 |
| Короткий обычный вход/выход, USD за 1 млн | 2 / 10 | 2 / 10 |
| Чтение кэша | 0,10 | 0,20 |
| Запись для короткого TTL в примерах | 2,50 | 2,50 для 5 минут |
| Другой срок кэша | Текущая документация Sol: TTL 30 минут | Запись на 1 час: 4,00 |
| Длинный вход | Свыше 272K повышаются ставки всего запроса | Стандартные ставки по всему поддерживаемому контексту 1M этого поколения |
| Инструментальный протокол | Responses: вызовы и результаты | Claude: tool-use и tool-result |
| Более простой старт интеграции | Уже проверенный цикл Responses | Уже проверенный Claude-native цикл |
Источники: Sol, кэш OpenAI, анонс Sonnet, цены Anthropic. Для сторонней платформы проверяйте конкретный маршрут: документация нативного API не подтверждает тариф и совместимость шлюза.
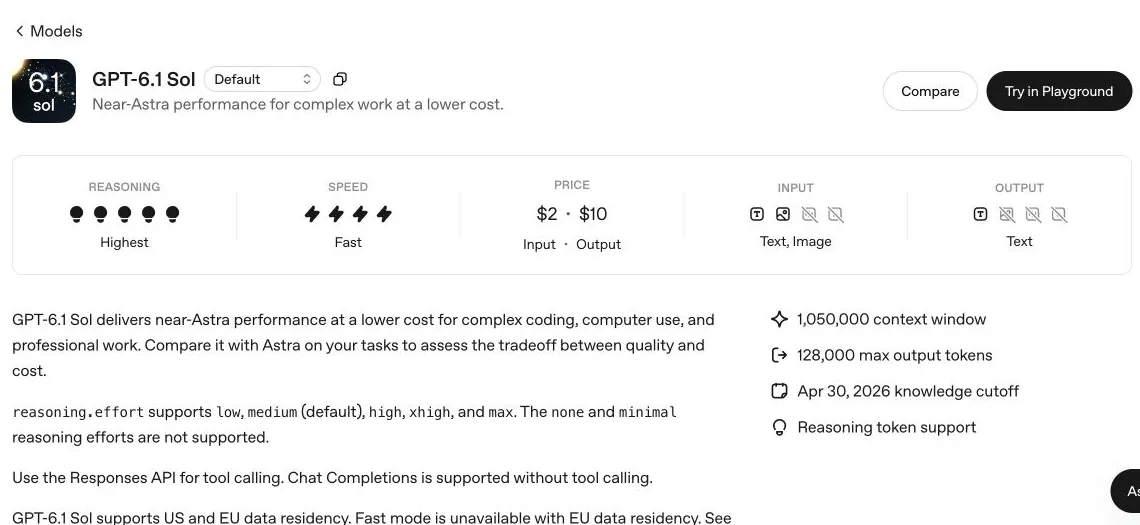
Настоящий снимок документации стороны Sol. Данные Sonnet подтверждены текстовыми источниками Anthropic по ссылкам; это не снимок сравнительного запуска.
Три нагрузки с явными предположениями
Короткий запрос: 20 000 обычных входных и 5 000 выходных токенов. Оба варианта стоят $0.04 + $0.05 = $0.09. По базовому тарифу победителя нет. Дополнительная попытка или больше токенов рассуждений меняют фактическую цену задачи; это нужно измерить, а не вывести из общей ставки.
Повторное использование: 10 000 обычных, 100 000 прочитанных из кэша и 5 000 выходных. Sol: $0.02 + $0.01 + $0.05 = $0.08; Sonnet: $0.02 + $0.02 + $0.05 = $0.09. Чтение Sol вдвое дешевле, но весь запрос дешевле примерно на 11,1%, а не на 50%. Первичная запись исключена; попадания предполагаются реальными.
Для десяти обращений с одной записью 100K-префикса, девятью чтениями, 10K нового входа и 5K выхода в каждом пример Sol даёт $1.04, Sonnet с 5-минутной записью — $1.13. Это предполагает, что чтения укладываются в собственные сроки и правила кэша. Произвольные интервалы между запросами не гарантируют попадания. Часовая запись Sonnet и промахи изменят результат.
Длинный вход: 300 000 обычных и 10 000 выходных токенов. Sol пересекает порог: $1.20 + $0.15 = $1.35. Sonnet в рамках поддерживаемого контекста: $0.60 + $0.10 = $0.70. Это важное ценовое условие для документов, но не свидетельство одинаковой точности извлечения. Определения инструментов и резерв ответа тоже должны помещаться в лимиты.
Короткий diff, повторяющаяся справочная база и большой снимок репозитория — разные нагрузки. Один процент для всех трёх скрывает исходные условия.
Начните с уже проверенного набора инструментов
Если приложение построено на корректном многошаговом Responses-цикле, Sol — естественный первый кандидат из-за меньшего объёма адаптации. Но проверьте ограничения: старый Chat Completions-адаптер с инструментами может не работать. Полный пример миграции показывает элементы ответа, call_id и ограниченный диспетчер.
Если продакшен уже использует инструменты Claude, начать с Sonnet может быть проще. При смене провайдера сверяют схемы, события ответа, состояние и кэш. Совместимый шлюз может переводить часть протокола, однако сам перевод становится объектом тестирования. Успешный текстовый запрос не доказывает работоспособность инструментов.
Инженерные затраты считайте отдельно от токенов. При небольшом трафике проверка нового протокола может стоить больше скромной разницы чтения кэша. У массового сервиса вывод может быть другим. Используйте собственные объёмы и оценки труда, а не вымышленные ставки разработчиков или сроки миграции.
Выбор зависит от задачи и проверки
| Ситуация | Первый разумный эксперимент | Что подтвердить |
|---|---|---|
| Responses-агент исправляет небольшие ошибки | Sol в прежней среде выполнения | Регрессии, результаты инструментов, затраты на проверку |
| Claude-процесс для кода и документов | Sonnet в том же процессе | Принятые изменения или файлы, отсутствие пропусков |
| Большой некэшированный вход | Оба с правильной ценой длинного контекста | Опора на источники, пропуски, полный расход |
| Много повторного контекста | Сравнить фактическую долю попаданий в кэш и задачу целиком | Записи, чтения, промахи, выход, повторы |
| Необратимое действие | Сначала предложение только для чтения | Авторизация и корректность действия |
Это исходные эксперименты, выведенные из условий интеграции, а не измеренные преимущества. Anthropic позиционирует Sonnet для чётких повседневных задач, исправления ошибок и документов; OpenAI — Sol для сложной работы дешевле Astra. Позиционирование помогает составить проверку, но не заменяет её.
Проценты ускорения и экономии в анонсе Sonnet относятся к Sonnet 5, а не к GPT‑6.1 Sol. Формулировка «near-Astra» тоже не даёт результата против Sonnet. Мы не собираем рейтинг из оценок с разными инструментами и бюджетами рассуждений: такой ряд чисел выглядел бы сопоставимее, чем он есть.
Воспроизводимый протокол сравнения
Подготовьте задачи, которые действительно принимаете: исправление падающего теста, небольшую функцию с ограничениями, рефакторинг с регрессиями и документ с проверяемыми источниками. Используйте временную ветку или синтетический репозиторий. Удалите секреты и закрытые данные клиентов перед внешним вызовом.
Дайте обеим системам одинаковые файлы, разрешения, критерии приёмки и условие остановки. Запишите модель, клиент/поставщика, дату, настройки рассуждений, инструкции и среду. Одинаковое название уровня рассуждений у двух компаний не означает одинаковые вычисления — публикуйте конкретные настройки.
Сначала оцените пригодность результата. Для кода выполните тесты и проверьте diff на лишние изменения, обработку ошибок и чувствительные действия. Для документов проверяйте разделы, доказательства и сам экспортированный файл. Затем фиксируйте токены, инструменты, время, повторы и ручные исправления. Сообщение «готово» не заменяет приёмку.
Повторите достаточно представительных задач, укажите размер выборки и сохраните неудачи. Небольшой пилот может обосновать локальное решение, но не звание «лучшей модели для кода». Оставьте откат и повторяйте оценку после обновления модели или среды выполнения, иначе улучшение инструмента можно ошибочно приписать модели.
Практическое решение
При одинаковой короткой цене и отсутствии доказанной выгоды начните с модели, подходящей проверенному стеку. Для крупных некэшированных входов отдельно оцените Sonnet; для кэшированных Responses-процессов — Sol с учётом записей и промахов. Маршрутизация между моделями оправдана только при надёжном выявлении ошибок и подтверждённой пользе, превышающей сложность эксплуатации.
Без критерия приёмки вторая модель не решит проблему оценки. Сначала создайте проверяемую задачу. Для более трудной работы внутри OpenAI смотрите Sol против Astra, для условий оплаты — расчёт API. Доступность, тарифы и протоколы Ofox проверяются отдельно; здесь нет обещания скидки или совместимости.