Запуск GLM 5.2 локально (2026): 2-bit на 256 GB Mac или коробке с 4090
GLM 5.2 (753B) на своём железе: 2-bit влезает в Mac Studio на 256 GB, 4-bit просит 512 GB, ~3-9 tok/s. GGUF-кванты для llama.cpp, LM Studio и 4090.
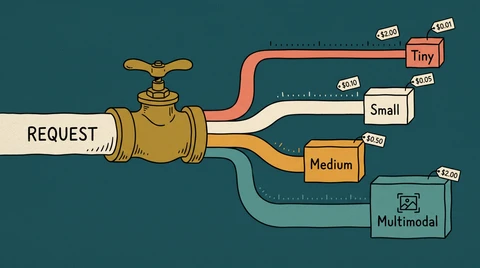
Маршрутизация GLM-5.2, DeepSeek V4, MiniMax M3 и Kimi K2.6 через один API (2026)
Четыре модели за одним ключом ofox: blended от $0.19 до $2.40 за M, разрыв 12.86x. На 1000 задач в день счёт падает с $4205 до $1453. Python и Node.
GLM-5.2 против GPT-5.5: стоимость токенов при 10K/100K/1M запросов в день (2026)
GLM-5.2 ($1.4/$4.4 за M) против GPT-5.5 ($5/$30): blended $2.40 против $13.33 за M, соотношение 5.56x.
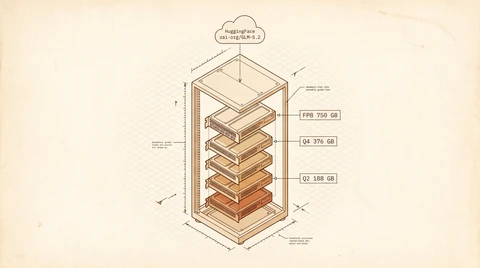
GLM 5.2 на своём железе в 2026: оборудование, vLLM и сравнение цен с облаком
Self-host GLM 5.2 (753B MIT, контекст 1M): 8x H200 на vLLM FP8, 4x H100 на Q4 GGUF или Mac Studio на 2-bit.
Codex недельный лимит: 5 способов и API drop-in с потолком (2026)
Лимит Codex упал с 96% до 0% за день? Пять решений: банк сбросов, реферальные кредиты, drop-in API, предоплаченный потолок и downgrade тарифа.
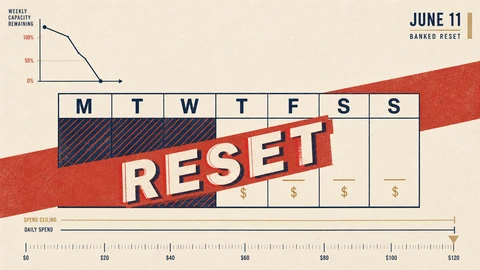
Codex недельный лимит: 7 решений и drop-in API (2026)
Время сброса Codex приходит от сервера как метка resetsAt, а не по правилу часов. Как прочитать её самому и чем продолжить работу без простоя.
DeepSeek V3.2 prompt caching в ofox: 10 минут, до 80% экономии (2026)
DeepSeek V3.2: cache read $0.06/M против $0.29/M miss (в 4.8× дешевле), output $0.43/M, контекст 128K. Настройка в ofox за 10 минут.
Как получить доступ к GLM 5.2: цены, настройка API и план открытых весов MIT (2026)
Zhipu объявила о GLM 5.2 13 июня 2026 — контекст 1M токенов, MoE на 753B общих параметров, Coding Plan за $10–$80 в месяц.
MiniMax M3 vs Claude Opus 4.8: SWE-Bench и цена в 10× (2026)
MiniMax M3 — 59% на SWE-Bench Pro, Claude Opus 4.8 — 69,2%. M3 в 10 раз дешевле за токен, у обоих 1M контекста.
Claude Code /cd: смена директории без потери prompt cache (v2.1.169)
/cd в Claude Code меняет рабочую директорию и сохраняет prompt cache со скидкой 90% на вход. Три кейса, где кэш молча умирает: CLAUDE.md, MCP, /add-dir.