Как выбрать порог confidence для Jev на своих данных
Проверьте confidence Jev с помощью готового Python-скрипта: измерьте ошибки среди принятых решений, охват и нагрузку на резервный путь перед выбором порога.
 Ofox
Выбирайте порог confidence для Jev, измеряя на размеченных данных ошибки среди принятых решений и долю принимаемого трафика. Не назначайте 0,8 или 0,9 просто потому, что число выглядит убедительно. Порог имеет смысл только тогда, когда определены вопрос, версия модели, входящая совокупность и поведение резервного пути.
В этом руководстве есть офлайн-скрипт оценки, искусственный тестовый набор с известными ответами и порядок перехода от существующих логов Jev к отложенному тесту. Он предназначен для вопроса классификации типа Choice, например распределения запросов по очередям поддержки. Здесь нет реальных вызовов API, измерения точности Jev или подтверждения допустимости автоматических решений с серьёзными последствиями. Если вы ещё не собрали ответы, начните с руководства по API Jev.
Разберитесь, к какому числу применяется порог
Официальный API различает вероятности ответов и confidence. Для Choice с n вариантами документированная формула confidence — (n × p_max − 1) / (n − 1). При трёх вариантах и максимальной вероятности 0,8 значение confidence равно 0,7. Поэтому одинаковые численные пороги на этих двух полях не взаимозаменяемы. Справка TypeSafe о confidence.
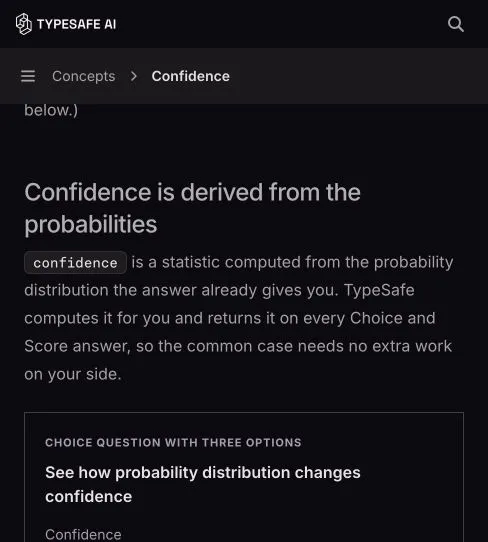
Снимок оригинальной документации от 2 октября 2026 года. Здесь показано определение поля, а не доказательство работоспособности порога на ваших данных.
В Score используется другой расчёт, учитывающий расстояния между упорядоченными уровнями. Noul возвращает вероятность «да» без отдельного поля confidence. Не сводите все три типа к одной колонке «уверенность» с единым порогом. CSV в этом руководстве предполагает возвращённый confidence типа Choice для одного фиксированного вопроса.
Далее нужно раздельно измерять два свойства. Калибровка показывает, соответствуют ли предсказанные вероятности наблюдаемым исходам в группах случаев. Оценка с отбором показывает, как часто принятые решения ошибочны при выбранном пороге. Доля ошибок среди принятых решений может выглядеть хорошо даже при плохо откалиброванных вероятностях, особенно если почти весь трафик уходит на резервный путь.
Определите условия приёмки до просмотра результатов
Предположим, приложение распределяет обращения по категориям billing, technical и other. Правильная классификация — совпадение с независимо присвоенной меткой. Если обращение неполно, противоречиво или выходит за рамки категорий, процесс эталонной разметки должен определять дальнейшее действие. Иначе вы будете поощрять модель за угадывание ответа, который сами проверяющие не могут обосновать.
Запишите максимальную допустимую долю ошибок, минимальный объём принимаемого трафика, бюджет задержки и ошибки, требующие отдельной проверки. Это решения вашего приложения, а не числа, предоставленные Jev. Обратимое назначение очереди и необратимое действие не должны получать одно правило приёмки только потому, что оба возвращают метку.
Используйте инструкцию по разметке с примерами и разрешайте разногласия проверяющих до оценки ответов модели. По возможности скрывайте предсказание от разметчиков. Если они сначала увидят ответ модели, полученная «эталонная истина» может незаметно превратиться в согласие с моделью вместо независимого подтверждения.
Разделите разработку, валидацию и итоговый тест
На примерах для разработки улучшайте вопрос и определения категорий. На валидационной выборке сравнивайте пороги-кандидаты. Зафиксируйте и вопрос, и порог до запуска итогового отложенного теста. Если снова и снова менять порог после просмотра итоговых результатов, этот набор превращается в ещё одну валидационную выборку.
Разделяйте данные по разговорам, клиентским документам или семействам шаблонов, если связанные строки могут попасть в разные наборы. Включайте обычный трафик и важные пограничные случаи, но показывайте результаты раздельно, если доля пограничных случаев намеренно завышена. Сохраняйте группы по языку и длине входа, чтобы хорошее среднее не скрывало неподдерживаемую подгруппу.
Универсального размера выборки, делающего развёртывание безопасным, нет. В частности, отсутствие ошибок среди нескольких принятых случаев почти ничего не доказывает. В качестве грубой статистической иллюстрации: при независимых испытаниях и нуле наблюдаемых ошибок «правило трёх» даёт приблизительную верхнюю границу ошибки с уровнем 95%: 3 / accepted_count. Это приближение для планирования, а не сертификат: корреляция случаев, смещение отбора и изменение распределения могут сделать интерпретацию неверной. Для формальных выводов выберите подходящий интервал и схему выборки вместе с ответственным за оценку.
Подготовьте CSV для фиксированного вопроса
Скачайте и распакуйте набор инструментов для Jev. Нужен Python 3; скрипты используют только стандартную библиотеку. Ключ и доступ к сети не требуются.
В приложенном файле пять колонок:
| Колонка | Значение | Правило проверки |
|---|---|---|
id | Уникальный идентификатор примера | Обязателен и уникален |
gold | Независимо присвоенная категория | Обязательна, в том числе для неудачных запросов |
predicted | Возвращённая метка Choice | Обязательна при статусе ok |
confidence | Возвращённый confidence Choice | Конечное число от 0 до 1 при статусе ok |
status | ok или error | Ошибки остаются в общем трафике и всегда идут на резервный путь |
Сохраняйте фактическую модель из ответа, ID запроса, полную карту вероятностей, версию вопроса и разбиение исходных данных в отдельном манифесте трассировки, связанном по id. Небольшой скрипт оценки не проверяет эти метаданные. Не объединяйте несколько версий модели или вопросов в один CSV, чтобы затем описать результат как одно проверенное правило.
Ниже часть приложенного искусственного набора, составленного вручную, а не ответ Jev:
id,gold,predicted,confidence,status
case-1,billing,billing,0.98,ok
case-2,technical,technical,0.94,ok
case-3,billing,technical,0.91,ok
Для своего файла копируйте поля из сохранённых ответов без округления перед применением порога. Неудачные запросы оставляйте строками error с пустыми предсказанием и confidence. Удаление тайм-аутов искусственно завышает видимый охват.
Запустите скрипт и проверьте арифметику
Из распакованной папки выполните:
python3 evaluate.py synthetic.csv
python3 evaluate.py synthetic.csv --thresholds 0.8 0.9
Мы выполнили первую команду локально на восьми приложенных искусственных примерах. Результат проверяет логику калькулятора, а не измеряет качество Jev:
| Порог | Принято / все случаи | Ошибки среди принятых | Охват | Доля ошибок среди принятых |
|---|---|---|---|---|
| 0,50 | 6 / 8 | 2 | 75% | 33,33% |
| 0,80 | 5 / 8 | 1 | 62,5% | 20% |
| 0,90 | 3 / 8 | 1 | 37,5% | 33,33% |
| 0,95 | 1 / 8 | 0 | 12,5% | 0% |
Охват равен accepted / all eligible cases; доля ошибок среди принятых — wrong accepted / accepted. Если не принят ни один случай, скрипт возвращает null для доли ошибок, а не создаёт видимость идеальной точности.
Обратите внимание: переход с 0,80 на 0,90 в этом наборе ухудшает наблюдаемую долю ошибок. Более высокий порог не гарантирует монотонного улучшения на конечной выборке. В строке 0,95 ошибок нет, но принят всего один случай — этого недостаточно для вывода о надёжности. Эти специально подобранные примеры помогают заметить два частых ошибочных прочтения до работы с настоящими данными.
Выберите правило и проверьте всю цепочку
На валидационных данных изучите строки-кандидаты и конкретные ошибочные принятые решения. Исключите правила, нарушающие ваши ограничения по ошибкам. Для оставшихся оцените охват, пропускную способность резервного пути, стоимость и задержку. Если ни одно не отвечает требованиям, вывод — «пока не автоматизировать этот вопрос», а не «выбрать наименее плохое число».
Затем зафиксируйте выбранный порог и один раз оцените его на отложенных данных. Проверьте и резервный путь: передача решения с низким confidence другой модели или человеку ещё не означает успех. Оценивайте весь процесс, включая недоступные обработчики и случаи, которые так и не завершились.
Консервативная схема правила:
if response_error or label_not_allowed or confidence_invalid:
    fallback()
elif confidence < validated_threshold:
    fallback()
else:
    enforce_permissions_and_business_rules()
    route_to_handler()
Это псевдокод приложения, а не исполняемый пример SDK Jev. До сравнения отклоняйте отсутствующий confidence, неконечные значения и числа вне диапазона: NaN не должен проходить численную проверку порога. Авторизация, проверка входных данных и бизнес-правила остаются в вашем коде. Высокий confidence не должен их обходить. Если действие по выбранному маршруту имеет побочные эффекты, применяйте те же механизмы идемпотентности и подтверждения, что требуются в обычном процессе.
Разбирайте сбои, а не скрывайте их
| Наблюдение | Что проверить дальше |
|---|---|
| CSV отклонён | Повторяющиеся ID, отсутствующие метки, неконечные значения и неподдерживаемые строки статуса; исправьте экспорт до расчёта метрик |
| Неверные метки с высоким confidence | Неоднозначные категории, противоречивые названия вариантов, недостающий контекст состояния или запросы вне заданной области |
| Хороший общий результат, слабая языковая подгруппа | Отдельную разметку и валидацию языка; не считайте, что результаты английского автоматически переносятся |
| Очень низкий охват | Детализацию вопроса, неполный контекст и реальную неопределённость; не снижайте порог без измерения новых ошибок |
| Маршрутизация верна, но задача не выполнена | Выполнение обработчика, аргументы, ошибки инструментов и результат резервного пути |
| Результаты изменились после обновления | Версию модели в ответе, хеш вопроса, предобработку, набор вариантов и состав трафика |
Об интерпретации опубликованных результатов читайте в статье что могут подтвердить бенчмарки Jev. Она объясняет, почему калибровка на бенчмарке не подтверждает конкретный порог вашей рабочей системы.
Привяжите порог к версии
Фиксируйте оценённую версию модели, когда нужна воспроизводимость, и записывайте версию, указанную в ответе. Повторяйте оценку при изменении вопроса, добавлении варианта, переводе состояния, изменении предобработки или переходе на другую версию модели. Даже неизменный порог может стать другим правилом, если меняются его входные данные.
Начните с теневых решений, затем переходите к ограниченному обратимому запуску с явно назначенным ответственным за откат. Отслеживайте ошибки среди принятых решений по новым размеченным выборкам, общий охват, нагрузку на резервный путь и результаты полных задач. Сохраняйте предыдущее правило, чтобы вернуться к нему без восстановления эксперимента по частям.
Наконец, подставьте измеренный охват в калькулятор стоимости маршрутизации. Порог полезен, когда он соблюдает правило качества задачи и сохраняет работоспособность приложения, а не когда выглядит внушительной десятичной дробью.
Часто задаваемые вопросы
- Означает ли confidence 0,9 в Jev, что ответ верен на 90%?
- Нет. Confidence API обобщает распределение ответов. Правильность нужно измерять по независимой разметке для вашего вопроса, состава данных и версии модели.
- Вызывает ли приложенный скрипт Jev и требует ли оплаты?
- Нет. Он читает локальный CSV с помощью стандартной библиотеки Python. Приложенные тестовые данные составлены вручную и не являются ответами Jev.